물리 환경에서 일하는 모델은 장면을 설명하는 것만으로 충분하지 않다.
무엇을 할지 정하고, 손이 어떻게 움직여야 하는지 표현하며, 그 뒤 장면이 어떻게 변할지 예상해야 한다.
PhysBrain 1.5는 이 세 종류의 출력을 별도 모델로 분리하지 않고 같은 자기회귀 모델에서 학습하는 공개 모델이다.[2]
2026년 9월 14일 공개된 PhysBrain 1.5: From Vision-Language Models to Physical Foundation Models는 DeepCybo Team 명의의 기술 보고서다.[1][2]
기여자는 부록에서 성 기준 알파벳순으로 제시되며, 개인별 기관 대응은 표시되지 않는다.
따라서 저자 순서나 모델 카드의 기관 로고를 근거로 개별 소속을 추정하지 않는다.[2][6]
가장 중요한 구분은 물리적 상호작용을 위한 공통 학습 구조와 실제 로봇 폐루프 수행의 검증이다.[2]
논문의 72.5점은 28개 이해·공간·계획 벤치마크의 평균이다.[2]
동작 생성과 미래 예측은 별도로 제시되지만, 해당 점수가 로봇 작업 성공률을 의미하지는 않는다.[2]
무엇을 해결하려는가
관찰, 계획, 동작, 상태 변화는 서로 연결되지만 출력 형태는 다르다.[2]
언어 답변은 텍스트, 손목 동작은 시간에 따른 위치·자세, 미래 장면은 조밀한 영상 정보다.[2]
PhysBrain 1.5는 이들을 모두 이산 토큰으로 표현해 하나의 다음 토큰 예측 목적함수로 학습한다.[2]
기반은 Qwen3-VL-Instruct이며, 언어 어휘에 동작 토큰과 시각 상태 토큰을 추가한다.[2][6]
출력은 같은 백본·토큰 임베딩·LM 출력 헤드를 공유하고, 작업별 형식과 손실 마스크가 어떤 토큰을 감독할지 정한다.[2]
다만 “작업별 헤드가 없다”는 설명은 토큰을 실제 궤적·영상으로 복원하는 외부 디코더까지 없다는 뜻이 아니다.[2]
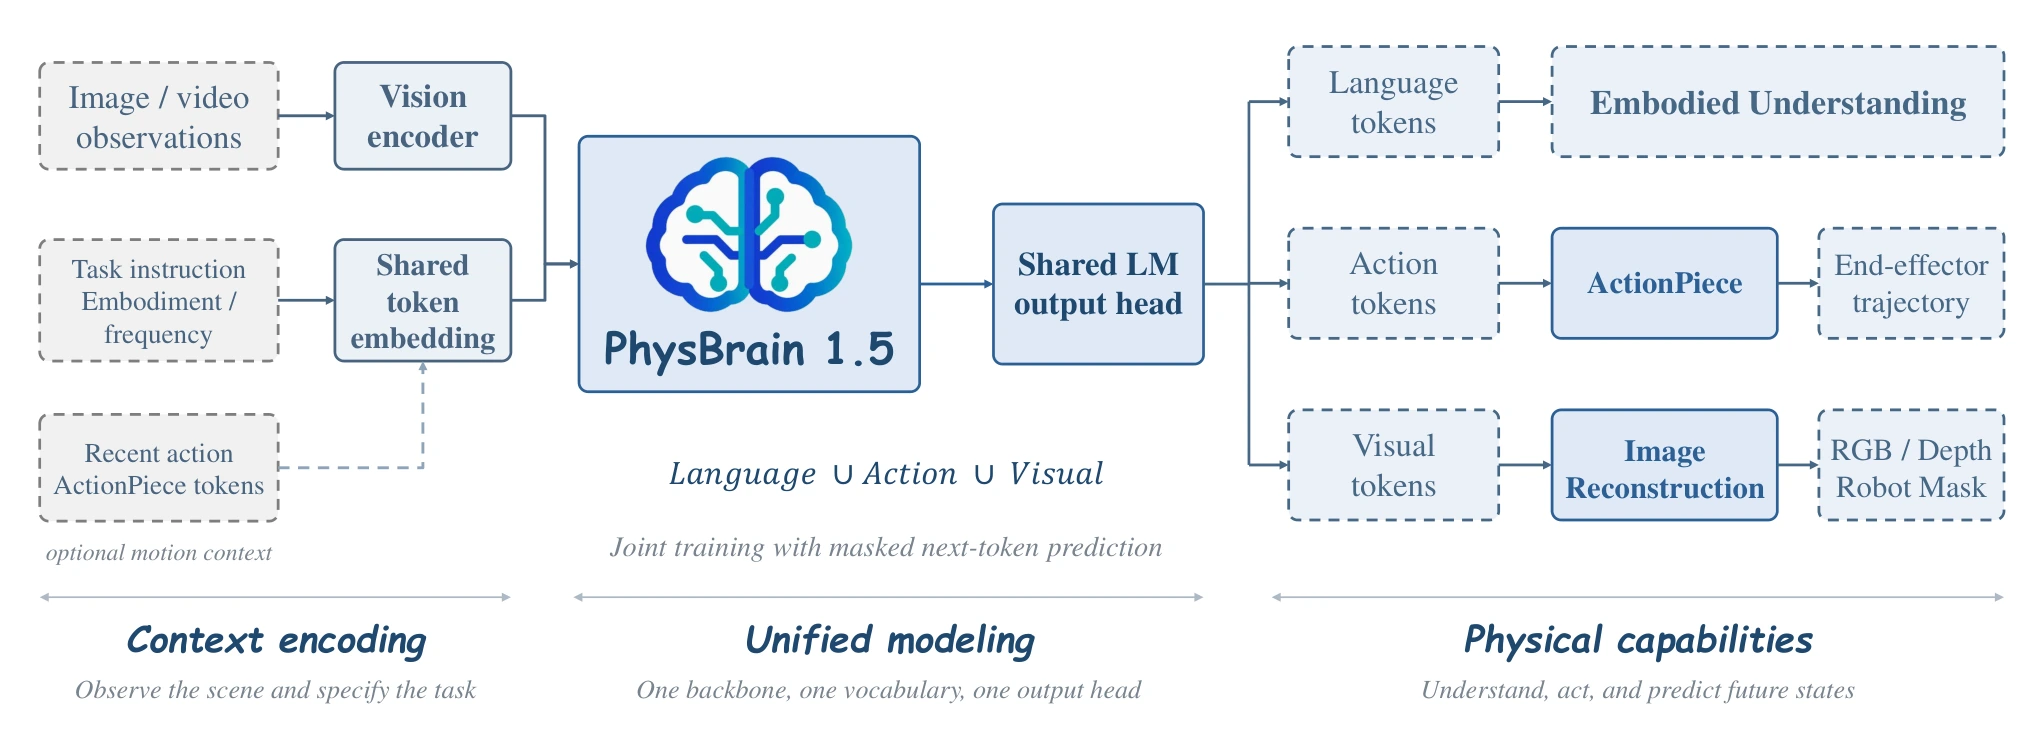
논문 그림 2.
동작 토큰은 ActionPiece, 시각 토큰은 영상 복원 디코더를 통해 해석된다.
원본 영문 표기는 유지했다.
모바일에서는 좌우로 밀거나 눌러 확대할 수 있다.[2]
동작과 미래 상태를 어떻게 토큰화하는가
손목 궤적: 같은 어휘, 서로 다른 로봇 좌표계
동작 목표는 현재 관찰을 기준으로 다음 16개 시점의 손목 궤적이다.[2]
한 시점의 표현은 상대 이동 3차원, 상대 회전의 연속 6차원 표현, 절대 그리퍼 닫힘 정도를 합친 10차원이다.[2]
각 목표는 같은 현재 자세를 기준으로 하며, 이전 목표를 누적하는 방식은 아니다.[2]
ActionPiece는 한 손목의 16단계 궤적을 32개의 이산 토큰으로 표현하고, 좌우 손목은 같은 512토큰 어휘와 코드북을 사용한다.[2]
인간 영상에서 복원한 손목 움직임에도 같은 표현을 적용하지만 손가락 동작은 제외한다.[2]
이 공통 표현은 모든 로봇 좌표계를 하나로 정렬했다는 뜻은 아니다.[2]
논문은 자료원별 원래 축을 유지하고, 최근 동작 이력·현재 관찰·로봇 종류·동작 빈도를 조건으로 다음 궤적을 이어가도록 한다.[2]
따라서 실제 제어에 연결할 때는 토큰 복원뿐 아니라 해당 로봇의 좌표·주기·제어 관례를 확인해야 한다.[2]
미래 상태: 같은 위치의 RGB·깊이·마스크를 나란히 생성
미래 상태는 같은 시점과 영상 좌표계를 공유하는 RGB 영상, 깊이 지도, 로봇 마스크다.[2]
세 모달리티는 공통 VQ-VAE로 128×128 해상도에서 토큰화하며, 각 출력은 16×16 코드 격자다.[2]
한 위치의 RGB·깊이·마스크 코드를 순서대로 교차 배치한 payload는 VQ 토큰 768개와 경계 토큰 두 개, 총 770개다.[2]
생성한 코드는 모달리티별 격자로 분리한 뒤 같은 고정 VQ 디코더로 복원한다.[2]
이 설계는 미래 영상의 외형·기하·로봇 점유 영역을 같은 언어 모델 출력 흐름에서 예측하게 한다.[2]
그러나 낮은 해상도의 가능한 상태를 생성하는 것과 정밀한 물리 시뮬레이션·충돌 검증은 구별해야 한다.[2]
학습 데이터: 인간 경험에서 시작하되 로봇 데이터도 사용한다
물리 인지 사전학습의 체화 감독은 인간 상호작용 영상에서 구축했다.[2]
약 30,000시간의 정제 영상으로부터 지각·질의응답 24.3M, 인간 동작 31.2M, 미래 상태 26.8M 샘플을 만들었으며, 일반 언어·시각언어 지시 데이터 14.9M도 함께 사용했다.[2]
“인간 영상만 사용”은 물리 감독의 출처에 관한 설명이지 전체 학습 데이터가 영상뿐이라는 뜻은 아니다.[2]
후속 SFT는 인간 시연, 실제 로봇 궤적, 시뮬레이션을 섞는다.[2]
이해 6.61M, 동작 5.4M, 미래 상태 1.2M, 일반 지시 데이터 1M 샘플이 보고돼 있다.[2]
로봇·시뮬레이션 자료는 약 2,620시간이며 고품질 인간 동작 약 500시간도 추가한다.[2]
두 단계는 모두 이해·동작·미래 상태를 공동 학습하고 단계별로 한 epoch를 수행한다.[2]
학습 최대 길이는 32,768토큰이다.[2]
공개 config의 최대 위치 길이 262,144와는 다른 정보이므로, config 값만으로 262K 길이에서의 학습·품질 검증을 주장해서는 안 된다.[2][7]
72.5점이 보여주는 것과 보여주지 않는 것
보고서의 28개 벤치마크는 시각·공간 지각, 다중 시점 이해, 체화 추론·계획, grounding·affordance, 영상 궤적 추론의 다섯 영역을 평가한다.[2]
프로젝트 페이지는 Overall을 28개 점수의 비가중 평균이라고 명시한다.[3]
다른 지표를 0–100으로 표현해 평균한 값이므로 전체 로봇 작업의 72.5% 성공률로 읽으면 안 된다.[2][3]
8B의 평균은 72.5로, 같은 보고서에서 재평가한 Qwen3-VL-Instruct 8B의 59.5와 Hy-Embodied-VLM-1.0의 66.0보다 높다.[2]
프로젝트 페이지의 2B는 평균 66.6이며 순위 집계에서는 제외된다.[3]
폐쇄형 모델도 보고서의 순위 집계에서는 참고값으로만 제시한다.[2][3]
평균 아래의 강약은 함께 봐야 한다.
다음은 같은 표 안의 점수이며 모델 간 입력·지표는 연구진의 재평가 프로토콜을 따랐다.[2]
- MindCube: Qwen3-VL 33.9 → PhysBrain 8B 86.2. 다만 ACE-Brain-0.5는 94.2로 더 높다.[2]
- EgoPlan-Bench2: Qwen3-VL 32.1 → PhysBrain 62.1.[2]
- MMSI-Bench: Qwen3-VL 30.8 → PhysBrain 41.0. 다중 이미지 공간 추론에는 여전히 상당한 오류가 남는다.[2]
- RefSpatial-Bench: Qwen3-VL 43.6 → PhysBrain 50.9, RynnBrain1.1은 63.2다.[2]
일반 멀티모달 능력도 일괄 개선은 아니다.[2]
ChartQA는 84.96에서 86.24로, V*는 83.77에서 87.96으로 높아졌지만, DocVQA는 95.66에서 94.43으로, MVBench는 68.53에서 66.07로 낮아졌다.[2]
“범용 능력을 대체로 유지하면서 물리 이해를 강화했다”가 더 정확한 요약이다.[2]
다른 논문의 점수와 그대로 비교할 수 없는 이유
연구진은 비교 모델을 공통 지표로 다시 평가했다.[2]
특히 열 개 pointing·grounding 벤치마크는 예측 유효성과 목표 영역 커버리지를 함께 반영하는 micro-F1을 사용한다.[2][10]
RoboRefit은 경계 상자 대신 교정한 객체 마스크를 사용하고, 궤적 추론 두 과제는 100 − NRMSE를 보고한다.[2]
시각 입력도 설정에 영향을 받는다.[2]
RoboVQA는 기존 평가 도구의 8프레임 대신 공식 자료의 16프레임을 사용하고, MindCube는 TinyBench의 raw-QA 설정을 사용했다.[2]
모델별 권장 프롬프트·thinking 설정을 따르므로 모든 모델이 같은 내부 계산량으로 비교된 것도 아니다.[2]
따라서 공개 표는 해당 재평가의 근거이지, 각 원논문의 리더보드 숫자와 무조건 호환되는 결과는 아니다.[2]
동작 생성: 실제 실행이 아니라 이력 조건부 예측
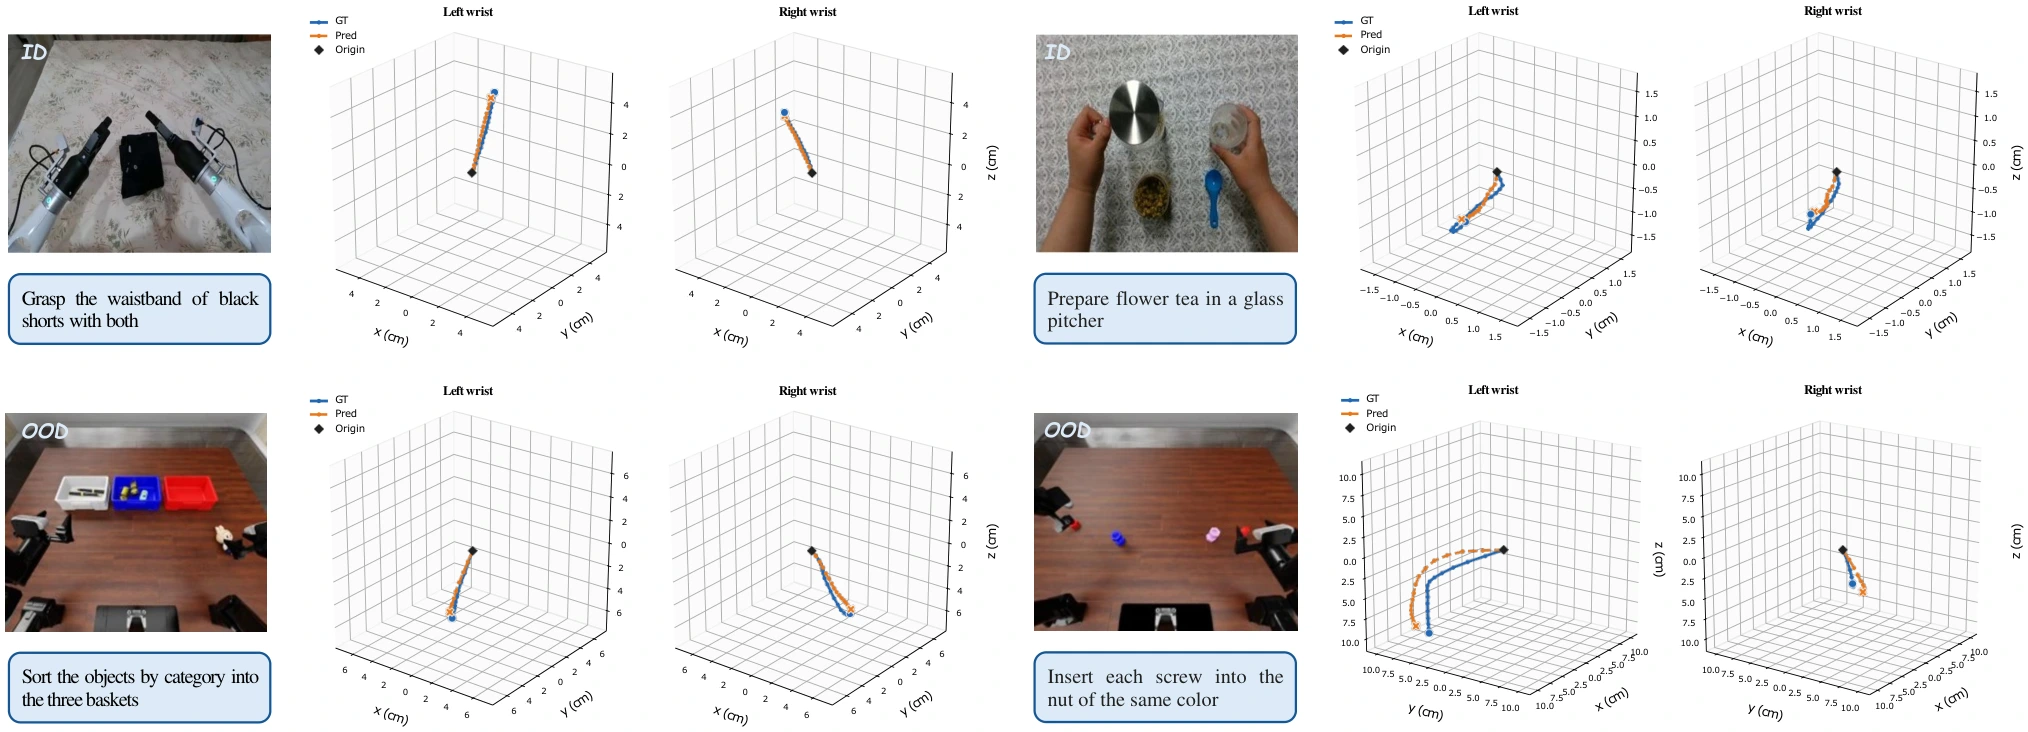
논문 그림 5.
파란색은 기준 궤적, 주황색은 예측이다.
RoboDojo는 학습에서 제외됐지만 입력에는 정답 동작 이력이 들어간다.
실제 로봇 실행 영상이나 작업 성공률이 아니다.
모바일에서는 확대해 축과 오차를 확인할 수 있다.[2]
동작 실험은 현재 영상·지시·이전 16단계의 정답 동작 chunk를 주고 다음 16단계를 예측한다.[2]
ID와 학습에서 제외한 RoboDojo의 OOD 장면에서 큰 움직임의 방향을 따라가지만 위치 편차도 보인다.[2]
논문은 이 결과를 관찰된 이력에 조건화한 오프라인 궤적 예측이라고 명확히 구분하며, 폐루프 실행이나 전체 작업 성공을 보고하지 않는다.[2]
정량 근거로는 사전학습 중 동작 토큰 perplexity가 ID에서 17.12 → 5.07, RoboDojo에서 12.39 → 6.57로 낮아진다.[2]
이 역시 정답 동작 토큰을 더 잘 예측했다는 신호이지, 물체를 집거나 나사를 삽입하는 실제 성공률은 아니다.[2]
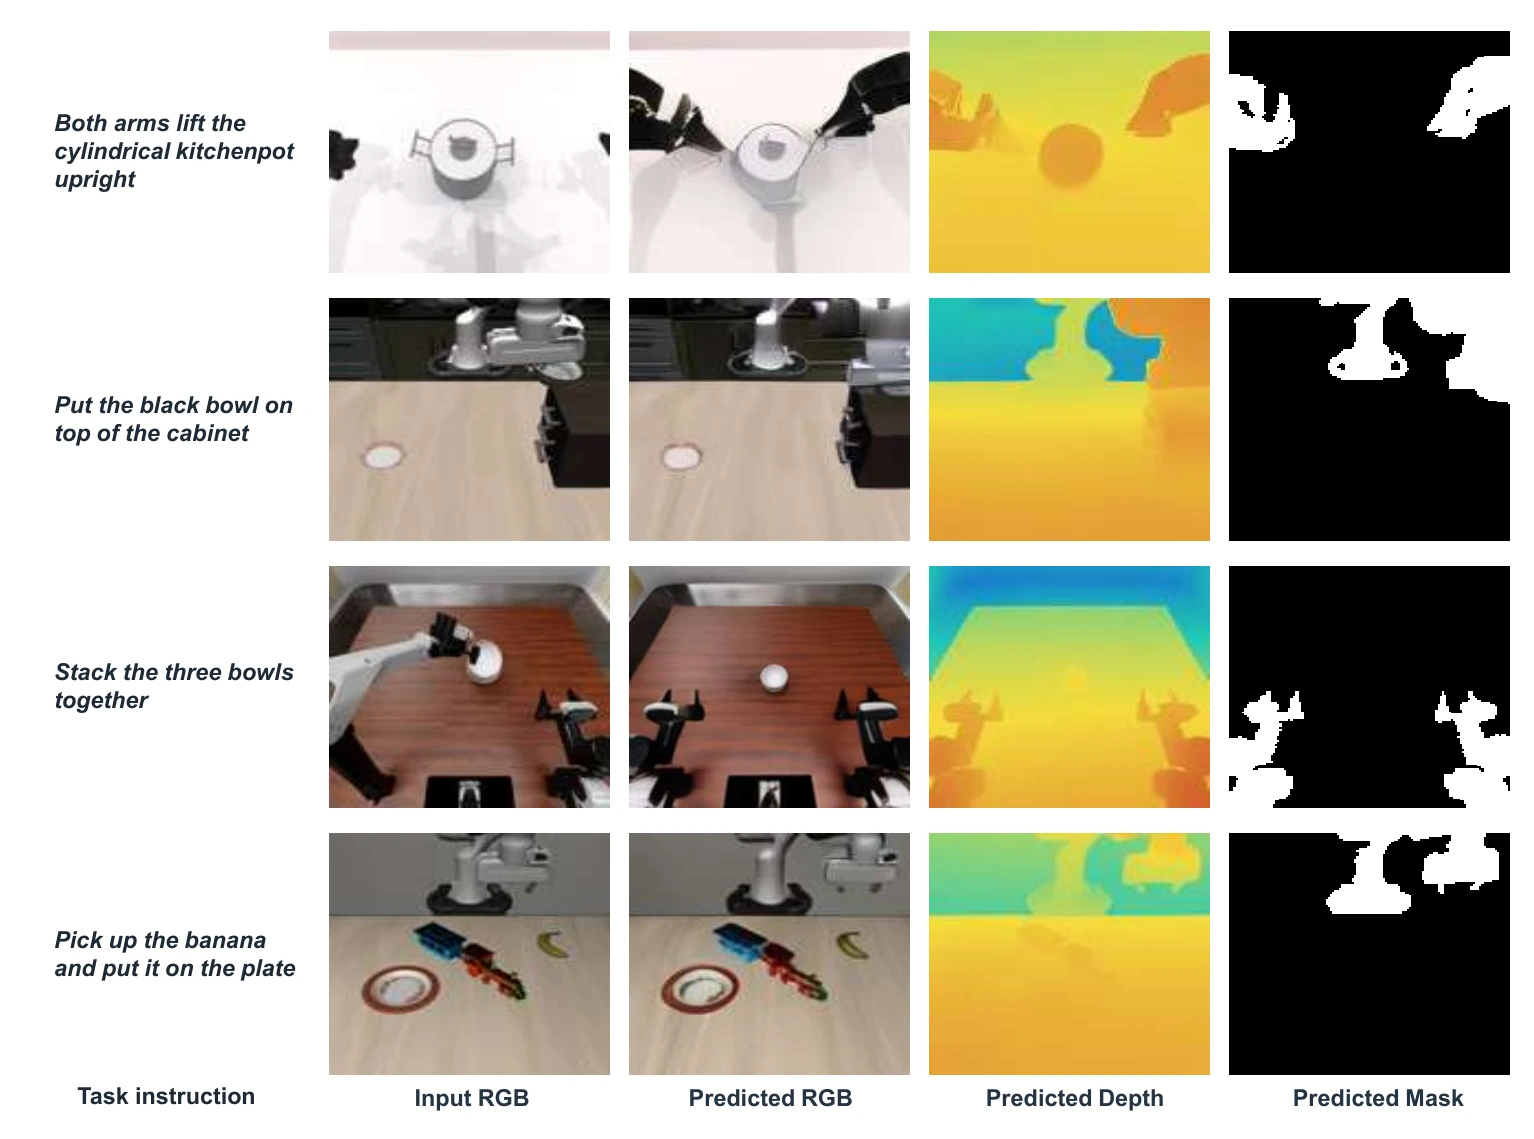
논문 그림 6.
입력 RGB 다음에 예측 RGB·깊이·로봇 마스크가 이어진다.
1초 예측 시점의 정성 사례이며, 정확한 물리 전이나 안전한 제어를 보증하는 시험은 아니다.[2]
미래 상태 예측도 다양한 로봇에서 장면 구조와 작업에 맞는 변화를 표현하는 정성 사례가 중심이다.[2]
보고서의 이해 벤치마크 평균과 동작·미래 예측의 증거 수준을 한 덩어리의 성능으로 합치지 않는 것이 중요하다.[2]
공개 모델과 재현 경로
Hugging Face에는 8B와 2B의 공개·비게이트 체크포인트가 있다.[4][8][9]
API safetensors 메타데이터의 실제 수는 각각 BF16 8,903,438,576개와 2,161,610,752개다.[8][9]
8B라는 이름은 기반 모델 계열의 명칭이며 확장된 어휘 등을 포함한 실제 배포 파라미터와 구분해야 한다.[7][8]
8B config는 Qwen3VLForConditionalGeneration과 어휘 크기 168,576을 사용한다.[7]
공개 파일 목록은 가중치·processor·tokenizer 중심이며, 별도 ActionPiece와 VQ 복원 디코더 파일은 이 모델 저장소에서 확인되지 않았다.[8]
따라서 표준 VLM 로딩 경로가 있다는 사실만으로 모든 물리 출력의 복원·로봇 연결까지 즉시 재현된다고 단정하지 않는다.[2][8]
PhysBrainEvalKit은 모델 배포와 다른 산출물이다.[5]
28개 벤치마크 어댑터, Hugging Face 추론 경로, point 평가 규약, 모델을 메모리에 유지하는 분할 실행기와 원시 예측·집계 저장 경로를 제공한다.[5]
기본은 탐욕적 디코딩이고 MMSI-Bench는 별도의 샘플링 예외이며, FlashAttention 구현 차이에 따른 결과 변동도 README가 경고한다.[5]
이 평가 저장소는 학습 코드나 로봇 제어기가 아니다.[5]
또한 조회 시점 모델 카드에는 명시적 license 필드가 없고 가중치 저장소에 LICENSE 파일도 없으며, EvalKit에서도 라이선스 파일을 확인하지 못했다.[5][8][9]
공개 다운로드와 이용 허락은 다른 문제이므로 상용 사용·재배포는 배포자 확인이 필요하다.
이 글은 공식 자료와 배포 구성을 검토했으며 GPU에서 모델을 실행하거나 점수를 독립 재현하지 않았다.
실무 관점에서의 해석
PhysBrain 1.5의 기여는 물리 세계의 여러 감독 신호를 공통 토큰 학습으로 연결하고, 공간 이해 평가를 비교적 넓게 제시한 데 있다.[2]
인간 영상에서 지각·동작·미래 상태를 함께 구축하는 방식은 로봇 데이터만으로는 얻기 어려운 경험의 범위를 넓히려는 접근이다.[2]
하지만 통합 구조가 곧 안전한 범용 제어기는 아니다.
업무에 도입하려면 실제 환경의 이해 정확도와 함께 좌표 복원, 제어 주기, 이력 의존성, 폐루프 오차 누적, 안전 제약을 각각 검증해야 한다.
현재 공개 근거로는 강한 물리 이해 모델에 동작·미래 상태 생성의 공통 인터페이스를 더한 연구 모델로 평가하는 것이 적절하다.[2][5]