컵을 집으려면 먼저 어떤 컵인지, 어디에 있는지 알아야 한다.[2]
GroundingPI가 겨냥하는 병목은 복잡한 행동 계획보다 앞선 정밀한 시각적 위치 지정이다.[2]
범용 시각언어 모델이나 영상 생성 모델을 로봇 정책의 백본으로 쓰더라도, 작은 물체와 밀집 장면에서 필요한 공간 정보가 충분히 준비되어 있지는 않다는 문제의식에서 출발한다.[2]
2026년 9월 30일 공개된 논문 GroundingPI: A Grounding Foundation Model towards Physical Intelligence with Visual Primitives는 Qize Yu, Lianrui Fan, Boyu Chen 등 연구진의 작업이다.[2]
공식 HTML에는 XPeng, Peking University, The University of Hong Kong, UC Berkeley, Princeton University, National University of Singapore, Tsinghua University, HKUST (GZ)가 기관 목록으로 표시된다.[2]
저자별 대응이 명확히 렌더링되지 않아 개인 소속을 임의로 연결하지 않는다.[1][2]
핵심은 “그라운딩 모델이 로봇을 바로 움직인다”가 아니다.
어디에 상호작용해야 하는지를 사전학습하고, 이후 별도의 행동 학습으로 어떻게 움직일지를 배운다는 접근이다.
논문은 위치 평가뿐 아니라 같은 행동 전문가에 서로 다른 백본을 연결한 전이 실험으로 이 가설을 검토한다.[2][3]
점과 박스를 같은 언어로 생성한다
GroundingPI는 MoonViT-V2 시각 인코더와 Qwen3-4B 언어 디코더를 연결한 자기회귀 모델이다.
인접한 2×2 시각 특징을 합친 뒤 MLP projector를 통해 언어 임베딩 공간으로 옮긴다.
이름과 논문 요약의 “4B”는 언어 백본 계열을 가리키며, 부록과 공개 가중치 메타데이터의 전체 모델 규모는 약 4.844B 파라미터다.[2][9]
출력 어휘에는 <0>부터 <999>까지 1,000개 좌표 토큰이 추가된다.[2]
의미 라벨, 구조를 구분하는 마커, 점·박스 좌표를 같은 출력 헤드에서 예측하므로, 별도의 고정 클래스 탐지 헤드 대신 질의에 따라 길이가 달라지는 구조화된 응답을 만든다.[2]
요청한 범주가 없을 때는 None을 출력하는 규약도 포함한다.[2]
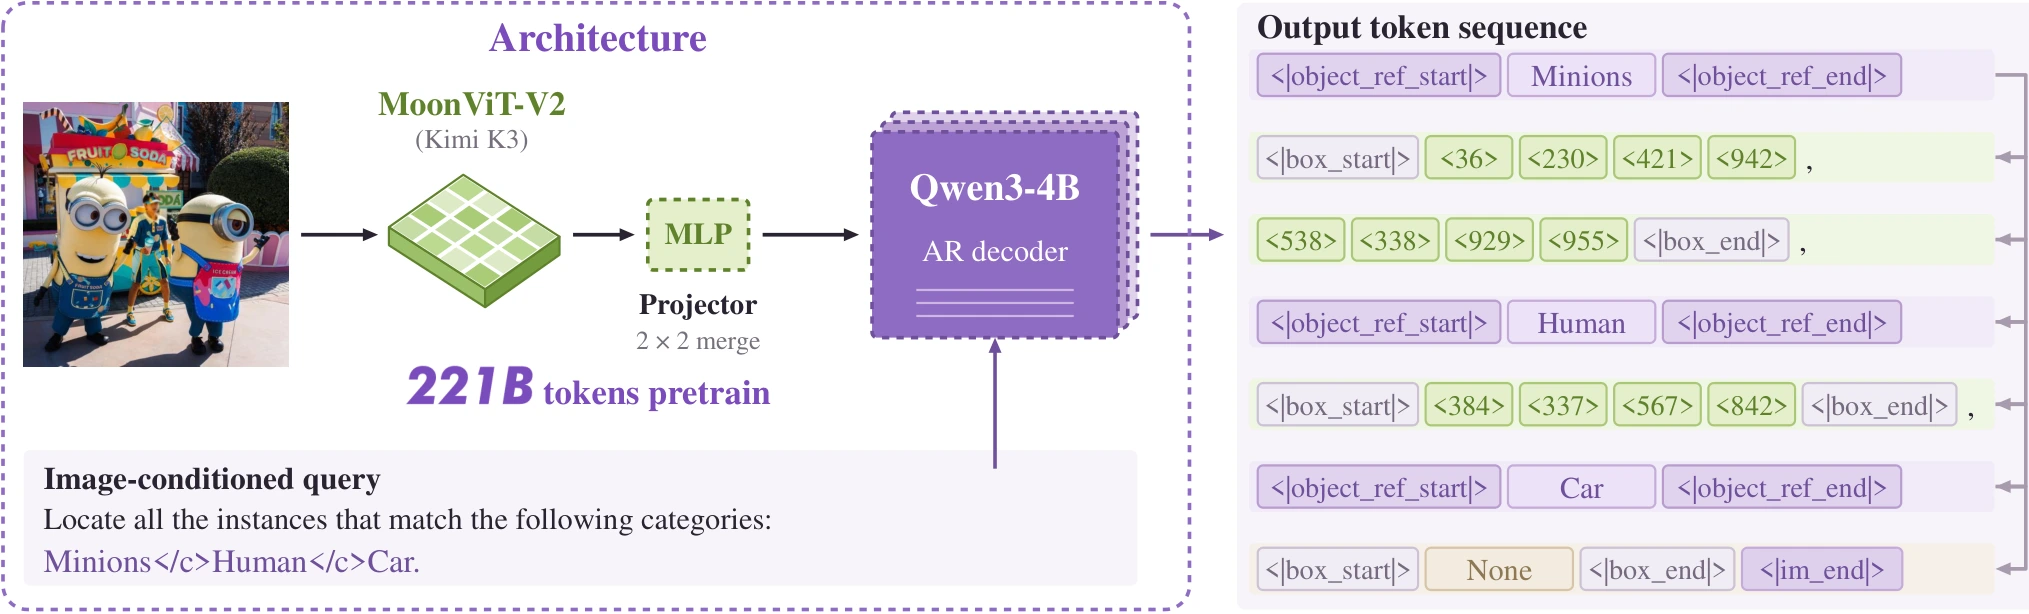
논문 그림 1.
좌표를 여러 숫자 문자로 풀어 쓰지 않고 원자적인 토큰으로 생성한다.
원본 영문 표기는 유지했다.
모바일에서는 좌우로 밀거나 눌러 확대할 수 있다.[2]
같은 인터페이스는 여러 지각 작업을 포괄한다.
범주별 박스, 자연어로 지칭한 물체의 점, OCR의 텍스트와 영역, 문서 레이아웃, 클릭할 GUI 위치를 출력하며, 예시 박스를 입력하는 시각 프롬프트도 지원한다.
다만 GUI의 점을 반환하는 것과 실제 화면을 조작하는 것은 별개의 기능이다.[5][6]
| 입력 질의의 목적 | 구조화된 출력 |
|---|---|
| 물체·지칭 대상 찾기 | 라벨과 박스 또는 점 |
| 글자·문서 읽기 | 텍스트와 영역, 레이아웃 |
| GUI 대상 지정 | 클릭할 위치의 점 |
| 예시와 유사한 대상 찾기 | 대응하는 물체의 박스 |
위 표는 공식 작업 규약을 요약한 것이다.
좌표는 이미지 크기에 대한 정규화 값이므로, 실제 픽셀이나 로봇 좌표계로 바꾸는 처리는 응용 시스템이 담당해야 한다.[2][5]
학습: 정답 토큰을 넘어 누락과 중복까지 평가한다
학습은 일반 시각언어 기반 학습, 좌표 정렬을 위한 SFT, GRPO 강화 후학습으로 구성된다.[2]
일반 학습은 projector 정렬에서 시작해 전체 모듈의 다중모달 학습으로 이어지며, 공간 특화 SFT는 라벨·좌표·프로토콜 토큰에 같은 다음 토큰 예측 손실을 적용한다.[2]
박스 IoU 회귀 손실을 별도로 추가하는 구조는 아니다.[2]
데이터 엔진은 여러 teacher의 결과를 의미와 기하 필드별로 결합하고, 작업마다 필요한 검증을 수행한다.[2]
모든 대상을 찾는 질의에는 영역 내 누락 여부를 확인하는 coverage 검증이 필요하며, 빈 예측만으로 “대상이 없다”고 확정하지 않는다.[2]
여러 teacher가 동의하더라도 주석 정확성이 보장되는 것은 아니라는 점도 부록에서 명시한다.[2]
GRPO는 이미지·질의당 응답 8개를 생성해 완성된 출력의 품질을 비교한다.[2]
그라운딩에서는 대상 집합의 포괄성과 엄격한 위치·형식·개수·순서 품질을 함께 평가하고, 중복되거나 지나치게 큰 박스를 제어한다.[2]
OCR은 텍스트와 기하를 함께 평가하므로, 정답 문자열만 읽고 엉뚱한 영역에 붙이는 출력도 좋은 결과로 취급하지 않는다.[2]
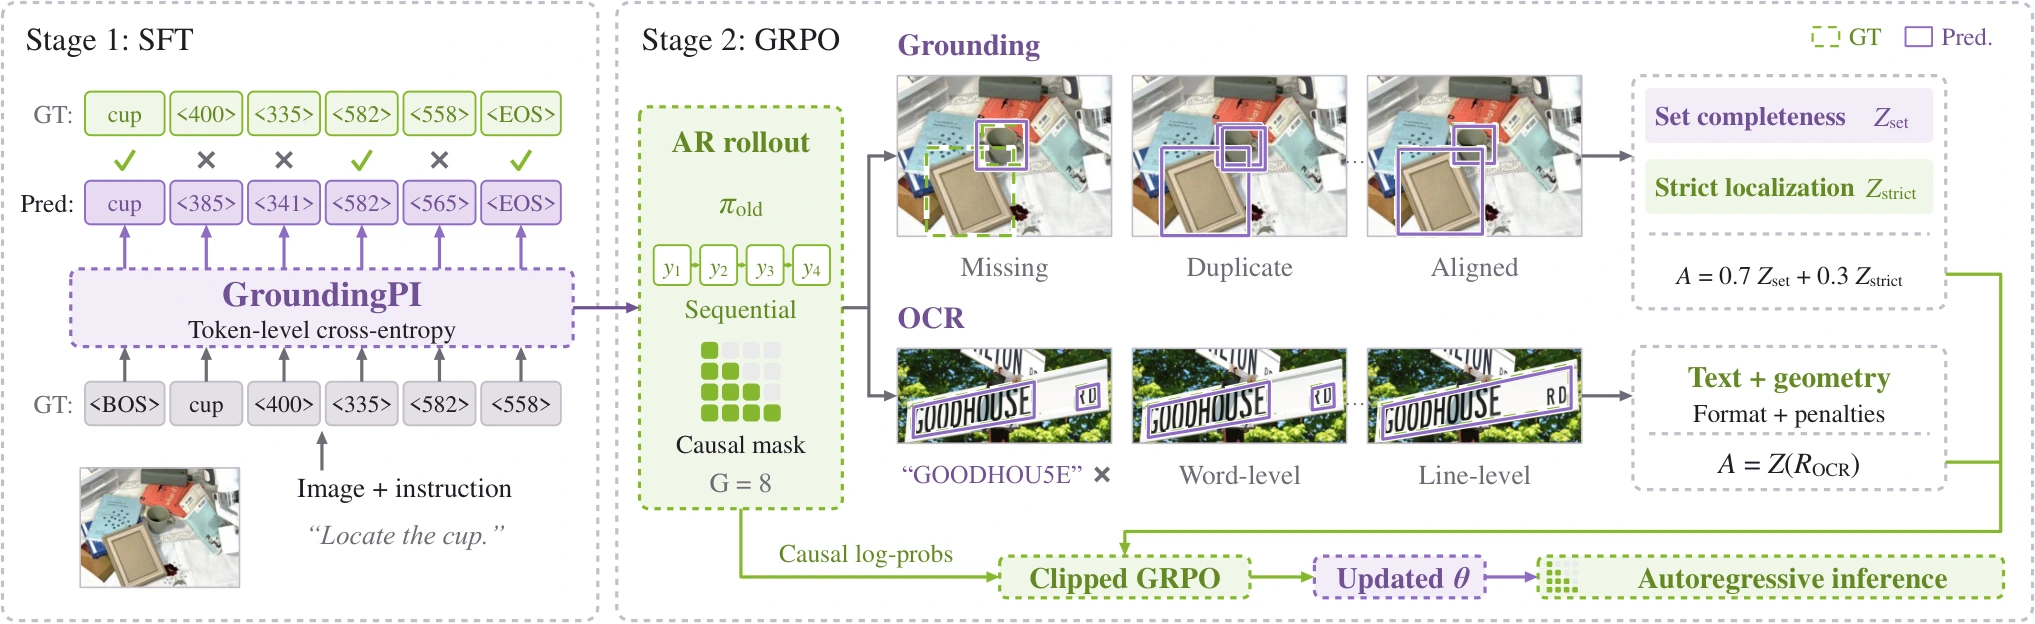
논문 그림 3.
SFT의 정답 토큰 학습과 GRPO의 완성된 출력 평가를 구분한다.
후학습에서는 시각 인코더와 projector를 고정하고 언어 측 파라미터를 업데이트한다.
모바일에서는 좌우로 밀거나 눌러 확대할 수 있다.[2]
지각 평가: 평균 우위와 작업별 우위는 다르다
논문은 11개 지각 능력에 걸친 34개 벤치마크에서 44개 baseline과 비교한다.[2]
보고된 평균은 GroundingPI 73.68%, GPT-6 Astra 71.54%다.[2]
이는 논문의 평가 묶음에 대한 집계값이지, 일반적인 지능이나 실제 로봇 작업 성공률을 나타내는 숫자가 아니다.[2]
선택한 비교를 보면 강점과 예외가 함께 드러난다.[2]
아래 탐지 수치는 논문의 F1mIoU, 점 지정 수치는 F1@Point이며 서로 같은 지표로 합쳐 읽으면 안 된다.[2]
- Dense200 박스 탐지: GroundingPI 74.53, GPT-6 Astra 65.04, Qwen3-VL-4B 14.02. 밀집 장면에서 큰 차이가 보고된다.[2]
- HumanRef 점 지정: GroundingPI 88.79, GPT-6 Astra 83.83. 언어로 지칭한 대상을 위치로 연결하는 능력을 평가한다.[2]
- Dense200 점 지정: GroundingPI 81.27, GPT-6 Astra 86.57. 평균이 높다고 모든 세부 작업에서도 가장 높은 것은 아니다.[2]
GroundingPI 결과는 5개 seed에서 각각 두 번, 총 10회 실행의 평균이다.[2]
비용 때문에 저자가 직접 평가한 일부 baseline은 3개 seed에서 한 번씩 평가하며, 외부 보고값·미지원 인터페이스·prompt와 parser 불확실성이 있는 값도 별도로 표시한다.[2]
따라서 표의 모든 행을 동일한 학습·호출·출력 조건의 독립 재현 결과처럼 취급하지 않아야 한다.[2]
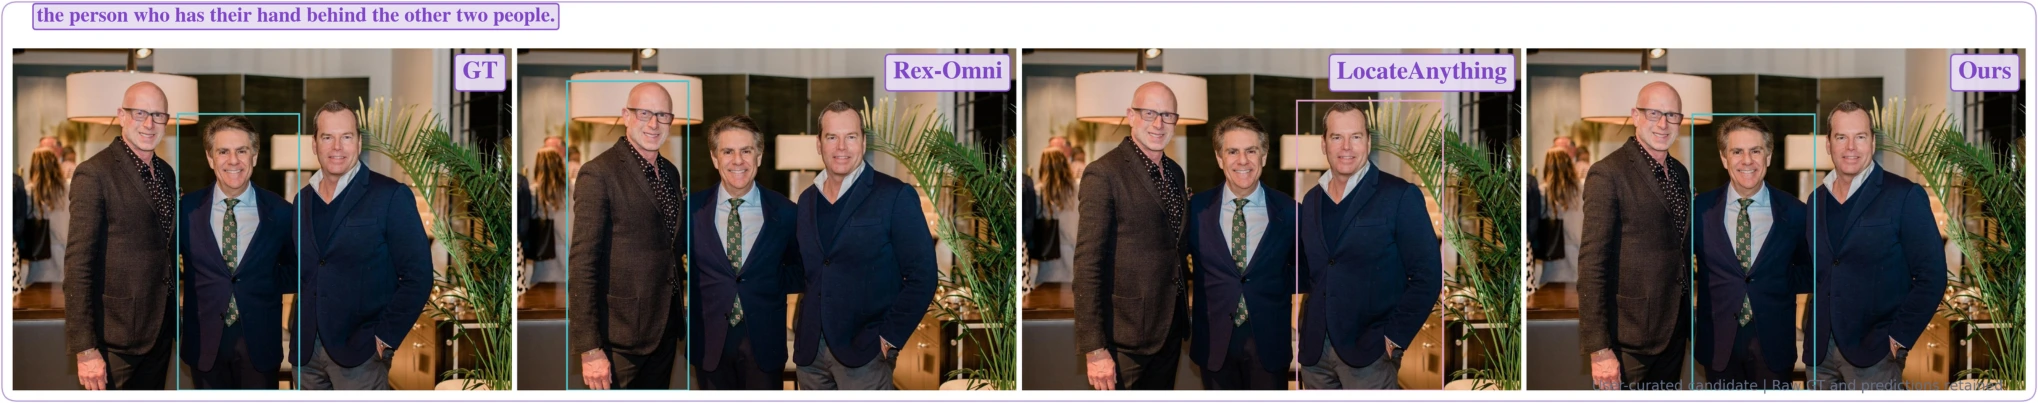
논문 그림 14.
“다른 두 사람 뒤로 손을 둔 사람”이라는 관계를 통해 가운데 인물을 지칭하는 선택 사례다.
선별된 예시는 관계 해석을 설명하지만 평균 성능이나 실패 빈도를 증명하지는 않는다.
모바일에서는 좌우로 밀거나 눌러 확대할 수 있다.[2]
행동 전이: 백본만 바꾸는 비교가 핵심이다
로봇 실험에서는 각 벤치마크 안에서 Action DiT 구조, 행동 학습 데이터, 학습 예산, 행동 표현과 추론 절차를 고정하고 사전학습 백본을 바꾼다.[2]
백본의 중간 특징을 투영·재표본화해 행동 전문가의 cross-attention에 넣고, flow matching으로 연속 행동 chunk를 생성한다.[2]
박스 좌표를 그대로 관절 명령으로 사용하는 방식은 아니다.[2]
비교 대상은 Qwen3-VL·PaliGemma 같은 VLM, Wan·Cosmos 같은 영상 모델, Rex-Omni·LocateAnything 같은 그라운딩 모델, RynnBrain 계열이다.[2]
이 설계는 공통 downstream 조건에서 어떤 표현이 행동 학습에 유리한지 보여준다.[2]
그러나 백본마다 이전 학습 데이터와 규모·계산량까지 일치시킨 실험은 아니므로, 관찰된 차이를 단일 구조 요소의 인과 효과로 확정할 수는 없다.[2]
- RoboTwin 2.0 Full: GroundingPI의 작업 성공률은 66.20%다. 50개 양손 테이블 작업의 시뮬레이션 정책 평가이며, Clean과 Randomized 데이터를 이용하는 Full 조건이다.[2]
- RoboTwin Clean2Random: Clean 시연으로 학습하고 무작위 장면에서 평가하면 17.60%로 떨어진다. 비교군 중 다음은 Rex-Omni의 14.10%로, 상대적 순위 우위와 절대 성공률의 한계를 함께 봐야 한다.[2]
- RoboCasa-GR1 Full: GroundingPI는 37.75%, RynnBrain은 39.00%다. GroundingPI가 모든 ID 조건에서 최고인 것은 아니다.[2]
- RoboCasa 데이터 효율: GroundingPI는 시연 50%로 28.75% 성공률을 기록한다. 시연 75%를 사용한 baseline 중 최고인 RynnBrain의 27.75%보다 높지만, 로봇 학습 데이터가 불필요하다는 뜻은 아니다.[2]
논문 본문의 네 OOD 조건은 RoboTwin의 Clean2Random 하나와 RoboCasa의 물체 유형·외형·컨테이너 조합 세 가지다.[2]
초록의 표현만 읽고 “RoboTwin에 네 종류의 OOD 평가가 있다”고 일반화하면 평가 범위를 잘못 전달하게 된다.[2]
이들은 시뮬레이션 폐루프 성공률이며, 실제 하드웨어에서 같은 안정성을 검증한 결과와 구별해야 한다.[2]
nuScenes의 경우 평균 오픈루프 L2 오차는 GroundingPI 0.296m, Qwen3-VL-4B 0.301m, RynnBrain 0.308m다.[2]
미래 경로를 예측해 정답 경로와 비교한 결과로, 폐루프 자율주행 안전성·충돌률이나 실시간 제어 지연을 입증하지 않는다.[2]
공식 그림의 주행 막대는 L2 자체가 아니라 역수를 표시하므로 수치 해석에도 주의가 필요하다.[2]
분석이 말하는 것과 아직 말하지 못하는 것
공간 학습 노출을 늘리는 네 설정에서 그라운딩 평균은 61.69에서 73.68로, RoboCasa OOD 집계는 26.59에서 33.38로 상승한다.[2]
다만 ID 성공률은 마지막 단계에서 38.75에서 37.75로 내려간다.[2]
이 결과는 지각과 전이의 동반 개선을 지지하지만, 모든 행동 지표가 단조롭게 좋아지는 스케일링 법칙을 입증한 것은 아니다.[2]
데이터 구성에서도 중요한 구분이 있다.[2]
밀집 그라운딩 그룹 제거는 조작과 주행에 모두 손해를 주며, OCR·레이아웃·GUI를 묶은 보조 그룹 제거는 조작 성능을 크게 낮춘다.[2]
하지만 그 보조 그룹에는 세 작업이 함께 들어 있으므로 이를 OCR만의 독립 인과 효과로 읽어서는 안 된다.[2]
저자는 문자 경계의 정밀한 식별과 텍스트–영역 정렬이 지각 학습을 촉진할 수 있다는 가설을 제시한다.[2]
보조 그룹만 사용했을 때는 전이가 약하고, 다른 감독과 함께 쓸 때 이득이 커진다는 결과는 감독 신호의 상보성을 보여준다.[2]
OCR의 구체적 촉진 메커니즘이나 특정 attention 구조가 로봇 성능을 결정한다는 해석은 후속 통제 실험이 필요한 가설이다.[2]
공개 모델: 지각 서비스와 행동 정책을 구분해야 한다
공식 프로젝트 페이지는 논문·코드·모델을 함께 연결한다.[4]
2026년 10월 14일 확인한 Hugging Face 저장소는 공개·비게이트 상태이며, 두 개의 safetensors 가중치 shard와 tokenizer·processor·사용자 정의 모델 코드가 포함되어 있다.[9]
공개 대상은 그라운딩용 자기회귀 VLM이다.[6]
공식 GitHub는 서버, 경량 HTTP client, 배치 주석과 평가 경로를 함께 제공한다.[5]
기본 서비스는 vLLM 기반의 이미지·텍스트 API이고, 문서상 BF16, 요청당 이미지 한 장, 16,384토큰 context, tensor parallel 1 및 eager execution을 사용한다.
이 서비스 설정을 시각 인코더의 입력 토큰 수나 학습 단계의 context 길이와 혼동하면 안 된다.
문서화된 지각 서비스 설정을 실제 로봇 정책의 재현 검증과 동일시할 수 없다.[5][6]
더 중요한 배포 경계는 행동 정책이다. vla/에는 StarVLA·OpenWAM 기반 백본 비교 레시피가 있지만, 공식 README는 공개 GroundingPI checkpoint에 직접 연결하는 action-policy adapter를 제공하는 것은 아니라고 명시한다.
별도의 환경·정책 checkpoint가 필요한 비교 코드와 즉시 사용 가능한 그라운딩 모델은 서로 다른 공개 범위다.[5][8]
라이선스도 저장소의 Apache-2.0 표기만으로 끝나지 않는다.
저자의 원래 기여는 Apache-2.0이지만 Kimi 유래 자료와 적용되는 파생물은 Kimi K3 License 조건을 유지하며, 전체 모델 패키지를 Apache만의 선택적 라이선스로 해석할 수 없다.
모델 배포나 재배포 전에는 실제 LICENSE와 upstream 조건을 함께 확인해야 한다.[7]
실무 관점에서의 해석
GroundingPI의 의미는 범용 추론 모델을 대체했다는 데 있지 않다.[2]
정밀한 지각을 먼저 충분히 학습하면 제한된 행동 시연이 위치 식별까지 다시 가르치는 부담을 줄일 수 있다는 증거를 제공한다.[2]
특히 밀집 물체·작은 대상·관계 지칭이 많은 환경이라면, 백본 선택에서 일반 VQA 점수뿐 아니라 이런 지각 능력을 따로 측정할 이유가 생긴다.[2]
도입 단계에서는 목표 환경의 누락·중복·좌표 오차를 검증하고, 행동 전문가와의 연결·제어 지연·실제 로봇 안전성을 별도로 확인해야 한다.
위치 지정용 공개 가중치, 시뮬레이션 정책 성공률, 오픈루프 주행 오차를 같은 수준의 제품 완성도로 묶지 않는 것이 이 논문을 활용하는 출발점이다.[2][5][6]