멀티모달 모델의 입력 비용은 모든 이미지 영역에 똑같이 발생하지만, 정보 밀도는 균일하지 않다.
작은 글자와 클릭 대상은 정밀하게 남겨야 하고, 단색 배경은 더 거친 표현으로도 충분할 수 있다.
VisionWeave는 이 차이를 모델이 학습해 공간 블록마다 표현의 밀도를 선택하도록 만든다.[2]
VisionWeave: Weaving Elastic Visual Representations as a Native Capability of MLLMs는 2026년 10월 6일 공개된 연구다.[1]
논문은 Qwen3.8-27B에서 평균 시각 토큰 43.0% 절감과 기존 모델 성능 98.9% 보존을 보고한다.[2]
하지만 평균 토큰 절감률이 모든 문서·영상에 보장되는 것은 아니며, 공개 코드만 설치하면 학습된 압축 능력이 바로 생기는 것도 아니다.[2][3]
저자 소속도 구분된다.
Yuan Feng은 University of Science and Technology of China와 Alibaba Token Hub, Qize Yang·Ruizhe Chen·Sibo Song·Zihan Liu·Yunfei Chu·Xize Cheng·Yuxuan Wang·Jin Xu는 Alibaba Token Hub 소속으로 표기된다.
Haolin He는 Alibaba Token Hub와 The Chinese University of Hong Kong, Muzhi Zhu는 Alibaba Token Hub와 Zhejiang University, Xike Xie는 University of Science and Technology of China 소속이다.[2]
무엇을 해결하려는가
입력 해상도를 낮추면 시각 토큰은 줄지만 작은 글자나 세부 구조도 함께 사라진다.[2]
토큰 가지치기는 일부 영역을 아예 제외할 수 있고, 미리 정한 절감률은 정보가 많은 문서와 단순한 장면의 차이를 반영하기 어렵다.[2]
VisionWeave는 영역을 삭제하는 대신, 각 영역을 정밀하게 표현할지 압축해서 표현할지를 선택한다.[2]
여기서 말하는 탄력적인 시각 표현은 단순한 추론 후처리가 아니다.[2]
정밀·압축 표현을 만드는 모듈과 이를 배분하는 라우터를 학습하고, 마지막에는 혼합된 시각 토큰을 소비하는 언어 모델까지 자기 증류로 적응시킨다.[2]
따라서 기존 모델에 손실 없는 압축 필터를 끼우는 방법이라기보다, 시각 표현의 밀도를 모델의 학습된 능력으로 만드는 접근이다.[2]
핵심 구조: 네 토큰을 남길지 한 토큰으로 표현할지
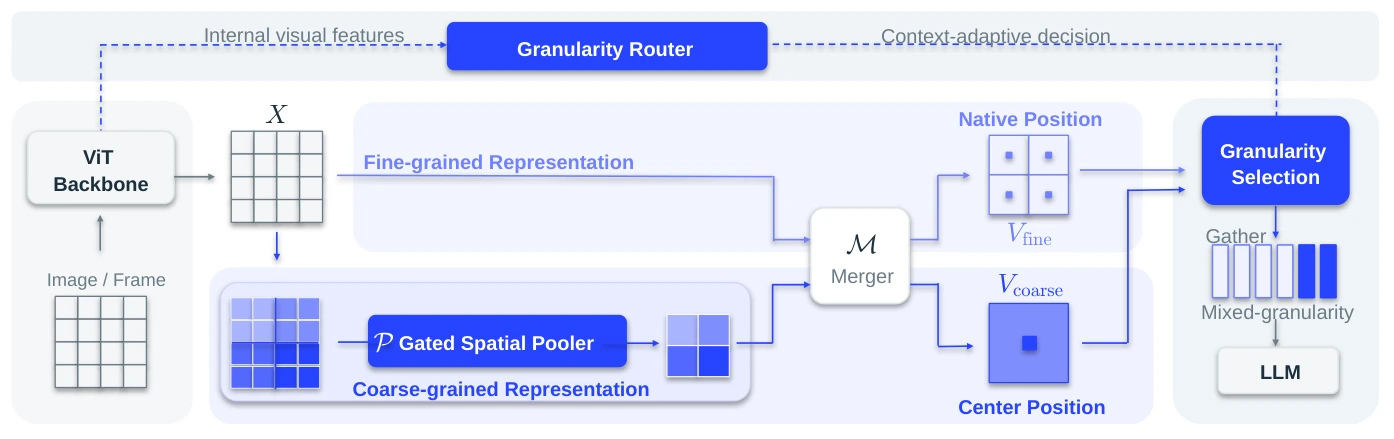
논문 그림 3.
ViT 특징에서 정밀 토큰과 압축 토큰을 만들고 공간 블록별로 선택해 LLM에 전달한다.
원본 영문 표기는 유지했다.
모바일에서는 좌우로 밀거나 눌러 확대할 수 있다.[2]
기존 시각 merger는 ViT의 2×2 패치를 하나의 정밀 토큰으로 묶는다.[2]
VisionWeave의 게이트 기반 공간 pooler는 인접 특징을 내용·채널별 가중치로 모은 뒤 같은 merger를 통과시켜 압축 표현을 만든다.[2]
그 결과 원래 4×4 패치 영역마다 네 개의 정밀 토큰 또는 한 개의 압축 토큰 중 하나를 사용할 수 있다.[2]
압축 토큰도 위치 정보를 잃지 않도록 대응하는 네 정밀 토큰의 공간 중심에 놓는다.[2]
정밀·압축 토큰은 같은 MRoPE 좌표계를 사용하며, 선택된 토큰은 원래 영상의 순서로 모인다.[2]
공간 전체를 덮는다는 뜻이지, 압축 뒤에도 모든 세부 정보가 완벽하게 보존된다는 뜻은 아니다.[2]
granularity router는 ViT의 초기·중간·최종 깊이에서 특징을 읽는다.[2]
각 깊이에서 해당 블록의 로컬 특징과 프레임 전체의 글로벌 특징을 차례로 참조해 압축 표현을 쓸 확률을 계산한다.[2]
기본 임계값은 0.5이고, 더 낮게 설정하면 압축 표현을 더 많이 선택하며 별도 재학습 없이 비용·품질 지점을 바꿀 수 있다.[2]
세 단계 자기 증류가 필요한 이유
학습은 기존 모델의 출력 분포를 교사로 사용하는 세 단계로 구성된다.[2]
정답 레이블만 흉내 내는 것이 아니라, 같은 교사 생성 응답에 조건화해 출력 분포의 차이를 줄이는 off-policy 증류다.[2]
- 압축 표현 학습: 모든 블록을 압축 토큰으로 표현하고 pooler만 학습한다. 학생의 시각 토큰은 기존의 25%이며 다른 구성요소는 고정한다.[2]
- 라우터 학습: 정밀·압축 특징을 미분 가능한 방식으로 섞어 라우터만 학습한다. 이 단계의 학생 토큰 수는 기존의 100%이며, 추론처럼 이미 토큰 수를 줄인 단계는 아니다.[2]
- 실제 선택 경로 적응: 추론 때와 같은 hard routing으로 토큰을 고르고 pooler와 LLM을 학습한다. ViT·기존 merger·라우터는 고정한다.[2]
27B 학습에는 이미지 이해, 영상 이해, GUI grounding을 합쳐 약 777K 샘플을 사용했다.[2]
학습 입력 예산은 이미지당 기존 시각 토큰 4,096개, 영상 프레임당 512개와 최대 64프레임이며, 전체 규모는 30K A100 GPU-hours 이상이다.[2]
추가 모듈이 작다는 이유로 이 연구의 학습 비용까지 작다고 읽으면 안 된다.[2]
마지막 단계는 특히 GUI에 중요했다.[2]
27B의 ScreenSpotV2 점수는 3단계 전 66.59에서 후 91.43으로 높아졌다.[2]
하지만 RealWorldQA는 낮아졌고, 나머지 작업의 개선 폭은 더 작으므로 평균 상승을 모든 작업의 같은 크기 개선으로 해석하지 않는다.[2]
성능 수치: 절감률과 품질을 함께 봐야 한다
주요 비교는 이미지·프레임당 기존 시각 토큰 512개 예산에서 수행했다.[2]
27B의 작업별 토큰 절감률은 16.5–55.1%였고, 여덟 벤치마크 평균은 43.0%였다.[2]
성능 98.9% 보존은 기존 모델 대비 작업별 상대 성능에 관한 요약이지, 모든 문제에서 정답률 98.9%를 얻었다는 뜻이 아니다.[2]
27B의 대표 작업은 다음과 같다.
점수는 논문 표 4의 작업별 지표이며 서로 같은 평가 척도로 간주하면 안 된다.[2]
- DocVQA: 기존 92.47 → VisionWeave 91.33, 시각 토큰 27.3% 절감.[2]
- InfoVQA: 기존 74.13 → 71.61, 시각 토큰 16.5% 절감.[2]
- ScreenSpotV2: 기존 94.42 → 91.43, 시각 토큰 55.1% 절감.[2]
- LongVideoBench: 기존 66.49 → 66.42, 시각 토큰 53.0% 절감.[2]
문서의 세부 정보가 많으면 더 적게 압축하고 영상에서는 더 많이 줄이는 패턴이 나타난다.[2]
반면 50% 고정 절감 목표의 FastV†와 VisionZip은 27B에서 평균 상대 성능 손실 11.82%, 12.46%를 기록했다.[2]
VisionWeave의 평균 절감률은 이들과 다르므로, 이 비교만으로 같은 비용에서의 우위를 주장해서는 안 된다.[2]
논문은 데이터셋별 절감률을 맞춘 추가 비교도 제공한다.[2]
27B의 평균 점수는 VisionWeave 76.73, FastV† 70.10, VisionZip 70.33이지만, ScreenSpotV2가 차이의 큰 부분을 차지한다.[2]
이를 제외하면 평균은 74.63 대 73.86·73.85로 차이가 줄고 일부 작업에서는 기준 방법이 더 높다.[2]
또한 FastV†는 서빙 호환성을 위해 LLM 내부가 아니라 시각 인코더 뒤에서 선택하도록 수정한 변형이므로, 원래 FastV 전체와 동일하다고 취급하지 않는다.[2]
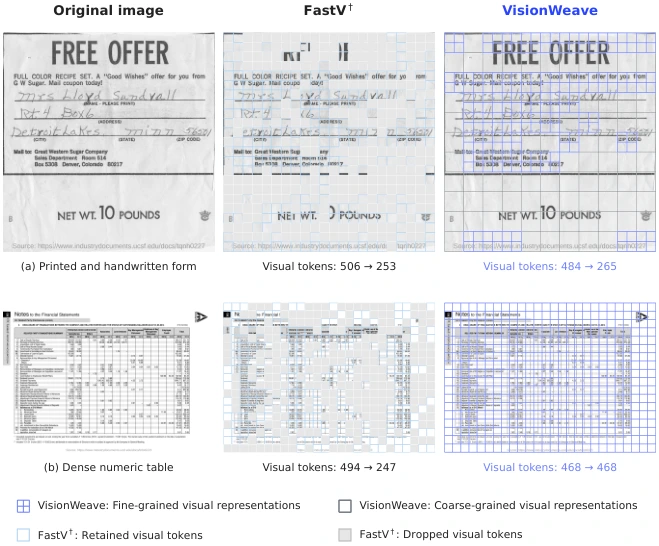
논문 그림 11.
위의 문서는 압축 표현을 섞지만, 아래의 촘촘한 숫자 표에서는 468개 토큰을 그대로 남긴다.
모든 입력을 고정 비율로 줄이지 않는다는 사례다.
원본은 659×546이며 작은 글자는 확대해서 확인할 수 있다.[2]
배분 위치 자체도 중요하다.[2]
각 입력의 압축 선택 수를 유지한 채 블록별 라우팅 점수를 섞으면, 27B 평균 점수가 76.73에서 71.37로 낮아졌다.[2]
ScreenSpotV2를 제외해도 평균 하락이 1.53점 남아, 단순히 토큰 수만 맞추는 것보다 어디에 정밀 표현을 남기는지가 중요하다는 근거가 된다.[2]
SGLang에서 실제로 빨라진 범위
서빙 실험은 Qwen3.8-27B, A100-80GB 두 장, BF16, TP=2에서의 LongVideoBench 작업이다.[2]
초당 두 프레임, 영상당 최대 256프레임, 프레임당 공간 토큰 예산 1,024개를 사용했으며 클라이언트 동시 요청은 네 개였다.[2]
이는 앞의 512토큰 품질 비교와 입력 조건이 다른 별도의 실험이다.[2]
- 처리량: 분당 0.90 → 2.07 요청, 논문 보고 기준 2.30배.[2][3]
- 평균 첫 토큰 시간: 169.90 → 77.54초, 54.4% 감소.[2][3]
- 평균 출력 토큰당 시간: 355.64 → 140.29ms, 60.6% 감소.[2][3]
이 개선은 토큰 수 감소를 넘어 SGLang 통합까지 포함한 결과다.[2]
블록 중심의 반정수 위치를 정수 RoPE 캐시로 처리하려고 위치 좌표를 두 배, 회전 주파수를 절반으로 바꾸고, 스케줄링 전에 혼합 토큰 배치를 확정하도록 메타데이터를 전달한다.[2]
동적 배칭·KV 캐시 관리·CUDA graph decoding을 유지하는 것이 통합의 핵심이며, 모든 이미지 서비스에서 같은 2.30배를 보장한 결과는 아니다.[2]
공개 상태: 실행 코드와 학습 가중치는 다르다
2026년 10월 13일 확인한 공식 저장소는 dense Qwen3.5용 이미지·영상 추론 코드와 설치·테스트 경로를 포함한다.[3]
패키지 메타데이터는 버전 0.1.0, Python 3.12 계열을 명시하지만 GitHub Releases와 태그는 없었다.[3][5]
논문의 27B 결과와 현재 배포된 추론 지원 범위를 구분해야 한다.[2][3]
가장 중요한 제한은 학습된 모델 가중치가 아직 공개되지 않았다는 점이다.[3]
README는 내부 정책과 향후 compliance 승인에 따라 공개 예정이라고 밝힌다.[3]
기존 Qwen3.5 가중치에 초기화 스크립트를 적용하면 추가 pooler·router는 미학습 상태이며 기본값은 시각 토큰 전부 유지다.[3]
따라서 초기화된 모델을 실행하는 것과 논문의 학습된 토큰 절감·품질을 재현하는 것은 다르다.[3]
라이선스도 표면값만 읽으면 혼동할 수 있다.[3][4]
GitHub API의 라이선스 필드는 비어 있지만 LICENSES/Apache-2.0.txt에는 Apache-2.0 전문과 SGLang 저작권 표기가 있고, 패키지는 해당 라이선스 파일들을 배포 메타데이터에 포함한다.[4][5]
논문은 CC BY 4.0이며 모델 가중치가 공개되면 그 배포 조건은 다시 확인해야 한다.[1][3]
이 글은 자료 검토와 게시 검증을 수행했으며 모델 실행이나 속도 수치의 독립 재현은 하지 않았다.
실무 관점에서의 해석
VisionWeave의 의미는 이미지를 무조건 더 작게 만드는 데 있지 않다.
입력을 같은 공간 범위로 유지하면서 표현 밀도를 내용에 따라 조절하는 설계가, 학습과 실제 서빙을 함께 고려할 때 유효하다는 점에 있다.[2]
도입 판단에는 세 질문이 필요하다.
실제 업무 문서에서 글자·표·클릭 대상이 보존되는지, 절감률을 맞춘 기존 방법보다 품질이 나은지, 해당 하드웨어·동시성에서 실제 지연시간이 줄어드는지를 각각 확인해야 한다.[2]
현재는 학습된 가중치 부재가 재현의 핵심 제약이므로, 바로 생산 배포할 완성 모델보다는 시각 표현의 밀도를 학습 가능한 자원 배분으로 바꾼 연구와 서빙 구현으로 읽는 편이 정확하다.[2][3]