로봇이 물체를 집을 때 필요한 정보는 “이것은 컵이다”라는 의미만이 아니다.
경계와 위치, 손목 카메라의 작은 변화처럼 정밀 제어에 필요한 신호도 남아 있어야 한다.
NEO-VLA는 행동 정책이 시각 인코더의 최종 출력만 받는 대신, 시각 계산이 진행되는 여러 깊이의 표현에 접근하게 만든다.[1][3]
2026년 11월 4일 공개된 From Pixels to Actions – Towards Native Vision-Language-Action Policies는 NTU S-Lab, SenseTime Research, Ropedia 연구진의 작업이다.[2][4]
핵심은 단순한 인코더 제거보다 행동에 필요한 시각 정보를 어디서 읽을 것인가에 있다.
논문은 구조 비교와 층별 개입 실험을 함께 제시하면서, 관측의 변화에 대한 강건성과 공간·목표 변화에 대한 적응을 구분한다.[3]
‘인코더 없음’은 시각 학습이 없다는 뜻이 아니다
NEO-VLA는 별도로 사전학습된 ViT, 오토인코더, 시각 코드북을 앞에 두지 않는다.[3]
대신 전체 stride가 32인 가벼운 두 단계 합성곱 패치 임베더로 픽셀을 토큰으로 바꾸고, 이미지와 언어를 40층 NEO-2B 백본 안에서 함께 처리한다.[3]
여기서 native는 구조적인 의미다.[3]
백본 자체는 이미지·텍스트 사전학습, 중간 학습, 멀티모달 지시 학습을 거쳤으므로, 시각적 사전학습 없이 로봇 데이터만으로 처음부터 모든 것을 배웠다는 주장은 아니다.[3]
논문의 백본 비교에서 2B 표기는 별도 행동 전문가를 제외한 크기다.[3]
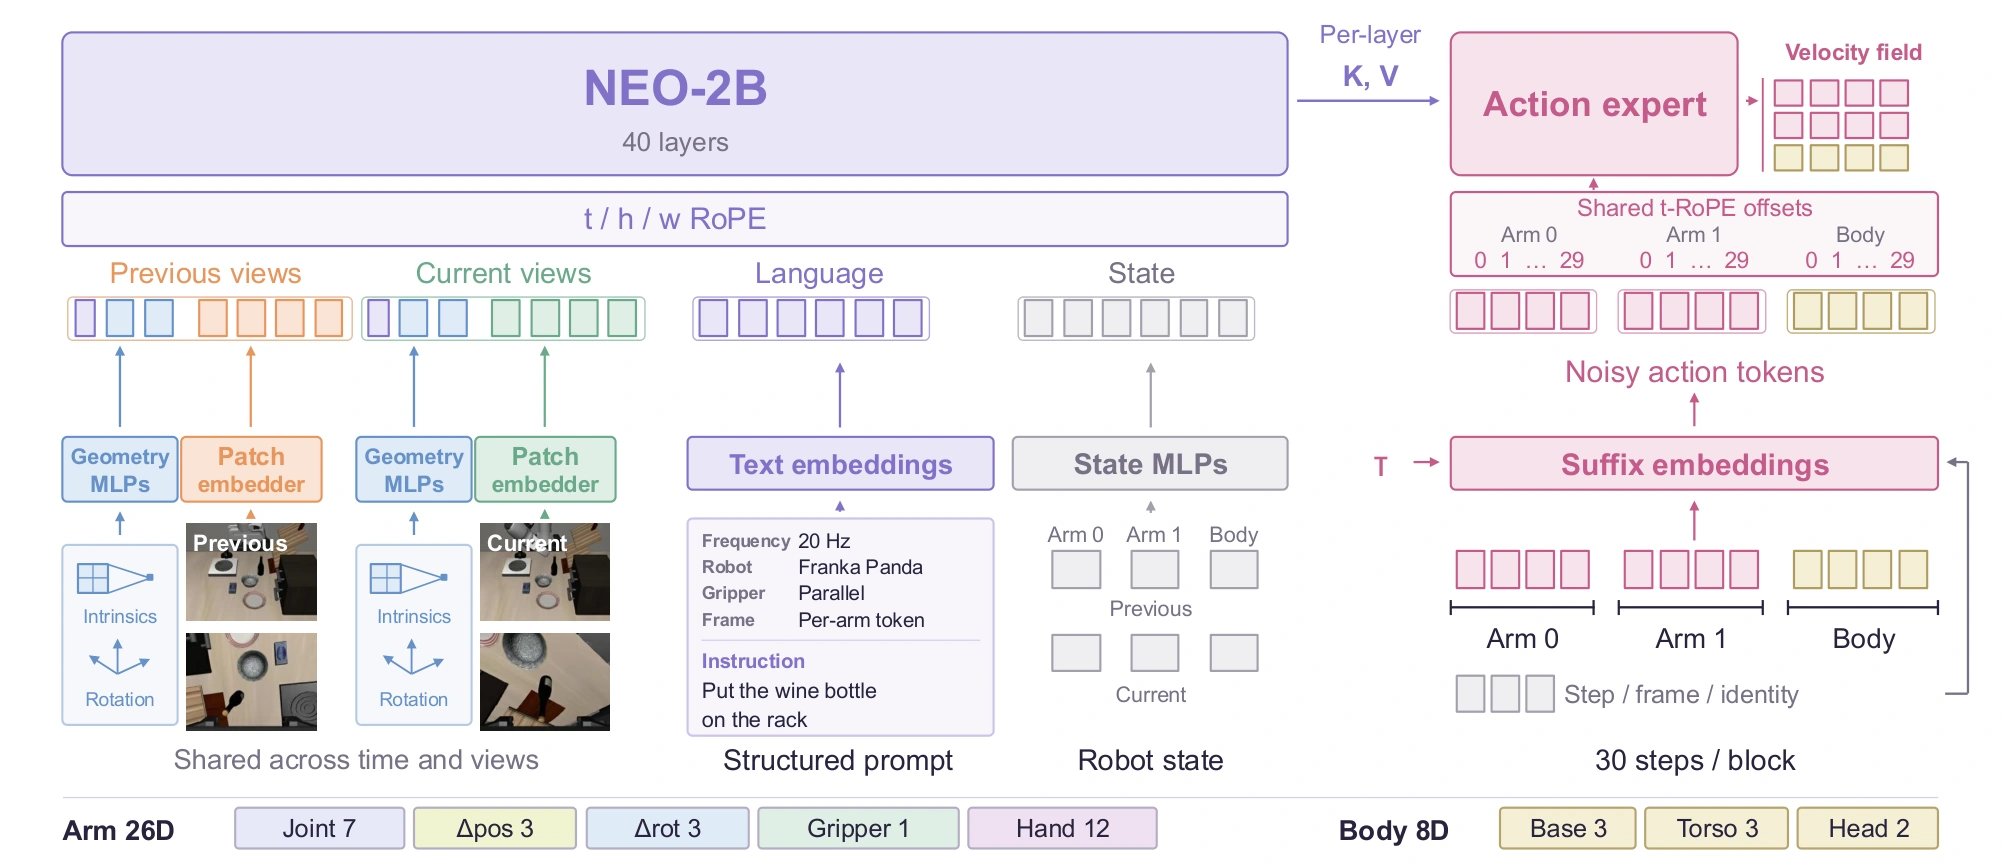
논문 그림 2.
시각·언어·상태가 공통 prefix를 이루고, 행동 전문가는 선택한 백본 층의 키·값 캐시를 읽어 연속 행동을 예측한다.[3]
원본 영문 표기는 유지했다.
모바일에서는 좌우로 밀거나 눌러 확대할 수 있다.
입력에는 이전·현재 시점의 다중 카메라 이미지, 카메라 내부 파라미터와 회전, 작업 지시, 로봇의 관절·몸체 상태가 들어간다.[3]
행동 전문가는 이를 조건으로 flow matching을 사용해 30스텝의 연속 행동 묶음을 만든다.[3]
같은 백본 캐시를 샘플링 단계마다 재사용하되, 로봇별 정규화와 유효 채널 마스크를 적용하므로 출력 숫자를 임의의 로봇에 그대로 보내는 인터페이스는 아니다.[3][5]
같은 행동 학습 조건에서 백본을 비교한다
저자들은 Qwen3-VL-2B, Gemma-3-4B, NEO 백본을 같은 행동 전문가 설계와 로봇 학습 조건으로 비교한다.[3]
이 비교는 Open X-Embodiment에서 75,000회 사전학습한 뒤 LIBERO의 최종 30,000스텝 체크포인트를 평가하며, 네 suite당 500회씩 총 2,000회 에피소드를 사용한다.[3][8]
| 백본 | 동결 → 전체 FT |
|---|---|
| Qwen3-VL-2B | 79.5 → 90.8 |
| Gemma-3-4B | 84.5 → 91.0 |
| NEO-2B | 90.9 → 95.3 |
단위는 평균 성공률(%).
동결은 백본을 고정하고 행동 전문가만 학습하는 조건이다.[3]
NEO의 장점은 특히 백본을 고정했을 때 크다.
다만 백본들의 원래 사전학습 데이터와 용량까지 같지는 않으므로, 이 차이를 인코더 제거 하나의 인과 효과로 단정할 수 없다.[3]
Qwen의 중간 시각 인코더 특징을 행동 전문가에 직접 연결한 별도 실험도 동결 조건에서 79.5에서 64.9로 떨어졌다.[3]
이 결과는 “중간 특징을 노출하기만 하면 된다”보다, 그 특징이 언어와 함께 어떤 표현 공간에서 형성됐는지가 중요하다는 해석을 뒷받침한다.[3]
초기 층이 중요한가: 가장 깔끔한 비교는 무엇인가
skip-28은 백본 전체 깊이에서 28개 층을 고르고, end-28은 뒤쪽 12–39층만 읽는다.[3]
두 설정은 40층 백본과 28층 행동 전문가를 유지하므로, 초기 층 접근의 효과를 비교하기에 상대적으로 깔끔하다.[3][8]
동결 조건에서 성공률은 skip-28 90.9, end-28 86.7이며, 전체 미세조정에서는 각각 95.3과 92.5다.[3]
반면 앞부분만 읽는 first-28·first-14는 백본 깊이도 줄이므로, 초기·후기 표현의 차이와 계산 깊이의 효과가 함께 바뀐다는 한계가 있다.[3]
저자들은 한 연결 지점의 키·값을 다른 관측·과제의 것으로 바꾸는 개입도 수행한다.[3]
초기 연결 지점에서 위치 예측 오차가 특히 커졌고, 같은 크기의 잔차 잡음은 영향이 작았다.[3]
이는 바뀐 정보의 내용에 대한 의존성을 보여주지만, 모든 로봇 과제에서 항상 초기 층만 쓰는 것이 최선이라는 증명은 아니다.
전체 미세조정에서는 여러 깊이를 읽는 skip-28이 가장 좋았다.[3]
이해 능력을 유지하는 학습도 중요하다
논문은 백본 동결 행동 학습, 전체 모델의 이해·행동 공동 학습, 자체 로봇 데이터 적응이라는 단계적 레시피를 설명한다.[3]
공동 학습에서는 격번 최적화 스텝에 멀티모달 이해 예제를 넣고, 보조 다음 토큰 예측 손실에 0.1 가중치를 준다.[3]
RoboTwin 2.0의 Clean2Rand 결과는 공동 학습 69.4, 행동만 미세조정한 모델 10.7이다.[3]
행동만 학습한 모델은 유효한 텍스트 출력도 잃었다고 보고한다.[3]
이는 해당 레시피에서 이해 표현 보존이 유리했다는 근거이지, 모든 VLA 학습에서 같은 격차를 보장하는 법칙은 아니다.
시각적 강건성과 공간 적응은 다르다
최종 벤치마크 결과는 앞의 통제 실험과 구분해야 한다.[3]
예를 들어 주 LIBERO 결과는 27,500스텝에서 suite당 2,000회 평가한 값이며, 다른 논문의 비교 모델들은 시뮬레이터·카메라·학습 데이터·평가 절차가 다를 수 있다.[3]
| 평가 | NEO-VLA 성공률(%) |
|---|---|
| LIBERO | 97.4 |
| LIBERO-Plus | 89.7 |
| LIBERO-Pro | 47.9 |
| RoboTwin Clean | 75.78 |
| RoboTwin Clean2Rand | 69.40 |
논문 표 5·7·8·9의 결과.
LIBERO-Plus 총점은 일곱 축의 단순 평균이 아니라 과제 수로 가중한 값이다.[3]
LIBERO-Plus에서는 카메라 변화 94.5, 언어 변화 91.7로 강점을 보인다.[3]
그러나 LIBERO-Pro에서는 의미 변화 98.0과 달리 위치 변화는 3.0, 과제 목표 변화는 6.3에 그친다.[3]
Pro 평균도 표의 π0.5 53.3보다 낮으므로, 분포 변화 전반에서 가장 강하다고 요약하면 핵심 한계를 가리게 된다.[3]
따라서 이 논문의 강건성은 보이는 방식이 달라져도 버티는 능력에 가깝다.
배치나 목표가 달라졌을 때 행동을 유연하게 재구성하는 문제까지 해결한 것은 아니다.[3]
실제 로봇 결과와 지연의 범위
실제 로봇 실험은 세 과제에 과제당 50개 시연을 사용해 미세조정하고, 과제당 20회 평가한다.[3]
각 20회에는 학습 분포 안 10회와 밖 10회가 함께 들어가며, 공개 표는 이 둘을 합친 성공 횟수다.[3][8]
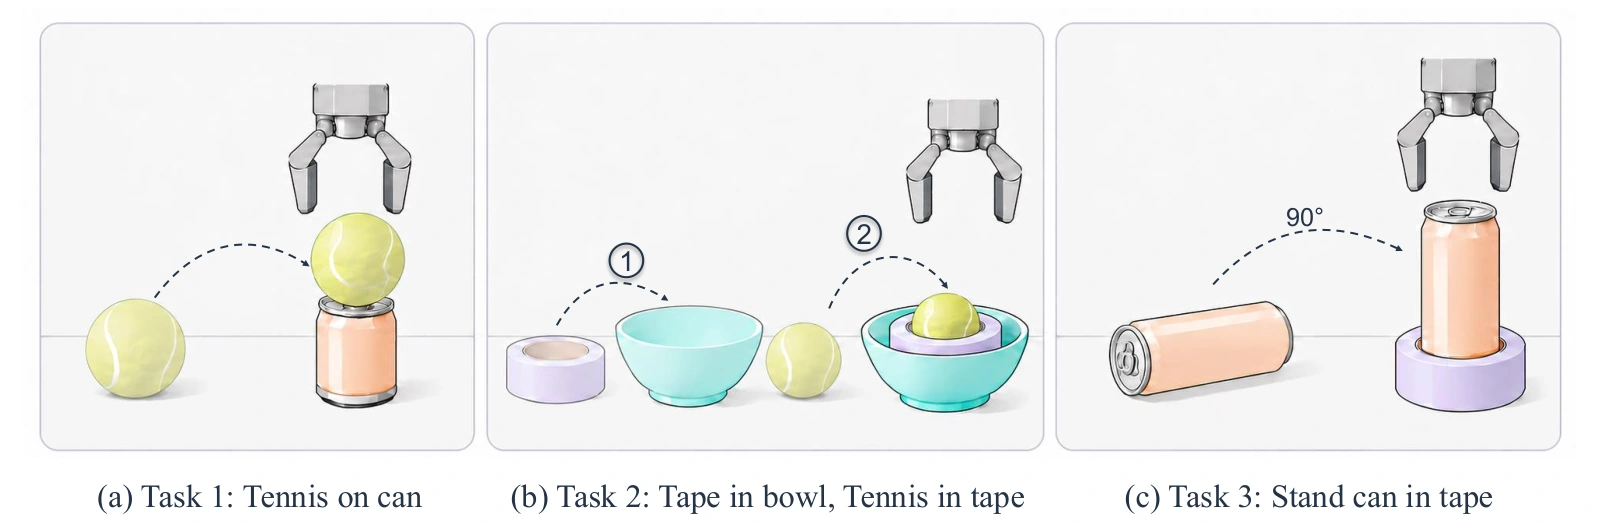
논문 그림 5는 세 과제의 정의를 보여주는 도식이며, 성공 사례를 집계한 그림은 아니다.[3]
모바일에서는 좌우로 밀거나 눌러 확대할 수 있다.
| 과제 | NEO / π0.5 |
|---|---|
| 공을 캔 위에 | 12 / 10 |
| 테이프·공 순차 배치 | 17 / 14 |
| 캔을 세워 삽입 | 13 / 13 |
값은 과제당 20회 중 성공 횟수이며, NEO-VLA / π0.5 순서다.
같은 실제 데이터와 각 방법의 권장 후학습 설정을 사용했다.[3]
작은 표본에서 이 차이만으로 통계적으로 확정된 우위를 주장하거나 OOD 성공률을 따로 추정할 수는 없다.
지연은 RTX 3090 한 장, BF16, 원시 30스텝 행동 묶음 조건에서 측정했다.[3]
10회 Euler 샘플링의 compiled forward는 282.5ms, 역기구학까지 포함해 실행 계획이 준비되기까지는 286.2ms다.[3]
2회 샘플링에서는 각각 147.8ms와 178.5ms지만, 실제 로봇 성공률 표는 모두 10회 샘플링 결과이므로 속도와 정확도를 같은 조건처럼 묶어서는 안 된다.[3]
행동 묶음의 생성 지연은 제어 한 스텝의 주기와도 다르다.
공식 소개·시연 영상은 동작을 이해하는 데 유용하다.
소개 영상의 로봇 장면은 2–8배속이며 장면마다 표시되므로, 이를 실제 추론 지연의 측정 자료로 읽어서는 안 된다.[8]
무엇이 공개됐고, 무엇이 아직 필요한가
코드는 NEO 저장소의 VLAKit 하위에 공개되어 있다.[7][9]
현재 HF 파일 목록에는 stage1, stage2뿐 아니라 stage_libero, stage_rtw의 실제 정책 체크포인트도 있다.[5][10]
카드는 초기 두 단계가 학습 상태를 포함한다고 설명하며, 시뮬레이터용 정책은 제공된 embodiments.json 정규화 기록과 함께 사용해야 한다.[5]
다만 논문의 실제 로봇 과제에 적응한 별도 체크포인트는 이 HF 저장소 목록에서 확인되지 않는다.[10]
별도의 stage2_backbone은 행동 전문가를 제거한 HF 형식의 후학습 백본이다.[5]
이것을 원래의 NEOpp-2B-SFT 초기 백본이나 독립적인 로봇 정책으로 착각하면 안 된다.
원 초기 백본은 공개되지 않았다고 카드가 명시한다.[5]
데이터 카드의 2,231,583 에피소드·928,401,030행은 의도된 전체 코퍼스 규모이며, 업로드 완료 수치가 아니다.[6]
파일은 이미 공개되어 있지만 업로드는 불완전하고, 사용할 항목에는 Arrow·메타데이터·카메라 아카이브가 함께 갖춰져야 한다.[6][11]
전체 카메라 자세의 투영 일관성 검증도 진행 중이라고 적혀 있다.[6]
공개 공동 학습 설정의 COCO ShareGPT는 예시이며, 논문의 원 멀티모달 이해 데이터 혼합을 그대로 재현하는 패키지가 아니다.[5][9]
학습 가이드는 원천별 변환기와 자체 로봇 코퍼스의 manifest·캐시·정규화 생성 도구도 포함되지 않았다고 명시한다.[12]
코드의 Apache-2.0과 백본·원천 데이터의 권리도 분리해야 한다.[5][6][9]
배포자의 SOURCES.md는 일부 원천에 CC BY-NC-SA 4.0 조건이 있고, 정확한 revision·attribution 기록은 확인 중이라고 적는다.[13]
물리 로봇에 적용하기 전에는 해당 로봇의 행동 단위·좌표계·정규화와 안전 제약을 확인하고 별도로 평가해야 한다.[3][5]
NEO-VLA의 의미는 단순히 시각 인코더 하나를 뺐다는 데 있지 않다.
행동 정책이 읽을 수 있는 표현의 깊이를 설계 변수로 만들었다는 것, 그리고 지각의 강건성과 유연한 행동 적응을 따로 측정해야 한다는 점이 더 오래 남는 결과다.[3]