고객 문의를 어느 팀으로 보낼지, 메시지를 검토 대상으로 표시할지처럼 필요한 답이 짧고 정해진 작업이 있다.
Baseten이 10월 29일 발표한 Joey-1은 이런 판단을 위해 긴 문장을 생성하는 대신, 선택지와 확률을 직접 돌려주는 2B급 결정 모델이다.[1][2]
핵심은 모든 LLM을 작은 모델로 바꾸자는 것이 아니다.
대량으로 반복되는 앞단 판단을 저렴하게 처리하고, 어려운 사례만 더 큰 모델이나 사람에게 넘기는 계층을 만드는 데 있다.[1]
다만 제목의 20ms는 공급자가 특정 운영 조건에서 보고한 중앙값이며, 모든 입력의 응답 시간이나 정확도 보장은 아니다.[1]
생성형 답변과 다른 출력 계약
Joey-1은 Qwen3.5-2B를 후학습한 모델로, 텍스트와 이미지를 입력받는다.[2]
애플리케이션은 공통 상태인 state와 질문 모음인 questions를 보내며, API는 질문별로 정해진 타입의 값을 반환한다.[5][6]
| 질문형 | 받는 값 |
|---|---|
choice |
선택된 후보와 후보별 확률 |
noul |
‘예’일 확률 |
score |
순서 있는 등급의 확률과 기대 점수 |
noul은 오타가 아니라 실제 API 타입 이름이다.[6]
예를 들어 문의의 담당 팀, 환불 요청 여부, 긴급도를 한 요청에서 물을 수 있지만, 모델은 질문들을 독립적으로 평가한다.[5]
한 질문의 답을 다른 질문의 근거로 사용하거나, 최종 환불 승인 규칙까지 자동으로 결합하는 것은 아니다.[6]
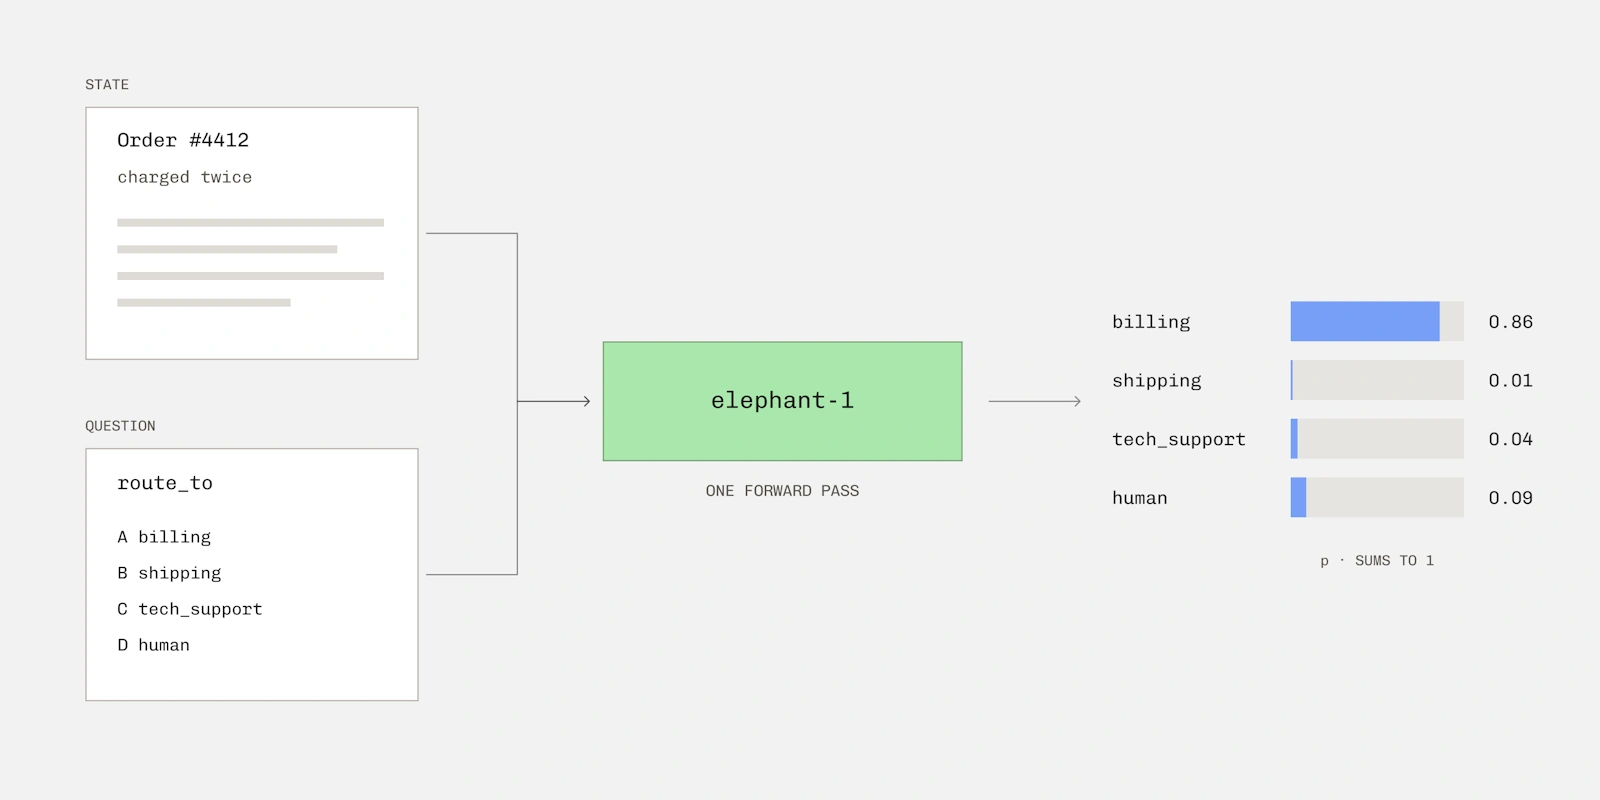
상태와 질문에서 후보 확률을 읽는 공통 인터페이스를 보여주는 elephant-1의 공식 도식이며, Joey-1 자체의 측정 결과는 아니다.[3]
원본 영문 표기는 유지했다.
모바일에서는 눌러 확대할 수 있다.
공통 입력은 한 번, 질문은 따로 읽는다
공식 기술 보고서에서는 상태와 시스템 프롬프트를 공통 prefix로 처리한 뒤, 질문·선택지에 해당하는 suffix마다 캐시를 재사용한다고 설명한다.[3]
Joey-1 모델 카드도 여러 질문을 하나의 공유-prefix prefill로 처리한다고 명시한다.[2]
따라서 질문을 묶으면 긴 본문을 요청마다 반복해서 읽는 비용을 줄일 수 있지만, 추가 질문의 연산까지 없어지는 것은 아니다.[3][5]
답은 선택지를 나타내는 토큰들의 logits에 softmax를 적용해 얻는다.[3]
자유 서술을 여러 토큰에 걸쳐 생성하고 JSON을 파싱하는 경로와는 다르며, API 사용량에는 질문당 출력 토큰 하나가 기록된다.[5][6]
입력 사용량은 공통 prefix를 한 번 센 뒤 질문별 토큰과 형식·이미지 토큰을 더한다.[6]
Joey-1 카드가 명시한 구조적 변경은 full-attention 층의 block-bidirectional mask다.[2]
기술 보고서에서는 질문 블록이 선택지를 함께 읽되, 공통 prefix는 질문을 보지 않게 만들어 캐시를 공유하고, Gated DeltaNet 층은 causal하게 유지한다고 설명한다.[3]
보고서의 구체적인 층 수와 구조 비교 실험은 9B·27B 형제 모델에 관한 것이므로 Joey-1의 직접적인 절제 실험으로 옮겨 읽으면 안 된다.[3]
확률 보정도 학습 목표이지 정답 보장은 아니다
모델 카드에 따르면 Joey-1은 621만 개 결정 예제인 Mix 8로 학습하며, cross-entropy에 Brier 보정 항을 가중치 1로 더한다.[2]
언어 모델을 전체 미세조정하되 비전 인코더는 고정하고, ‘모르겠다’ 선택지를 학습한다고 설명한다.[2]
형제 모델의 기술 보고서는 기본 판단 능력, 안전·기권, 판정·전문 영역, 공개 결정 데이터를 혼합하고, 잘못된 라벨이나 선택지만 보고 답을 맞힐 수 있는 예제를 반복해서 정리하는 과정을 다룬다.[3]
이 레시피의 의미는 단순히 작은 모델을 빠르게 서빙하는 데 그치지 않고, 제한된 후보 사이의 판단과 불확실성 표현 자체를 학습한다는 것이다.[2][3]
그렇다고 응답의 확률이 모든 업무 분포에서 자동으로 보정된다는 뜻은 아니다.
특히 API의 confidence는 선택지 분포의 집중도를 나타내는 값이지, 선택된 답의 확률과 같은 필드가 아니다.[5][6]
자동 처리 임계값에는 probabilities[choice]를 사용하고, 실제 라벨이 있는 업무 데이터로 오판 비용과 검토 비율을 함께 점검해야 한다.[5]
20ms와 0.01달러를 어떻게 읽어야 하나
Baseten은 평균 2,000토큰 요청을 운영 규모로 처리할 때 Joey-1의 P50 종단간 지연이 20ms, elephant-1은 49ms라고 보고한다.[1]
이는 해당 서비스 조건의 자기보고이며, P99·네트워크 위치·질문 수·이미지 크기까지 포괄하는 보편적 지연 보장은 아니다.[1]
발표 시점의 입력 토큰 가격은 다음과 같으며, 현재 Joey-1 라이브러리 페이지도 입력 0.01달러를 표시한다.[1][4]
| 모델 | 입력 100만 토큰 가격 |
|---|---|
| Joey-1 | $0.01 |
| elephant-1 | $0.035 |
| mammoth-1 | $0.10 |
0.01달러는 요청 한 번의 가격이 아니다.
발표 글은 문의 1,000만 건에 건당 약 500토큰을 가정하면 50억 토큰이며, Joey-1의 입력 비용이 약 50달러라고 계산한다.[1]
질문·형식·이미지 토큰도 사용량에 포함되므로, 본문 길이만 세어 실제 청구액을 확정해서는 안 된다.[6]
서비스 등급과 최신 요금은 별도로 확인해야 하며, 상위 모델 재평가나 사람 검토 비용도 이 입력 비용 예시와 구분해야 한다.[5][7]
벤치마크의 출처와 split을 나눠 읽는다
공개 split, 비공개 종합 평가, 회사의 자체 재현은 서로 다른 근거다.
모델 카드와 11월 4일 리더보드 스냅샷을 나누면 다음과 같다.[2][10]
| 평가 | Joey-1 점수 |
|---|---|
| Jev Decision Index 0.4 공개 split | 63.30 |
| Jev 비공개 종합 Full | 35.91 |
| Artificial Analysis Decision Index 자체 재현 | 62.9 |
공식 카드는 Jev 공개 split에서 4B 미만 모델 중 가장 높다고 보고하지만, 같은 표의 elephant-1은 72.24로 더 높다.[2]
비공개 기존 능력·신규 영역을 평가하는 Full은 35.91로, 공개 63.30과 별개다.[10]
작은 모델이 더 싸다는 사실과 낯선 업무에서도 더 정확하다는 주장은 구분해야 한다.
리더보드 운영자는 비공개 신규 영역 한 항목에서 학습 데이터 overlap 징후를 발견해 해당 결과를 제외했다고 주석을 남겼다.[10]
이는 운영자의 평가 범위 제한 기록이며, 원 학습 데이터를 독립 감사해 유출을 확정했다는 뜻으로 확대할 수 없다.
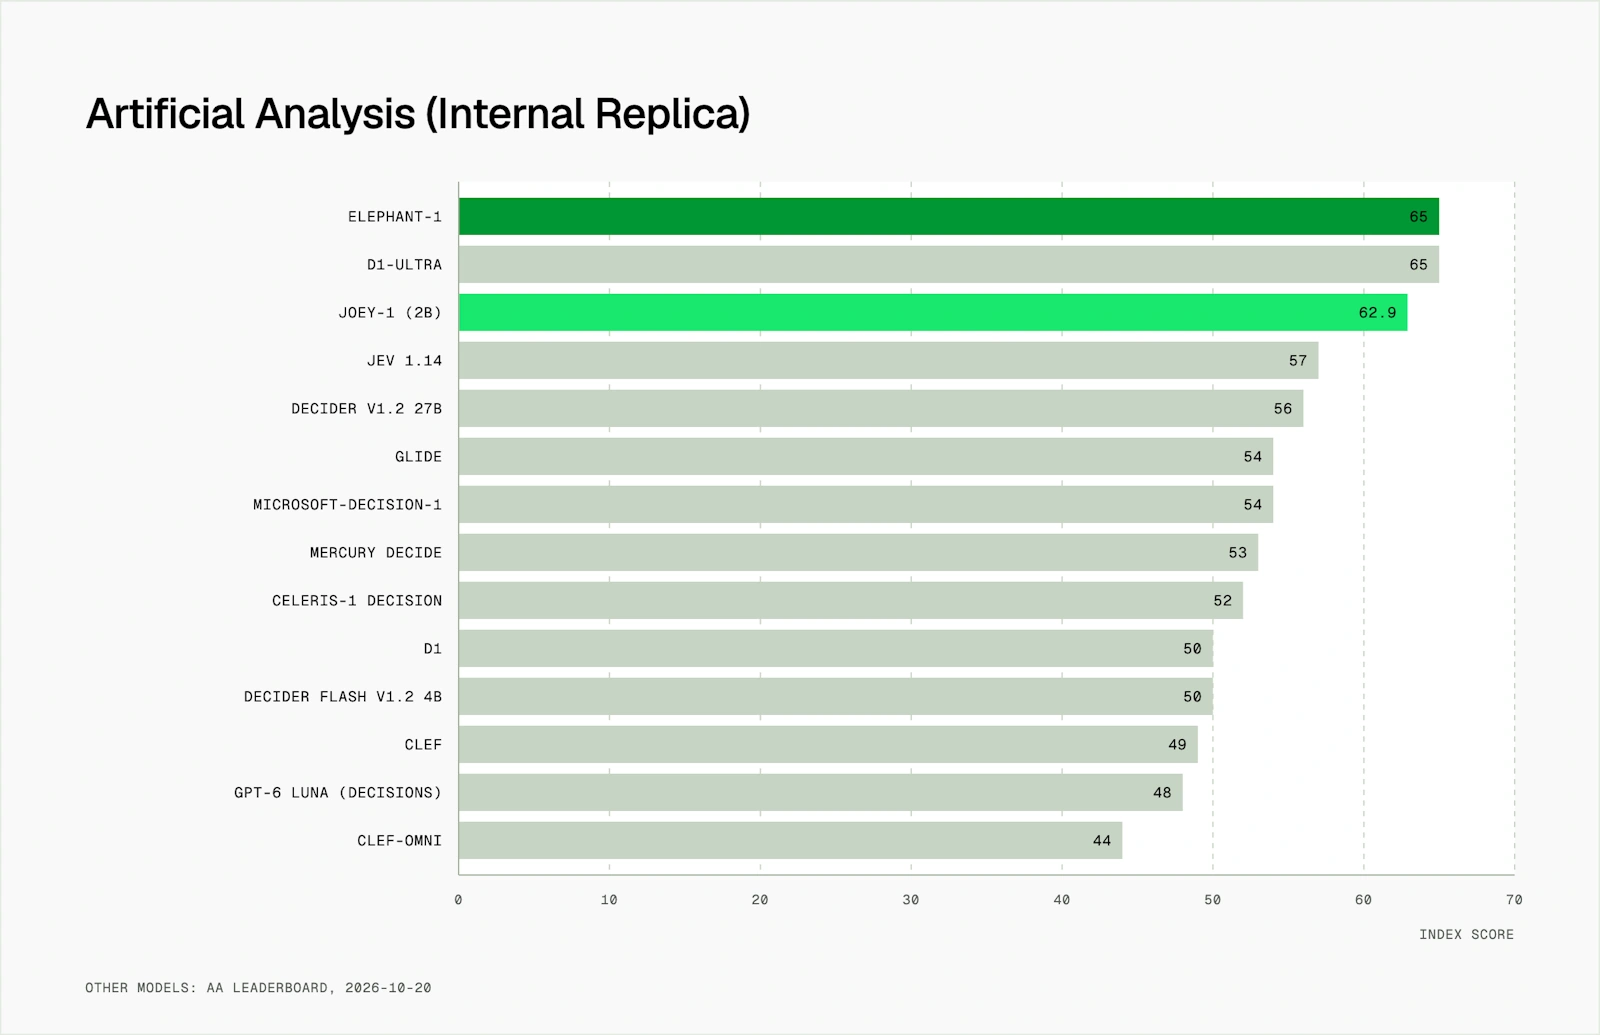
‘Internal Replica’라는 제목의 발표 그림으로, Joey-1의 62.9점은 Baseten의 자체 재현이다.[1]
비교 모델 수치는 2026년 10월 20일 AA 공개 리더보드에서 가져왔으므로, 모든 막대가 독립 기관의 동일 실행 결과는 아니다.[1]
모바일에서는 눌러 확대할 수 있다.
이 글의 점수와 지연은 공개 자료에 보고된 값이지 독립 재실행 결과가 아니다.
따라서 고객 문의의 라우팅 정확도, 한국어 입력, 희귀 위험 사례까지 같은 품질을 낸다고 일반화하기보다, 실제 업무의 보류·오분류 사례로 작은 모델의 담당 범위를 정하는 편이 맞다.
별도의 커뮤니티 안전성 평가도 있다.
공개 HF 토론은 의심스러운 에이전트 도구 호출 562건의 zero-shot 평가에서 balanced accuracy 0.502, AUROC 0.482를 보고한다.[13]
다만 이 평가의 adapter는 아래의 repo-id 로딩 경로를 사용하므로, 학습 때의 attention 설정이 그대로 적용됐는지 재검증 여지가 있다.[11][14]
저성능을 무시할 근거도, 모두 서빙 문제 탓이라고 확정할 근거도 없으며, Jev와 다른 과제·설정의 결과로 읽어야 한다.
API와 공개 가중치는 같은 배포 조건이 아니다
현재 Model APIs 문서는 Joey-1의 slug를 decision-models/baseten-joey-2b-latest, 문맥 한도를 16,384토큰으로 명시한다.[5]
질문별 완성 프롬프트가 한도를 넘으면 일부를 자르는 대신 요청 전체를 거절한다.[6]
발표는 전용 배포에서 262K 문맥을 제공한다고 홍보하지만, 공개 모델 카드는 학습 길이를 16,384토큰으로 적는다.[1][2]
전용 배포의 설정 가능 범위와 장문 판단 품질이 검증됐다는 주장을 구분해야 한다.
공개 Hugging Face 저장소에는 실제 model.safetensors와 서빙 스크립트가 있다.[9]
카드의 자가 호스팅 경로는 CUDA GPU 한 개와 지정된 PyTorch·CUDA 컨테이너, 고정 서빙 런타임 및 패치를 요구하므로, 기본 Transformers 생성 코드만으로 같은 판단 경로가 보장되는 것은 아니다.[2]
카드 메타데이터는 MIT로 표기하지만 확인 시점의 파일 목록에는 별도 LICENSE가 없으므로, 전체 배포물의 권리와 상위 모델·런타임 조건까지 확인했다고 확대해서는 안 된다.[2][9]
공개 코드에는 중요한 재현 주의점도 있다.
런타임 패치는 모델이 로컬 디렉터리일 때 설정을 읽지만, 로컬 경로가 아닌 HF repo-id만 넘기면 기본 causal 설정으로 분기한다.[11][12]
따라서 로컬 snapshot 경로를 사용하고, 실제로 학습 조건인 block_bidirectional 설정을 읽었는지 확인해야 한다.[11]
이는 정적 코드 점검 결과로, 설정 차이가 성능에 미치는 크기를 측정했다는 뜻은 아니다.
또한 공식 cookbook은 기존 Joey-1에 추가 SFT를 하는 예제이지, 621만 개 원 학습 데이터 전체를 제공하는 완전 재현 패키지가 아니다.[15]
호스티드 API의 zero data retention은 기본 정책이며, 보안 문서는 이를 동기 추론에 적용한다고 명시한다.[1][8]
모든 비동기 큐·캐시·제품의 모든 데이터가 전혀 남지 않는다는 의미는 아니다.[8]
또한 latest는 고정 버전이 아니고 회사도 같은 API 아래 가중치를 계속 갱신한다고 설명하므로, 업무 평가 시점과 배포 버전을 기록하는 편이 안전하다.[1][5]
도입 지점은 ‘작은 판단의 앞단’이다
가장 자연스러운 시작은 이미 담당 팀이나 위험 여부처럼 답의 공간이 정해진 업무다.[1][5]
예를 들어 POST https://inference.baseten.co/v1/systemone에 다음과 같은 요청 본문을 보낼 수 있다.
이는 공식 API 형식에 맞춘 예시이며, 실제 호출에는 인증 키가 필요하다.[5][6]
{
  "model": "decision-models/baseten-joey-2b-latest",
  "service_tier": "default",
  "state": "I was charged twice. Please refund one charge.",
  "questions": {
    "route": {
      "type": "choice",
      "instructions": "Which team should handle this request?",
      "criteria": {
        "billing": "Payments and refunds",
        "technical": "Technical troubleshooting",
        "manual_review": "Insufficient information"
      }
    }
  }
}
응용 코드는 선택된 후보의 확률이 충분한지 보고 자동 라우팅과 검토를 나누면 된다.[5] manual_review 같은 후보를 둔다고 자동으로 기권 품질이 검증되는 것은 아니며, 환불 실행 권한이나 금액 한도 같은 비즈니스 규칙은 모델 밖에 남겨야 한다.
Joey-1의 가치는 가장 똑똑한 단일 모델이라는 데 있지 않다.
얼마나 많은 반복 판단을 작은 모델이 맡아도 되는지 측정하고, 나머지를 안전하게 넘길 수 있게 한다는 것이 실무적인 평가 기준이다.
이미 살펴본 Jev의 타입화된 판단 인터페이스와 같은 흐름 위에서, 더 작은 모델의 비용·지연 구간을 겨냥한 공개 모델로 볼 수 있다.[1][2]