코드를 실행하고 그래프를 만드는 것과, 그 결과로 과학적 주장을 정당화하는 것은 다른 일이다.
FrontierPhysics는 AI 에이전트에게 물리 연구의 이 전체 과정을 맡겨 보는 벤치마크다.[1][2]
문제를 읽고 문헌을 찾는 단계부터 계산·분석을 거쳐 연구 원고를 제출하는 단계까지 연결한다.[3]
가장 높은 보고 성공률은 27.4%다.[2][3]
하지만 이 숫자를 ‘물리 문제 정답률’이나 ‘새로운 논문을 발견할 확률’로 읽으면 안 된다.
어떤 과제를 주고, 어떤 실행을 분모에 넣으며, 누가 연구 완성도를 판정했는지 함께 봐야 한다.
아래의 실험 설정과 평가 수치는 arXiv 2611.06910v1 기준이다.[3][4]
지속적으로 갱신되는 웹 리더보드와도 버전을 구분해 읽어야 한다.[5]
정답 한 줄 대신 연구 결과물을 제출한다
Bingran You, Wenjun Ke 등 연구진은 물리 연구자 42명과 함께 9개 분야, 56개 과제를 구성했다.[2][3]
응집물질·원자분자광학·양자정보·천체물리 등을 포함하며, 수집한 과제 초안 182개 중 검수를 통과한 과제들이다.[3]
기여자가 직접 수행한 연구를 바탕으로, 원래 전문가에게 적어도 수 주가 걸릴 만한 문제를 벤치마크 환경으로 옮기는 방식이다.[3]
에이전트에게는 짧은 연구 제안서, 과제 설명, 필요한 데이터와 도구를 제공한다.[3]
대신 원 연구의 해답 논문을 그대로 따라 구현하도록 주지는 않는다.[3]
에이전트는 관련 문헌을 찾고 방법을 선택하며, 과제에 맞는 계산·분석 결과와 paper.pdf 같은 산출물을 남겨야 한다.[3]
예를 들어 Rydberg 원자 과제에서는 최대 세 원자를 다루는 모의 장치를 이해하고, 보정과 물리 분석을 수행해야 한다.[3][4]
실제 실험실의 장비를 에이전트가 자율적으로 조립해 연구를 검증했다는 뜻은 아니다.[3]
기존 연구 문제를 실행 가능한 데이터·코드·시뮬레이터 환경으로 재구성한 평가다.[3]
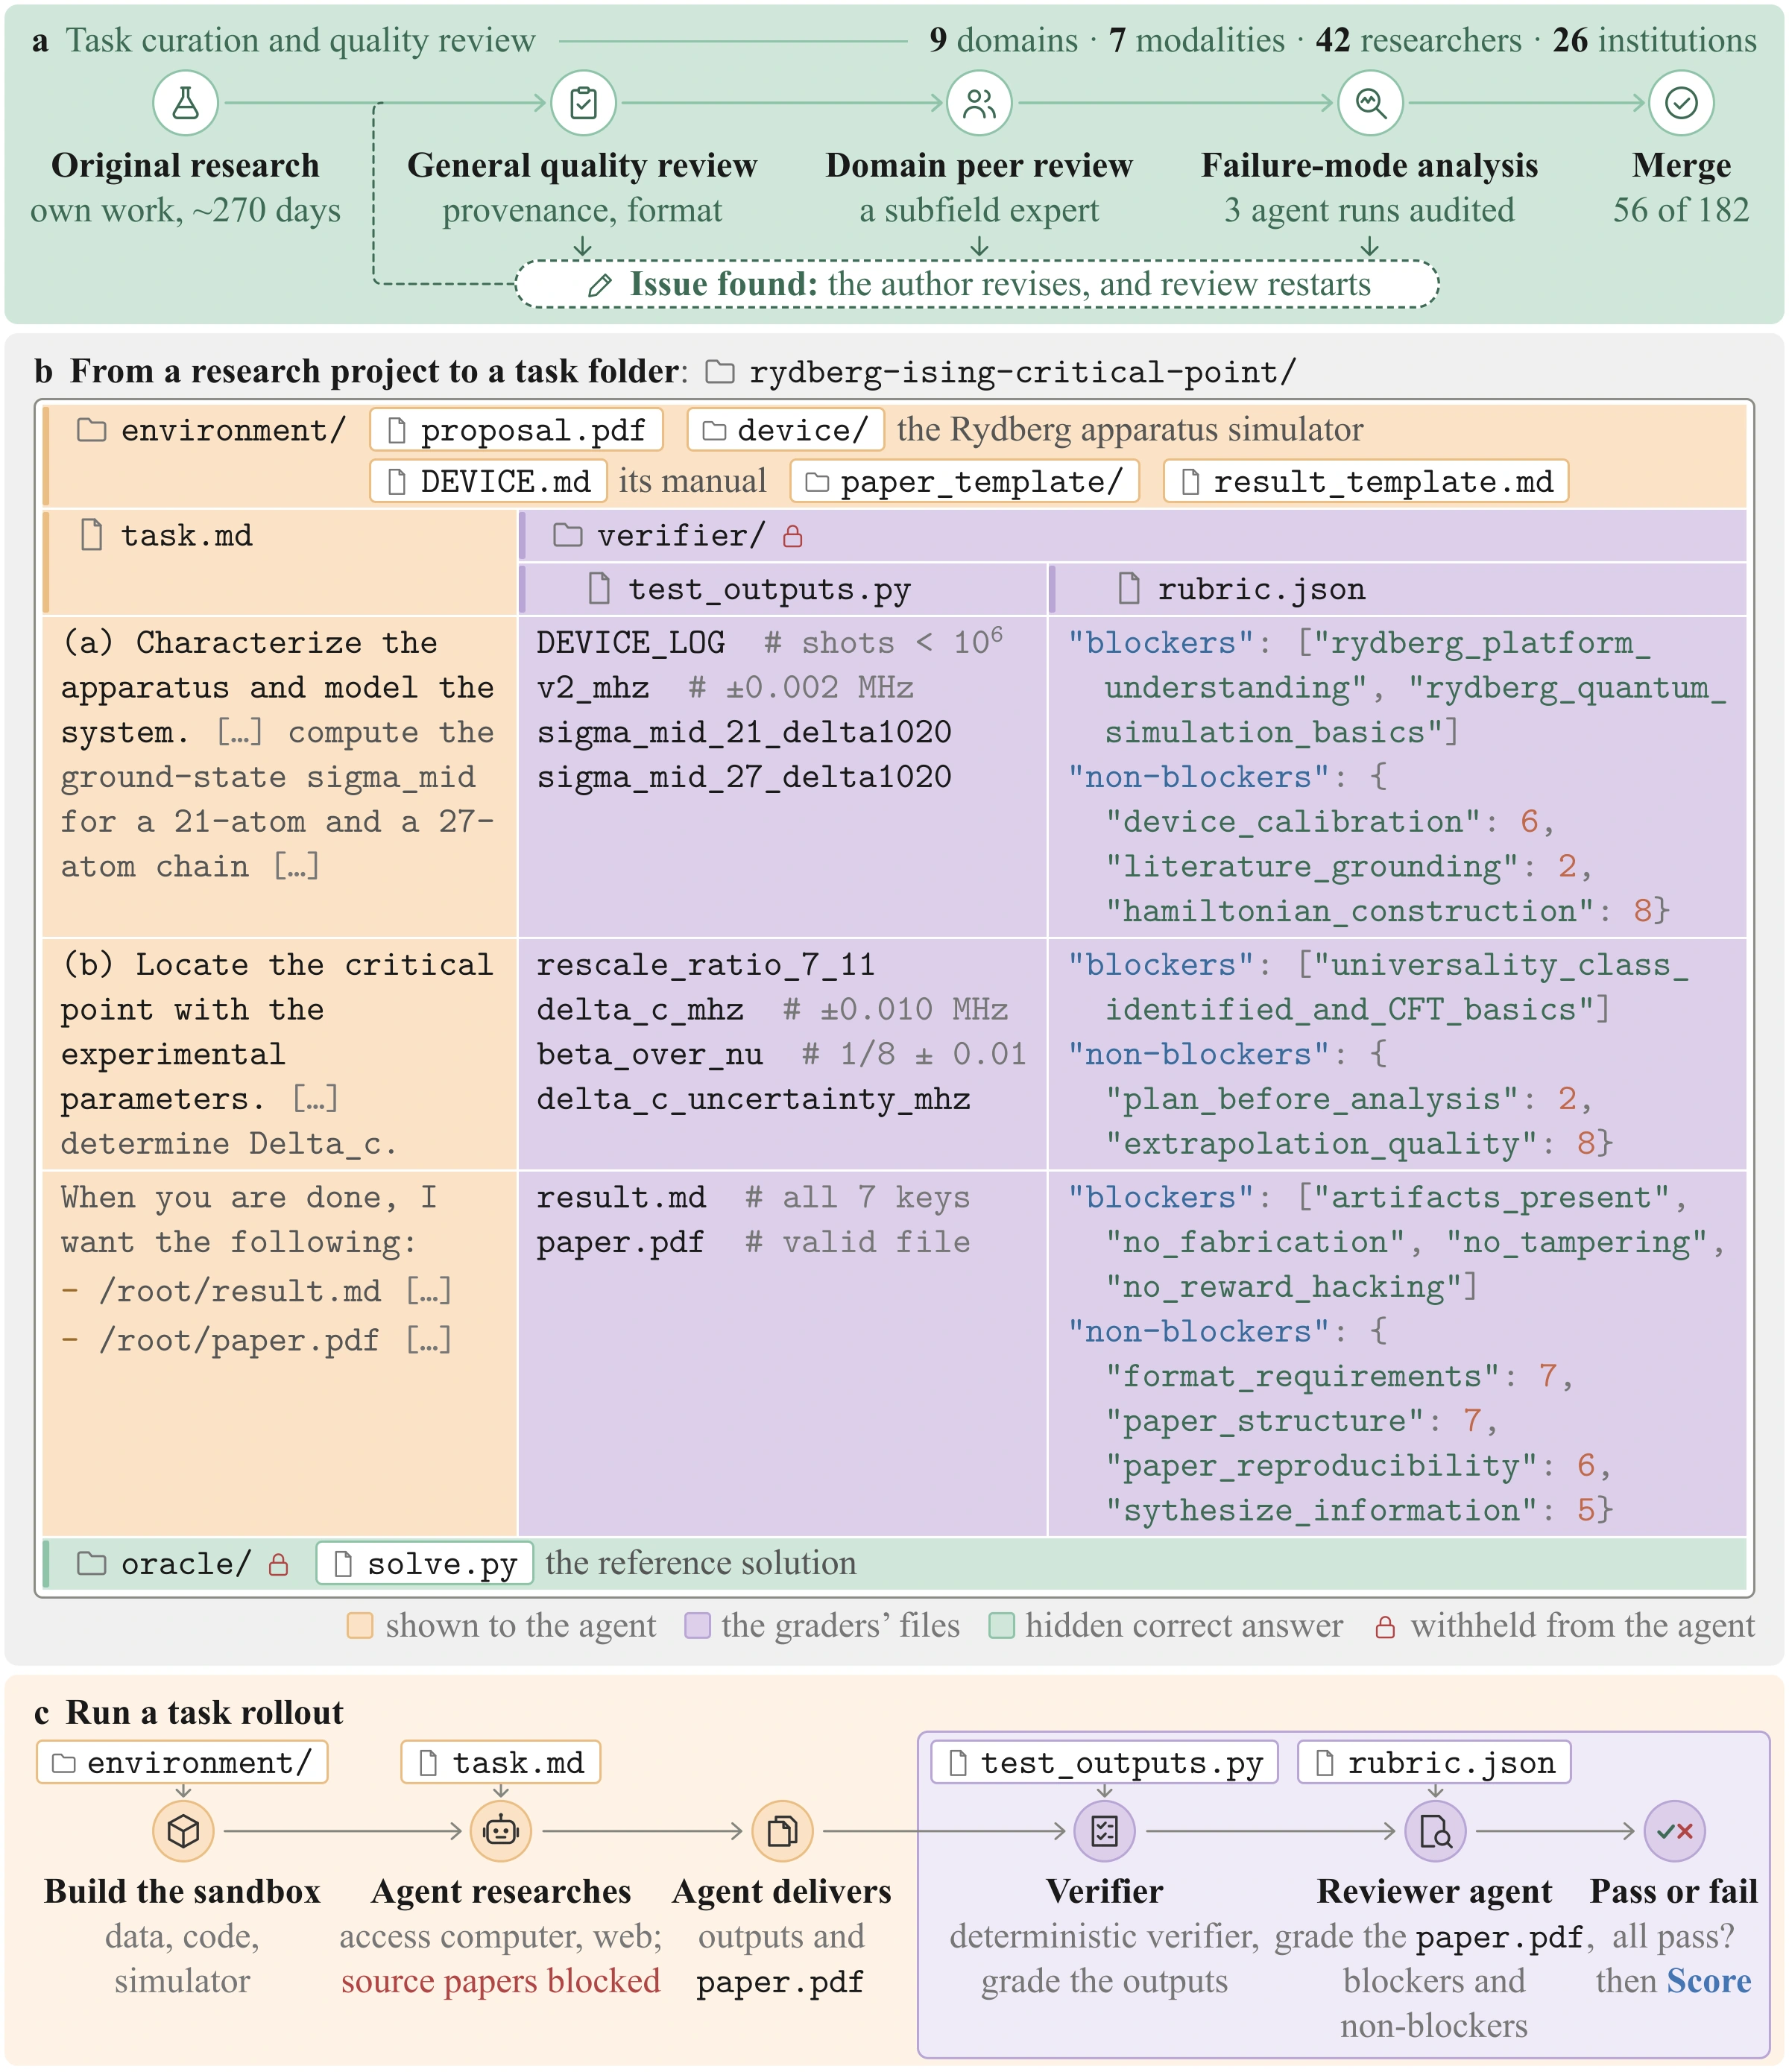
이 설계가 보는 것은 연구의 여러 단계를 끝까지 연결하는 능력이다.[3]
다만 이미 존재하는 연구에서 재구성한 과제이므로, 통과를 곧바로 독창적인 새 발견이나 실제 학술지의 게재 승인으로 해석해서는 안 된다.
실행 가능한 결과와 타당한 연구를 따로 검사한다
평가는 두 관문을 결합한다.[3]
- 결정적 검증기: 수치 허용오차, 출력 형식, 계산 결과 등 코드로 확인할 수 있는 조건을 검사한다.[3]
- 전문가 rubric: 물리적 논증, 관련 문헌의 활용, 방법과 결론의 정당화, 원고의 완성도처럼 단순 테스트로 충분히 평가하기 어려운 부분을 검토한다.[3]
Rubric에는 반드시 충족해야 하는 blocker와, 완성도를 점수화하는 비차단 항목이 있다.[3]
최종 통과에는 결정적 테스트와 모든 blocker를 함께 만족해야 한다.[3]
최종 점수도 어느 관문이든 실패하면 0점이며, 두 관문을 통과한 경우에만 비차단 항목의 가중 점수를 반영한다.[3]
따라서 통과율과 rubric 점수는 같은 지표가 아니다.
특히 관문 적용 전의 높은 rubric 점수를 최종 연구 성공률로 바꿔 읽으면 안 된다.[3][4]
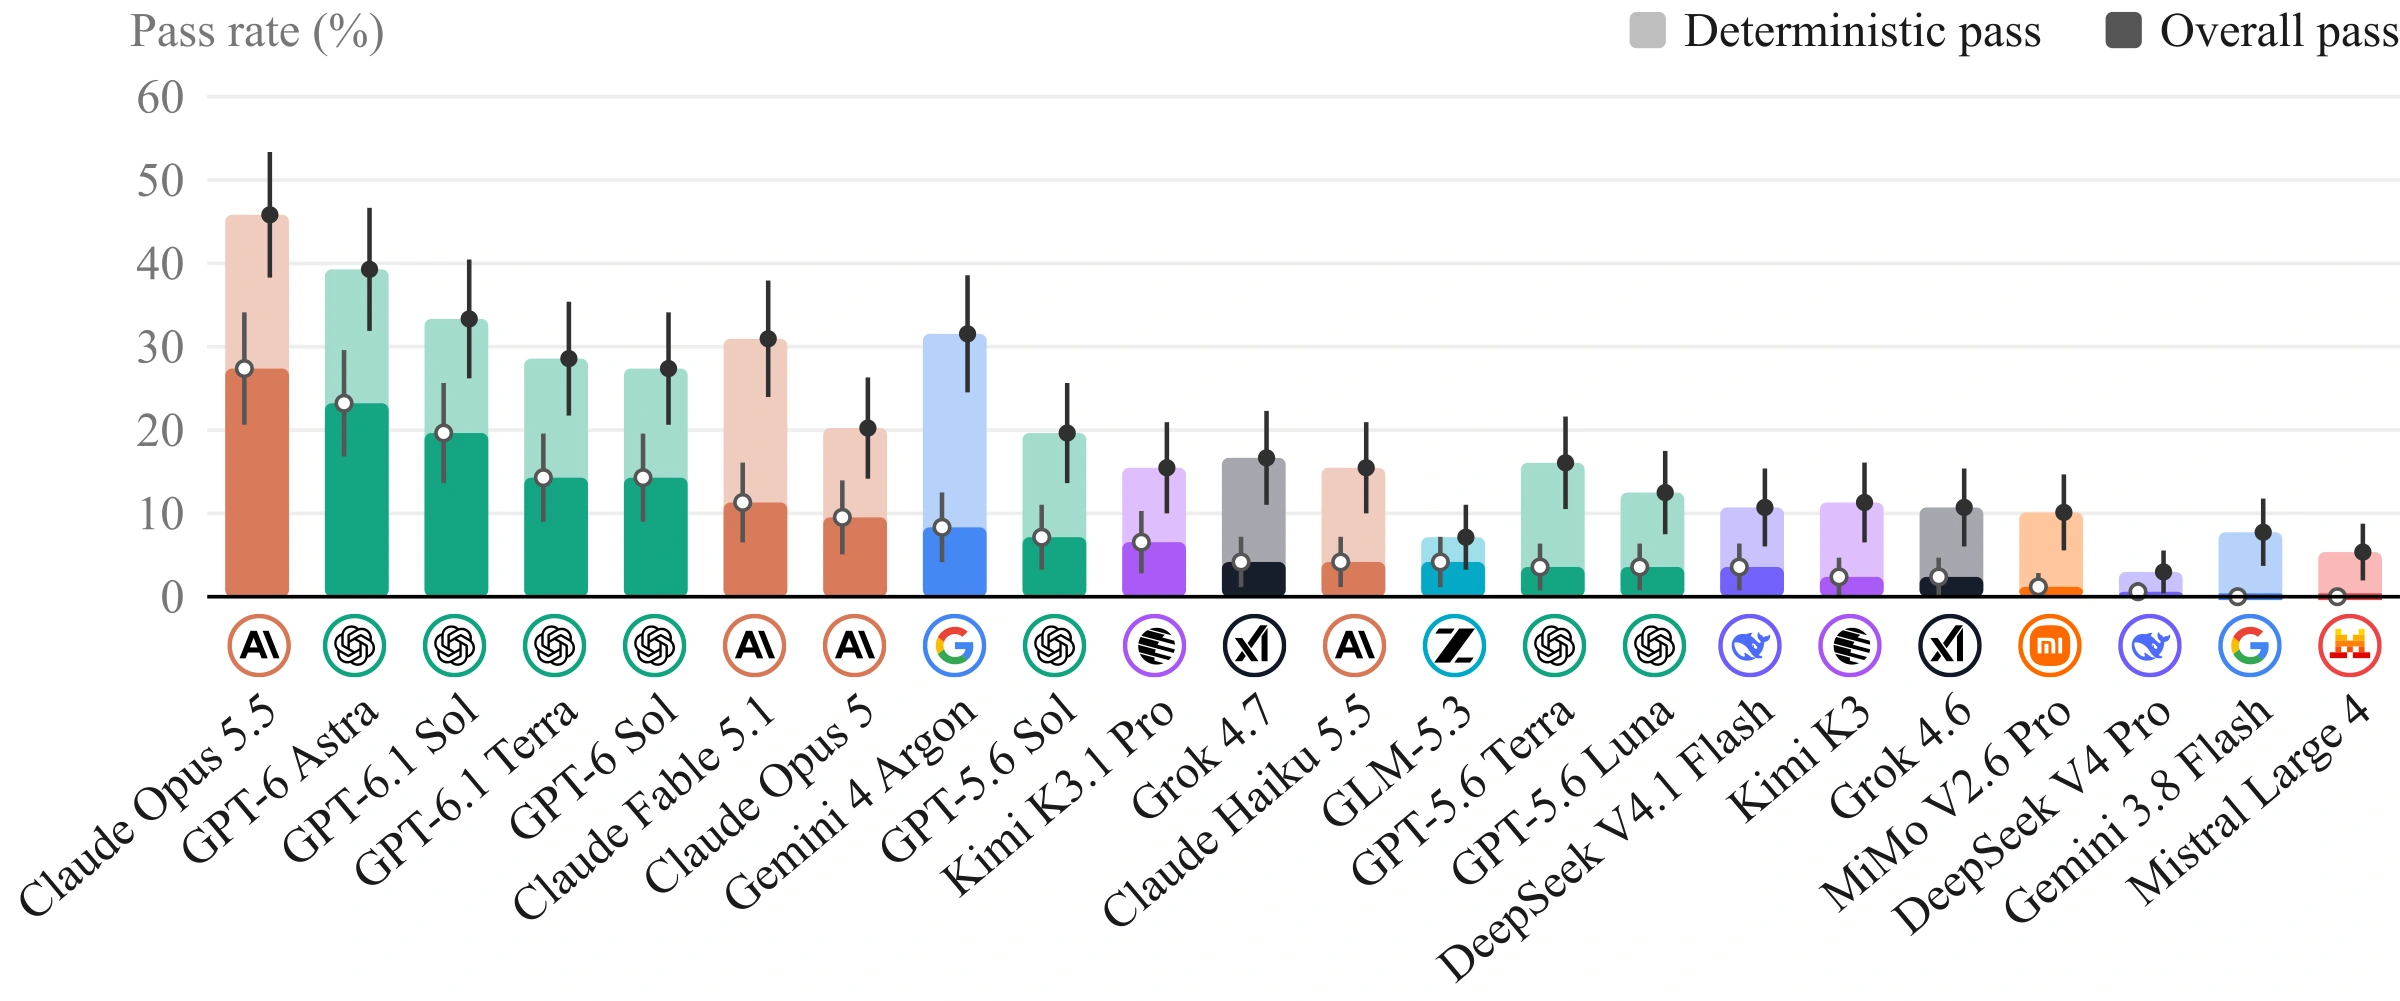
Claude Opus 5.5의 결정적 검증기 통과율은 45.8%, 전체 통과율은 27.4%다.[3]
테스트를 통과하는 계산 결과를 만들더라도, 논증과 근거가 연구 수준의 필수 조건을 만족하지 못할 수 있다는 차이를 보여 준다.
그렇다고 그 차이 전부를 모델의 과학적 오류로 단정할 수는 없다.
뒤에서 볼 평가기 오류도 함께 고려해야 한다.[3][4]
27.4%의 분모는 56개 과제의 반복 실행이다
실험은 22개 모델, 26개 설정을 Codex, Claude Code, Antigravity, Grok Build 계열의 harness로 비교한다.[3]
각 설정은 과제마다 세 번 독립 실행하며, 실행당 최대 10시간을 허용한다.[3]
기본 CPU 환경과 별도 GPU 환경 등 자원 조건도 과제에 맞춰 정한다.[3][4]
주요 지표는 다음처럼 구분한다.[3]
| 지표 | 무엇을 세는가 |
|---|---|
| Pass@1 | 과제별 세 번의 성공률을 평균한 뒤, 56개 과제에 걸쳐 평균한다.[3] |
| Pass@3 | 세 번 중 한 번이라도 성공한 과제의 비율이다.[3] |
| Score | 테스트와 blocker를 통과한 실행의 점수만 반영하며, 나머지는 0점이다.[3] |
아래는 논문의 일부 대표 설정이다.[3]
오른쪽 열의 숫자는 Pass@1 / Pass@3이며 단위는 %다.[3]
| 모델·실행 구성 | Pass@1 / Pass@3 |
|---|---|
| Claude Opus 5.5 · Claude Code · max | 27.4 / 44.6[3] |
| GPT-6 Astra · Codex · max | 23.2 / 30.4[3] |
| GPT-6.1 Sol · Codex · xhigh | 19.6 / 30.4[3] |
Opus 5.5의 27.4%는 168개 예정 실행 중 46회 통과한 값이다.[3][4]
Pass@3의 44.6%는 56개 중 25개 과제에서 적어도 한 번 성공했다는 뜻이지, 한 번 실행해 절반 가까이 해결했다는 뜻이 아니다.[4]
세 번 모두 성공한 과제는 8개로 보고돼 반복 실행의 안정성도 별개로 봐야 한다.[4]
완전한 결과가 없는 실행도 집계에서는 실패로 취급한다.[4]
또한 과제 단위 bootstrap으로 계산한 최상위 설정의 95% 신뢰구간은 17.9–36.9%다.[4]
부록의 대응 비교에서는 일부 상위 설정 간 차이를 통계적으로 구분하지 못했다.[4]
서로 다른 모델·추론 예산·harness를 결합한 결과이므로, 점수 순서가 곧 기반 모델만의 확정적 우열은 아니다.
실패는 물리 지식만의 문제가 아니었다
연구진은 초기 GPT-6 Astra xhigh의 168회 실행을 전문가가 검토하고, 그중 자동 평가에서 실패한 143회의 실패 원인을 분류했다.[3]
여기서 자주 등장한 것은 엄밀한 사고 부족 48%, 전문가적 직관 부족 34%, 문헌 관련 오류 27%, 지시 이행 문제 26%였다.[3]
한 실행에 여러 태그를 붙이므로 합이 100%일 필요는 없다.[3]
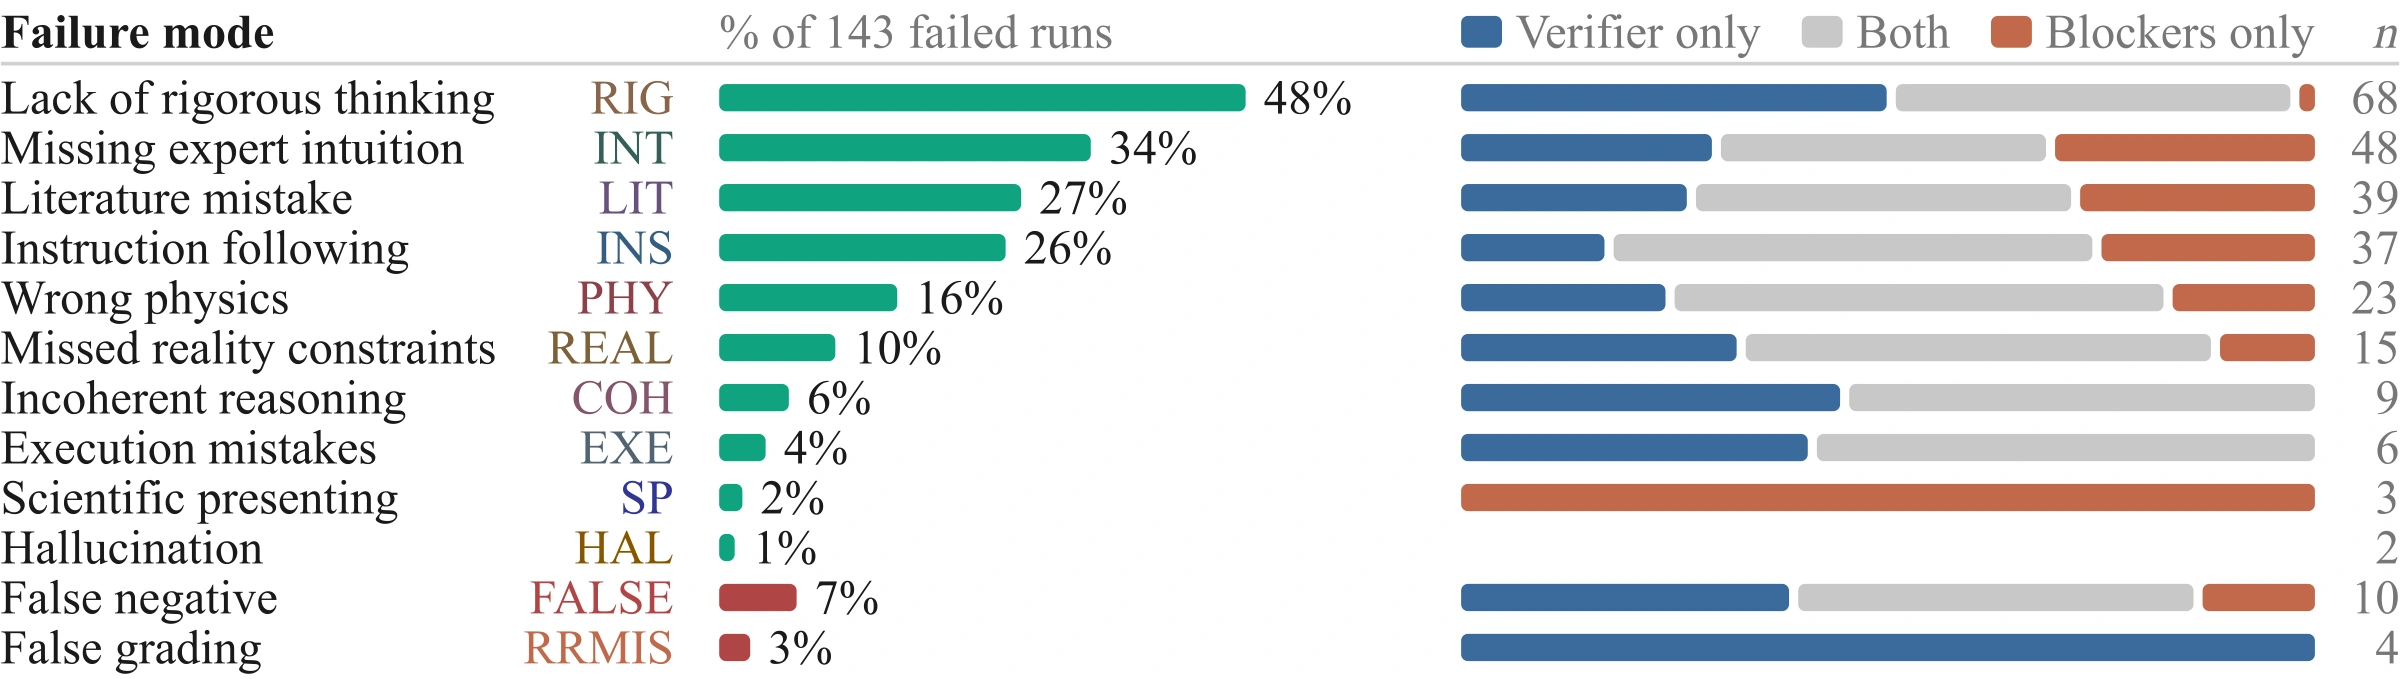
대표적인 문제는 필요한 수렴성 검사를 하지 않거나, 장치의 현실적 제약을 계산에 반영하지 않거나, 찾은 문헌을 주장과 제대로 연결하지 못하는 것이었다.[3][4]
즉, 물리 공식을 알고 코드를 작성하는 능력만으로는 충분하지 않다.
어떤 근사가 정당한지, 추가 검사가 필요한지, 결론을 어디까지 주장할 수 있는지 판단하는 과정이 연구의 병목으로 남는다.
다만 이 분류는 특정 모델·harness와 검토 코호트에 관한 관찰이다.[3]
이를 모든 연구 에이전트에서 ‘물리 지식은 이미 해결됐다’는 일반적 결론으로 넓혀서는 안 된다.
평가기도 틀릴 수 있다
전문가 검토에서는 9회 실행의 최종 실패 판정이 잘못됐다고 판단했다.[3][4]
초기 코호트의 통과 수는 이 오류를 보정하면 25회에서 34회가 된다.[3]
출력에 있던 값을 추출하지 못하거나, 유효한 결과를 검증기·rubric 평가기가 잘못 해석한 사례가 포함된다.[4]
이 수치를 최종 점수표의 GPT-6 Astra xhigh 결과와 직접 합치면 안 된다.[3][4]
초기 감사 코호트, 오류 수정 후 재실행한 결과, 별도의 reviewer 비교 실험은 서로 다른 실행 집합이다.[3][4]
주요 실험의 rubric reviewer는 GPT-5.6 Sol xhigh다.[3][4]
같은 초기 산출물을 Claude Opus 5.5로 다시 채점하면, verifier를 통과한 실행의 판정 일치도와 통과 수가 달라졌다.[4]
특히 Opus 자신의 산출물에 대한 재평가에서는 기본 reviewer보다 더 많은 실행을 통과시켰다.[4]
평가기 선택과 자기 계열 선호 가능성을 확인해야 한다는 근거이지, 어느 쪽 판정이 정답인지 자동으로 결정해 주는 결과는 아니다.
저자 자신의 참고 원고에 rubric을 적용해 얻은 평균 96.2%도 평가기 정확도로 오해하면 안 된다.[3][4]
이는 참고 원고가 있는 33개 과제에서, 그 원고에 적용할 수 있는 원고 수준 평가 항목만 선택한 평균 점수다.[3][4]
부록의 참고 원고 평가에도 blocker를 통과하지 못한 사례가 있다.[4]
전체 연구 실행의 검증기·blocker 통과율이나 인간 전문가와의 96.2% 판정 일치를 뜻하지 않는다.
공개 자료와 실제 재실행은 구분해야 한다
공식 프로젝트 페이지는 리더보드와 벤치마크 소개를 제공한다.[5]
연결된 BenchFlow 저장소는 범용 에이전트 환경·평가 프레임워크이며 Apache-2.0으로 배포된다.[6]
그러나 범용 SDK의 공개와 라이선스만으로 FrontierPhysics의 과제 파일, 평가 자원, 원본 실행 기록까지 같은 조건으로 배포됐다고 볼 수는 없다.
일부 과제 자료는 실제 공개돼 있다.
예를 들어 HADAR 과제의 입력 데이터는 별도 Hugging Face 저장소에서 확인할 수 있다.[7][8]
README에는 재현용 commit revision과 checksum 검증 절차가 적혀 있지만, 이 글에서는 대용량 입력을 내려받아 검증하지 않았다.[7]
또한 해당 과제의 기여 단계 실행 기록에는 trajectory와 채점 결과를 묶은 배포물이 있다.[9][10]
이것은 단일 과제의 사전 실험 자료이지, 논문 전체 본평가의 실행 기록은 아니다.[9]
입력 자료의 Apache-2.0, 실행 기록의 MIT 표시는 각각의 배포물에 관한 metadata다.[7][9]
원본 DARPA 데이터의 distribution statement도 유지하므로, 전체 벤치마크가 하나의 라이선스로 배포됐다고 확대해서는 안 된다.[7][8]
입력 README가 연결한 benchflow-ai/FrontierPhysics는 확인 시점에 공개 조회가 404였고, 전체 56개 과제·평가 자원·본평가 로그를 갖춘 공개 재현 패키지는 확인하지 못했다.[7]
이 응답만으로 비공개·삭제·이동 중 어느 상태인지를 확정할 수는 없다.
이 글은 논문·부록·공식 사이트와 공개 문서를 대조한 정리다.
유료 모델 평가나 sandbox 실행을 재수행하지 않았으며, 성공률은 저자 보고값이다.
자체 실험을 계획한다면 과제와 평가 자원의 배포 위치·버전·이용 조건, 모델 접근 비용, 실행 환경부터 별도로 확인해야 한다.
FrontierPhysics에서 가져갈 실무적 교훈은 ‘연구를 더 오래 시키자’보다 구체적이다.
결과가 실행되는지, 물리적 주장이 정당한지, 평가기가 그 차이를 제대로 판정하는지를 각각 검증해야 한다.
연구 에이전트의 완성도는 그럴듯한 원고 한 편이 아니라, 계산·문헌·논증과 검토 기록이 서로 맞물리는지로 판단할 필요가 있다.