사람의 1인칭 영상에는 방의 구조와 물체의 이동이 함께 담긴다.
하지만 컵이 어디에 놓였는지, 다른 시점에 다시 보인 컵이 같은 물체인지, 어떤 행동 뒤에 상태가 달라졌는지를 학습하려면 영상 이상의 연결된 주석이 필요하다.
Holi-World는 이 경험을 물체 ID·3D 기하·시간별 상태·관찰 근거가 연결된 기록으로 바꾸고, 그 기록에서 학습 데이터를 만드는 생태계다.[2]
2026년 10월 19일 제출된 논문은 Holi-World: Building Holistic World Intelligence from Human-Ego Experience다.[1]
Hao Li 등 연구진의 작업이며, 공식 저장소는 Ropedia, Nanyang Technological University, HKUST, Peking University를 참여 기관으로 명시한다.[4]
핵심은 미래 영상을 생성하는 하나의 세계 모델이라기보다, 촬영 → 자동 주석 → 학습 → 독립 평가를 연결하는 데이터 구축 체계다.[2]
Foundry와 VL은 같은 모델이 아니다
Holi-World는 주석을 만드는 파이프라인과 그 주석으로 학습하는 VLM을 분리한다.[2]
| 구성요소 | 역할 |
|---|---|
| Capture Device | 동기화된 stereo RGB·IMU 기록 |
| Foundry | 정적 3D 물체와 동적 궤적의 자동 주석 |
| Data | 근거가 연결된 기하·의미·QA 학습 자원 |
| VL-4B | 생성된 데이터로 학습한 공간·시간 VLM |
| Bench | 별도 사람이 주석한 held-out 평가 자원 |
Foundry는 visual-inertial SLAM으로 카메라 자세를 얻고, Depth Anything 3와 3D Gaussian Splatting으로 장면 기하와 깊이를 구성한다.[2]
VLM이 추출한 범주·동작·상호작용 단서를 이용해 정적 물체와 동적 추적 대상을 서로 다른 처리 경로로 보낸다.[2]
따라서 “4B 모델이 영상을 받아 모든 3D 주석을 직접 생성한다”는 구조가 아니다.[2]
정적 물체: 여러 검출을 합친 뒤 근거로 검증한다
정적 경로는 두 종류의 검출을 결합한다.[2]
Boxer를 좌우 이미지에 적용하고 깊이·카메라 자세로 2D 검출을 3D로 올리는 경로와, 장면 point cloud에 TR3D를 적용하는 경로다.[2]
이미지는 작은 물체의 단서에, point cloud는 개별 시야를 넘는 큰 물체의 범위에 상호 보완적인 정보를 제공한다.[2]
후보 박스를 공간적으로 병합하고 실제 점의 지지가 부족한 후보를 거른다.[2]
그 뒤 VLM이 원본 관찰과 렌더링된 추가 시점을 보고 유지·기하 수정·범주 수정·거부를 결정한다.[2]
선택 후보가 거부되면 미리 정한 fallback 하나만 그 후보 자신의 근거로 다시 검사하고, 그것도 실패하면 박스를 남기지 않는다.[2]
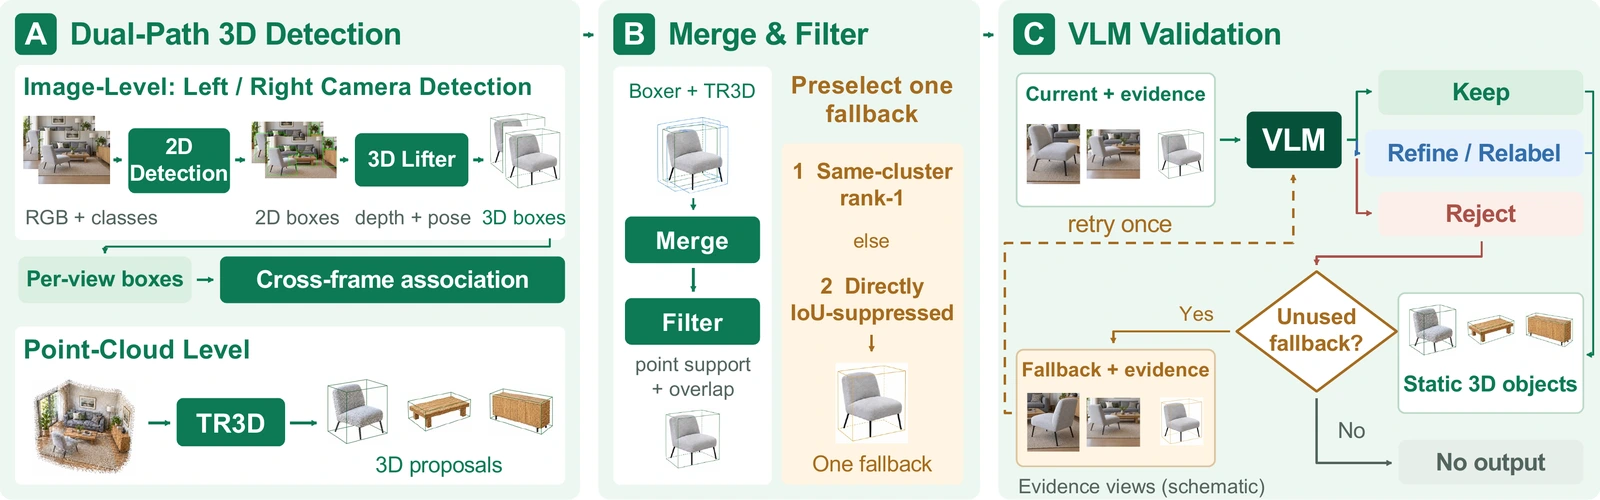
공식 프로젝트의 정적 경로 도식으로, 논문 그림 4에 대응한다.
실제 관측 통계를 그린 결과표가 아니라 입력·중간 상태를 설명하는 개념도다.
원본 영문 표기는 유지했으며 모바일에서는 좌우로 밀거나 눌러 확대할 수 있다.[2][3]
이 검사는 “VLM이 확인했으니 정답”이라는 보증이 아니다.
후보와 연결된 관찰을 보존하고, 잘못된 후보를 버릴 수 있는 제한된 검증 절차를 둔 것이다.
주석의 실제 품질은 별도 인간 정답과 비교해 측정한다.[2]
동적 물체: 같은 ID를 유지하며 움직임을 기록한다
동적 경로는 손 영역과 VLM의 상호작용 설명으로 대상 물체를 찾고, 떨어진 상호작용 구간의 설명·핵심 프레임을 비교해 ID를 연결한다.[2]
같은 대상이 시야에서 사라졌다 다시 나타나도 서로 다른 물체로 쪼개지지 않도록 하는 temporal label continuity가 핵심이다.[2]
그 ID로 SAM 마스크를 선택·초기화하고 구간 안에서 전파한다.[2]
유효한 마스크 픽셀을 깊이·카메라 자세로 world 좌표에 역투영한 뒤, 프레임별 oriented bounding box를 맞추고 같은 ID로 연결해 4D 궤적을 만든다.[2]
여기서 4D는 시간에 따른 3D 물체 상태이며, 미래 상태를 생성하거나 물체의 완전한 mesh를 복원한다는 뜻은 아니다.[2]
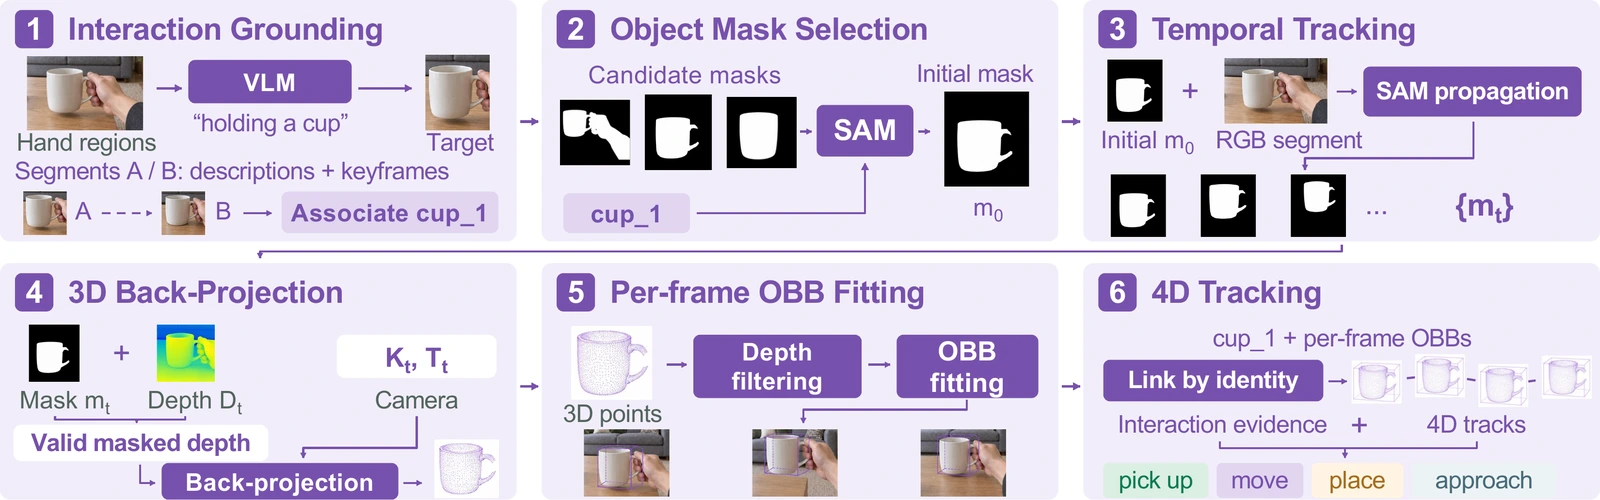
공식 프로젝트의 동적 경로 도식으로 논문 그림 5에 대응한다.
정적·동적 경로의 결과는 공통 좌표·물체 ID·시간·관찰 근거로 연결된다.
모바일에서는 좌우로 밀거나 눌러 확대할 수 있다.[2][3]
중요한 제한은 한 시점에 움직이는 물체가 최대 하나라는 가정이다.[2]
데이터의 동적 감독도 이 가정을 따른다.[2]
따라서 다수 사람이 여러 물체를 동시에 움직이는 장면까지 같은 추적 성능이 유지된다고 일반화할 수 없다.
약 8만 QA는 무엇에서 만들어졌나
공개 설명의 데이터 규모는 약 100개 장면, 444개 ego-video, 132만 2천 RGB 프레임과 대응 깊이·카메라 자세다.[2]
2,466개 정적 3D 박스와 2,095개 동적 track을 비롯한 기록에서 grounding·caption·QA 감독을 만든다.[2]
QA는 정적 13,647개와 동적 64,409개로, 합계 78,056개다.[2]
약 8만 caption은 별도 항목이므로 QA와 같은 개수의 동일 데이터로 취급하면 안 된다.[2]
질문은 정적 공간 관계 11종, 궤적 기반 7종, caption 기반 12종으로 총 30종이며, 각 예시는 물체·시간·원본 관찰과 연결된다.[2]
예를 들어 정적 박스와 카메라 자세로 거리·방향·포함 관계를 만들고, 같은 물체의 시간별 상태로 이동·이벤트 순서·지속 시간을 묻는다.[2]
이 데이터로 Qwen3.5-4B를 fine-tuning한 것이 Holi-World-VL-4B다.[2]
Bench는 학습용 자동 주석을 그대로 정답으로 쓰는 것이 아니라, held-out 촬영에 독립적인 인간 주석을 만들어 Foundry와 VL을 각각 평가한다.[2]
결과 1: 정적 AP와 동적 HOTA는 다른 능력을 측정한다
정적 평가는 ScanNet·ScanNet++·자체 Bench에서 각각 20개 sequence를 사용한다.[2]
AP25·AP50은 3D IoU 0.25·0.50 기준의 검출 지표이며, 값의 범위는 0부터 1이다.[2]
| 평가 대상 | 가장 높은 baseline → Foundry AP50 |
|---|---|
| ScanNet | 0.12 → 0.55 |
| ScanNet++ | 0.05 → 0.13 |
| Holi-World-Bench | 0.07 → 0.12 |
이는 검사한 방법과 해당 sequence 집합에서의 결과다.[2]
matched-box mIoU는 IoU 0.25로 매칭된 박스 쌍만의 평균이므로, 검출을 많이 놓쳐도 일부 잘 맞춘 쌍의 값은 높을 수 있다.[2]
실제로 ScanNet++ mIoU는 M3-Spatial의 0.60이 Foundry의 0.56보다 높아, “모든 정적 지표에서 최고”라고 읽으면 부정확하다.[2]
동적 평가는 ADT20과 자체 Bench의 각 20개 sequence에서 world 중심 거리 0.1 m 허용 오차를 사용한다.[2]
시야 밖 구간도 유효한 GT가 있으면 포함하고, 예측 누락은 실패로 남긴다.[2]
- ADT20 HOTA: IT3DEgo의 36.00%에서 Foundry 54.31%로, 18.31퍼센트포인트 높다.[2]
- 자체 Bench HOTA: SAM+LMK의 15.13%에서 Foundry 43.14%로, 28.01퍼센트포인트 높다.[2]
IT3DEgo와 일부 SAM baseline에는 정답 첫 가시 마스크 기반 초기화가, EgoSeg3D에는 정답 범주 질의가 제공된다.[2]
Foundry는 주석에서 가져온 테스트 입력을 쓰지 않지만, 깊이·카메라 자세·VLM을 사용하는 전체 파이프라인이다.[2]
결과를 “아무 보조 정보도 없는 단일 RGB 모델의 승리”로 바꿔 해석하면 안 된다.
결과 2: 4B가 27B를 넘었다는 말의 조건
아래는 두 benchmark의 Token F1이다. fine-tuning한 4B와 zero-shot 모델의 비교이며, 같은 데이터로 학습한 모델 간의 크기 비교가 아니다.[2]
| 모델 | 자체 Bench / EgoDynamic4D |
|---|---|
| Qwen3.5-4B | 16.35 / 18.29 |
| Qwen3.8-27B, zero-shot | 43.67 / 42.93 |
| Holi-World-VL-4B | 78.02 / 66.39 |
Token F1은 답변 토큰의 겹침을 측정하므로, 78.02를 장면 전체의 이해 성공률로 바꾸면 안 된다.[2]
논문은 yes/no·객관식·수치 정확도도 보고하며, 학습 모델이 두 benchmark의 네 지표 모두에서 두 baseline보다 높은 값을 보인다.[2]
그러나 EgoDynamic4D 수치 정확도는 16.33%에 그쳐, 평균적인 언어 답변 개선과 정밀 수치 추론을 구분해 볼 필요가 있다.[2]
제거 실험과 공개 상태에서 남는 경계
제거 실험은 이미지·point cloud 경로, stereo, caption 단서, VLM 검증, ID 연속성과 SAM 연결을 나눠 살펴본다.[2]
다만 VLM 검증을 뺀 S5와 전체 S6의 ScanNet AP25·mIoU는 모두 0.68 / 0.72로 같다.[2]
자체 Bench의 mIoU도 0.52 → 0.53의 작은 차이이므로, 이 표만으로 VLM 검증이 큰 기하 정확도 상승의 원인이라고 주장하기는 어렵다.[2]
논문은 범주 수정·부적절한 후보 제거 같은 의미 주석의 보완 역할도 함께 제시한다.[2]
배포 상태는 더욱 명확히 구분해야 한다.
2026년 10월 22일 확인한 공식 README는 코드를 오픈소스로 공개하지 않겠다고 명시한다.[4]
모델과 데이터는 Hugging Face 공개 예정이지만, 조회한 두 저장소에는 .gitattributes만 있고 가중치·데이터 파일이 없다.[5][6]
GitHub 링크나 다운로드 통계만으로 실행 가능한 파이프라인이 배포됐다고 볼 수 없다.
따라서 이 글은 논문·공식 자료의 보고 결과를 검토한 것이며, 공개 코드와 모델로 독립 재현한 결과는 아니다.
주석 생성 비용과 처리 속도, 모델 학습·추론의 구체적인 재현 가능성도 실제 배포 자료가 나온 뒤 추가 검증해야 한다.
Holi-World의 의미는 사람이 경험한 영상을 그냥 더 모으는 것이 아니라, 같은 물체와 같은 사건을 기하·의미·관찰 근거로 연결해 감독 신호를 만든다는 데 있다.
다만 자동 주석의 오류가 학습 데이터로 전파될 수 있으므로, 독립 인간 평가와 실패 사례의 추적 경로를 유지하는 것이 중요하다.
논문도 동의에 기반한 수집, 식별 정보 검토·삭제, 라이선스 준수와 비동의 감시 방지를 책임 있는 사용 조건으로 제시한다.[2]