머리에 단 카메라로 컵을 옮기는 장면을 찍으면, 영상 속 움직임에는 손·컵의 이동과 촬영자의 이동이 섞인다.
손 모양과 물체 자세를 각각 그럴듯하게 복원해도, 좌표계나 크기가 맞지 않으면 같은 공간에서 일어난 행동으로 연결하기 어렵다.
EgoXperience는 이 문제를 데이터 수집·주석·모델·벤치마크를 함께 만드는 방식으로 다룬다.[2]
2026년 10월 19일 제출된 논문은 EgoXperience: Learning World-Grounded Egocentric Representations from Human Experience다.[1]
Xinhao Ji 등 연구진의 작업이며, 공식 저장소는 Ropedia, Nanyang Technological University, Tsinghua University, Peking University를 참여 기관으로 명시한다.[4]
핵심 모델 EgoX는 단안 RGB 관찰과 대상 물체의 첫 프레임 마스크로 카메라·깊이·손·물체를 한 번의 forward pass에서 공동 복원한다.[2]
이는 로봇의 행동 정책이나 미래 영상을 생성하는 세계 모델이 아니다.[2]
관찰된 사람의 행동을 같은 미터 단위 공간에 놓인 기하 표현으로 복원하는 연구이며, 현재 물체 표현은 강체 자세를 대상으로 한다.[2]
모델만이 아니라 감독 신호까지 맞춘다
EgoXperience의 네 구성요소는 서로 다른 역할을 맡는다.[2]
| 구성요소 | 역할 |
|---|---|
| EgoX-Engine | 촬영 결과를 정렬된 기하 주석으로 변환 |
| EgoX-Data-6M | 조작·이동을 담은 50시간 데이터 |
| EgoX-Bench | 공동 복원을 평가하는 held-out 1시간 |
| EgoX | 카메라·깊이·손·물체의 공동 복원 모델 |
데이터는 101개 강체 물체와 270개 작업 스크립트를 포함하며, 한 작업대에서의 조작뿐 아니라 방 사이 이동과 야외 이동·조작도 다룬다.[2]
공식 프로젝트가 제시하는 실제 프레임 수는 약 540만 장이므로, 이름의 6M을 정확히 600만 장이라는 통계로 바꿔 쓰면 안 된다.[3]
초 단위 작업 캡션과 손·물체·카메라·깊이의 정렬된 주석을 함께 제공하는 것이 데이터 설계의 중심이다.[2]
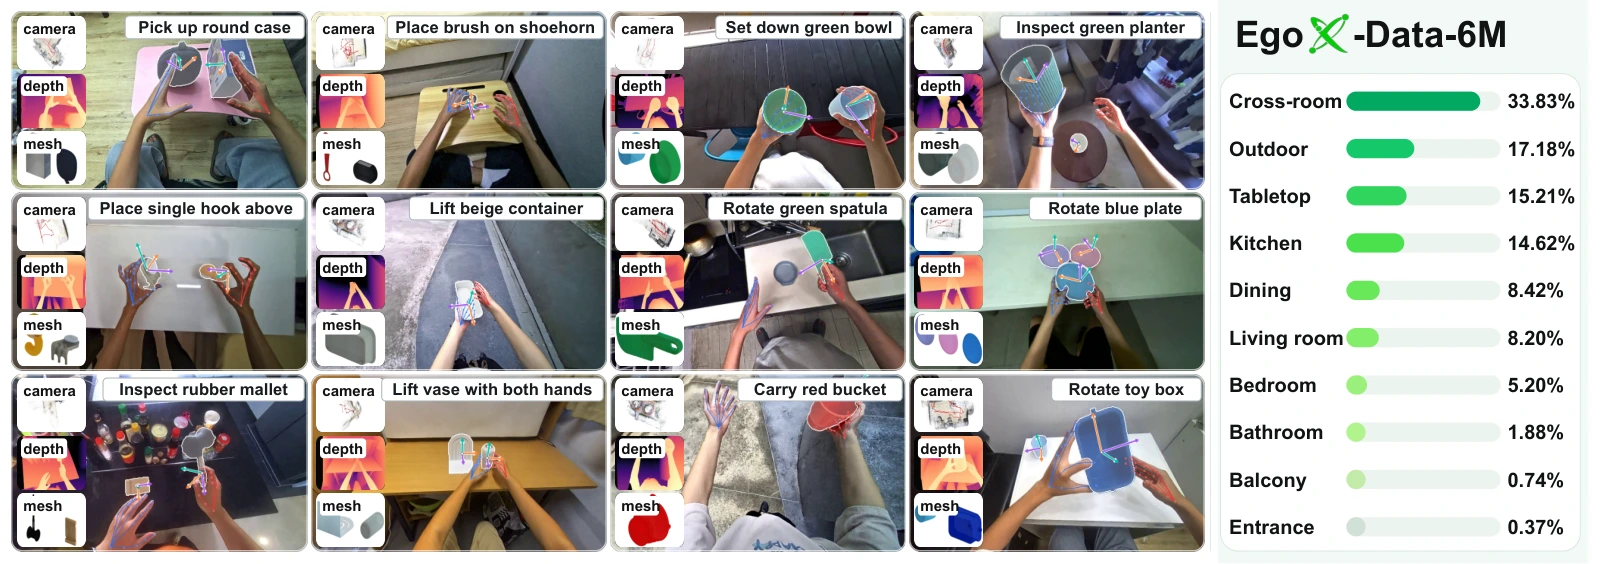
논문 그림 2.
여러 환경의 조작과 함께 제공하는 기하 주석을 보여준다.
원본 영문 표기를 유지했으며, 모바일에서는 좌우로 밀거나 눌러 확대할 수 있다.[2]
학습 데이터 전체를 이 50시간과 동일시해서도 안 된다.
EgoX는 공개 상호작용 데이터와 실제·합성 장면 데이터를 더한 약 280시간의 풀을 사용한다.[2]
각 데이터셋의 좌표·스케일 규약을 맞추고, 해당 샘플에 존재하는 주석에 대해서만 손실을 적용한다.[2]
없는 주석을 부정 라벨로 취급하지 않는 방식이다.[2]
단안 추론과 주석 생성 장비는 다르다
모델 입력은 단안 영상이지만, 감독 신호를 만드는 수집 과정은 단안만으로 끝나지 않는다.
EgoX-Engine은 HOMIE Gen2의 보정된 전방 stereo로 미터 단위 깊이를 얻고, 네 fisheye 카메라의 SLAM으로 세션 좌표계를 만든다.[2]
물체의 기하 기준도 미리 준비한다.[2]
31대의 동기화 카메라가 있는 dome에서 물체 mesh를 복원하고, AprilTag 보드로 실제 크기를 맞춘다.[2]
첫 프레임 마스크와 추적할 상호작용 구간을 정한 뒤, FoundationPose 기반 물체 궤적을 관측 깊이와 대조해 검증한다.[2]
손은 여러 시점의 3D 관절 삼각측량과 MANO fitting으로 주석화한다.[2]
마지막으로 카메라 상대 좌표의 손·물체·장면을 SLAM 기반 세션 좌표계로 변환해 서로 맞춘다.[2]
따라서 자동 주석 엔진이라는 표현은 물체 사전 스캔이나 초기 대상 지정까지 필요 없는 완전 무인 수집을 뜻하지 않는다.[2]
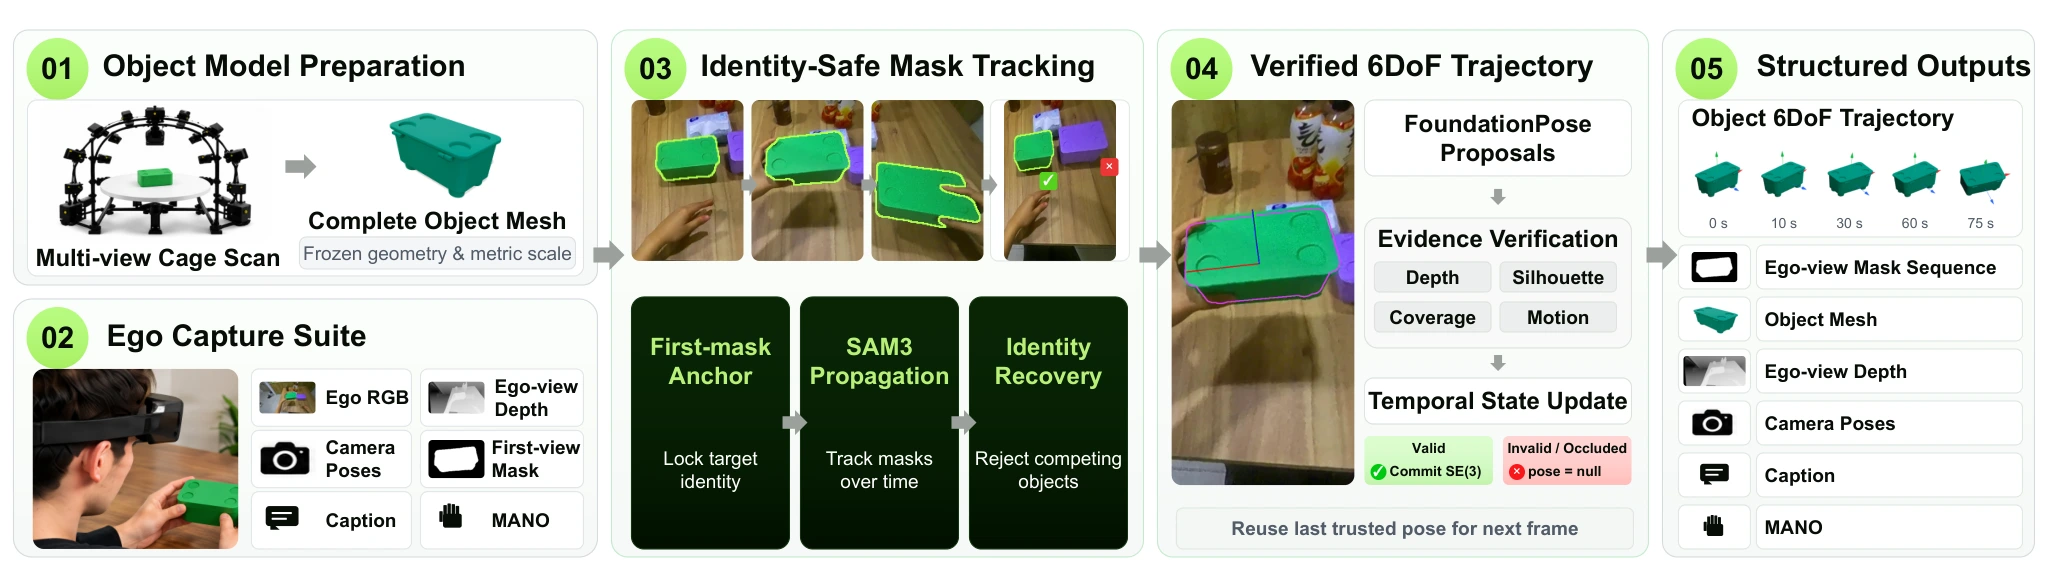
논문 그림 3.
주석을 만드는 단계의 장비와 검증 절차다.
이 센서·mesh 요구를 EgoX 추론 시의 필수 입력으로 혼동하면 안 된다.
모바일에서는 좌우로 밀거나 눌러 확대할 수 있다.[2]
EgoX는 무엇을 공동으로 예측하는가
EgoX는 DINOv3 이미지 특징과 카메라·손·물체 토큰을 공유 Transformer에서 결합한다.[2]
물체는 첫 프레임 마스크의 특징으로 대상 정체성을 연결하고, 여러 관찰 사이의 attention으로 기하 정보를 교환한다.[2]
입력 마스크가 없는 보조 학습 데이터에서는 카메라·장면·손만 복원하므로, “마스크가 선택적”이라는 말이 마스크 없이도 임의 물체 자세를 모두 추론한다는 뜻은 아니다.[2]
각 head는 카메라 내부·외부 파라미터, 깊이, 두 손의 MANO 상태, 물체 위치·방향과 공통 scale을 예측한다.[2]
카메라 예측으로 손·물체·장면을 같은 기준계에 배치하고, ScaleHead의 양수 계수로 깊이와 위치를 일관되게 미터 단위로 변환한다.[2]
이때 모델의 공통 기준계는 첫 프레임 카메라 좌표계이며, 지도나 GPS에 연결된 전역 좌표계를 보장하는 것은 아니다.[2]
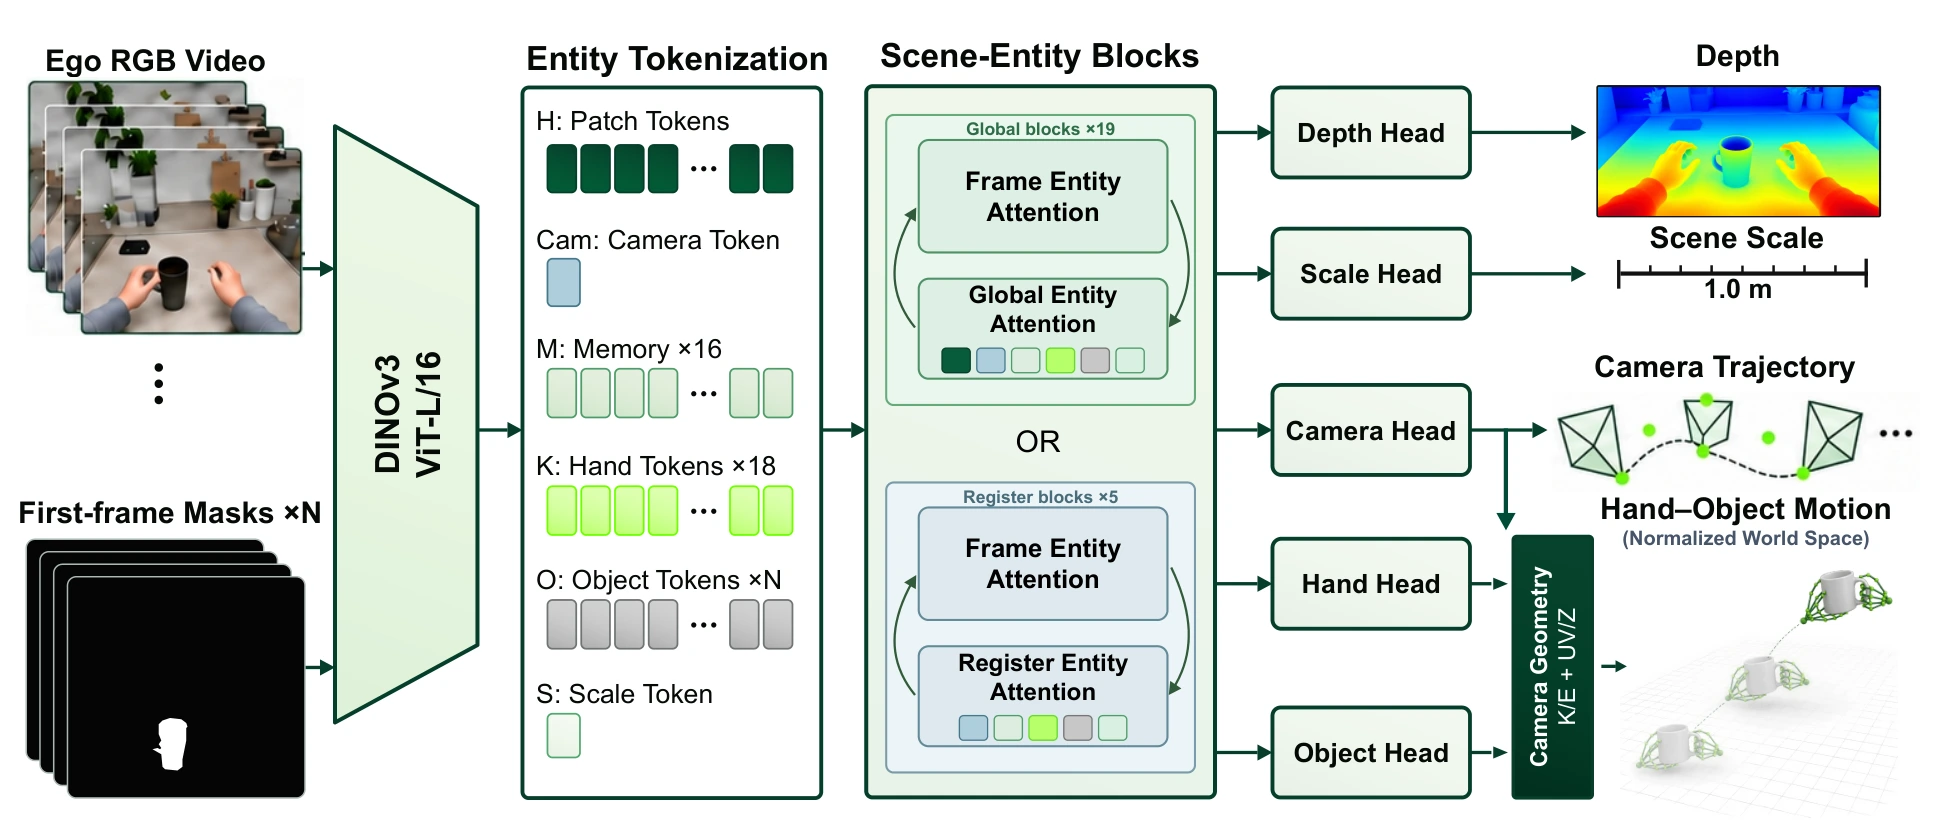
논문 그림 4.
단순히 출력 종류를 늘린 것이 아니라, 예측 카메라를 통해 손·물체 기하를 결합한다.
원본 영문 표기는 유지했으며 모바일에서는 좌우로 밀거나 눌러 확대할 수 있다.[2]
학습에서도 각 출력의 개별 오차만 최소화하지 않는다.[2]
예측 카메라로 변환한 손·물체의 공동 기하를 정답과 비교하고, 그 오차가 카메라 변환을 통해 역전파되게 한다.[2]
이 구조는 “손은 잘 맞지만 세계 안에서 엉뚱한 위치에 뜬다”는 문제를 카메라와 개체의 연결된 문제로 다루려는 설계다.[2]
평가 조건: 같은 영상이지만 추가 입력까지 같지는 않다
평가는 HOT3D, EgoX-Bench, HOI4D, H2O에서 동일한 150개 관찰 clip을 사용하며, 평가 sequence는 EgoX 학습에서 제외한다.[2]
주요 비교에서 어떤 방법에도 정답 카메라나 정답 scale을 재구성 입력으로 제공하지 않는다.[2]
다만 방법별 필수 입력은 다르다.[2]
EgoX는 RGB와 첫 마스크를 쓰는 반면, 물체 자세 baseline은 추정 깊이·카메라 내부 파라미터, 프레임별 마스크, 실제 크기의 CAD 자산을 추가로 사용할 수 있다.[2]
VGGT와 VGGT-Ω의 scale도 정답이 아니라 DA3 Nested의 깊이에 맞춰 sequence당 하나를 추정하는 조건이다.[2]
손의 world-space 오차와 물체 자세 점수는 같은 좌표계의 평가가 아니다.
손은 각 방법이 추정한 카메라 궤적으로 world-space 위치를 평가하지만, 주요 물체 자세 평가는 camera-frame에서 수행한다.[2]
공통 world-space 복원 구조를 제안했다는 사실과, 모든 수치가 world-space 정확도를 직접 측정한다는 주장은 구분해야 한다.
초록의 네 개선율은 서로 다른 조건에서 나온다
아래는 논문이 강조한 결과를 데이터셋·지표와 함께 풀어 쓴 것이다.[2]
오차 감소는 상대 감소율이며, 물체 AUC의 향상도 상대 증가율이다.[2]
- 카메라, HOI4D: nATE가 VGGT-Ω의
0.0212에서 EgoX의0.0066으로 감소했다. 상대 감소율은 약 68.9%다.[2] - 손, EgoX-Bench: W-MPJPE가 WiLoR + SLAM의
328.81 mm에서113.24 mm로 낮아졌다. 약 65.6% 감소다.[2] - 깊이, EgoX-Bench: AbsRel이 VGGT-Ω의
0.0806에서0.0460으로 감소했다. 약 42.9% 감소다.[2] - 물체, HOT3D: AUC-S50이 GigaPose + MegaPose의
57.59에서73.71로 올랐다. 상대 증가율 약 28.0%이며, 절대 차이는 16.12퍼센트포인트다.[2]
이 네 수치를 하나의 데이터셋에서 모든 구성요소가 같은 비율로 좋아진 결과처럼 묶으면 안 된다.
카메라도 모든 benchmark에서 최고는 아니다.[2]
VGGT-Ω는 HOT3D·EgoX-Bench에서, DA3 Nested는 H2O에서 더 낮은 nATE를 보인다.[2]
반면 논문 표에서는 손의 세 지표, 물체의 ADD·ADD-S·AUC-S50, 깊이의 AbsRel·임계값 정확도에서 네 benchmark 모두 가장 좋은 값을 보고한다.[2]
이는 평가한 방법과 해당 프로토콜 안에서의 결과이지, 임의의 1인칭 영상에서 같은 개선을 보장하는 수치는 아니다.
제거 실험과 속도에서 확인되는 범위
HOT3D 제거 실험은 공동 학습에서 깊이와 scale 예측의 역할을 살펴본다.[2]
| 설정 | 손 W-MPJPE / 물체 AUC |
|---|---|
| 전체 모델 | 38.89 mm / 73.71 |
| ScaleHead 제거, oracle scale 사용 | 40.67 mm / 60.87 |
| DepthHead 제거, 예측 scale 사용 | 67.53 mm / 41.09 |
ScaleHead 제거 실험은 oracle scale이라는 유리한 조건을 주어도 전체 모델보다 낮은 결과다.[2]
DepthHead 제거 때 손·물체 결과도 악화되는 것은 깊이 학습이 공유 표현에 기여함을 뒷받침한다.[2]
다만 두 실험의 scale 조건이 다르므로 오차 차이를 독립적인 기여도처럼 더할 수는 없다.
한 번의 forward pass라는 표현을 실시간 스트리밍과 동일시할 수도 없다.[2]
부록의 NVIDIA A800 한 장 기준 실행 시간은 150프레임에 14.60초, 10.28 FPS다.[2]
모델·재사용 자산은 미리 적재하고 데이터 로딩·시각화·디스크 I/O를 제외했으며, MINT의 8.30초보다 빠른 것도 아니다.
출력 범위와 처리 단위를 함께 봐야 한다.[2]
공개 상태와 실무적 의미
2026년 10월 22일 확인한 GitHub는 소개·이미지·데모 위주이며, 코드 공개는 아직 예정으로 표시한다.[4]
Hugging Face의 EgoX, EgoX-Data-6M, EgoX-Bench도 각각 가중치·데이터·평가 도구를 coming soon으로 안내한다.[5][6][7]
각 저장소 파일 목록도 .gitattributes와 README뿐이어서, 페이지가 존재한다는 사실을 가중치와 데이터 배포 완료로 볼 수 없다.
따라서 이 글의 성능은 논문 보고치를 검토한 것이며 공개 checkpoint로 독립 재현한 결과는 아니다.
확인한 GitHub에는 LICENSE 파일이 없다.[4]
HF 카드에도 명시적 license 항목이 없으므로, 향후 코드·데이터·모델의 이용 조건을 별도로 확인해야 한다.[5][6][7]
현재 모델은 강체 물체를 가정하고 물체 mesh 자체를 예측하지 않는다.[2]
50시간의 데이터에 물체 mesh 주석이 있다는 사실과 모델이 새로운 물체의 완전한 형상을 생성한다는 주장은 다르다.
천·연성 물체나 관절 물체까지 복원한다는 근거도 이 결과에서 나오지 않는다.[2]
EgoXperience의 의미는 단안 영상에서 모든 것을 공짜로 알아낸다는 데 있지 않다.
복잡한 수집·정렬 과정으로 만든 감독 신호를 이용해, 추론 시 손·물체·카메라를 따로 맞추던 절차를 공동 예측으로 옮겼다는 데 있다.
로봇 학습이나 사람 행동 분석에 활용하려면 이 기하 복원 뒤에 행동 표현·정책 학습·안전 검증을 별도로 설계해야 한다.