카카오가 2026년 10월 21일 공개한 Kanana-2-vision-encoder는 한국어 문서와 고해상도 이미지에 초점을 둔 비전 인코더다.[1]
공개 모델은 Medium(426M)과 Tiny(98M) 두 종류다.[3]
Large·Small까지 모두 배포한 것은 아니다.[2]
출발점은 의외로 언어모델이다.
카카오는 외부 비전 인코더의 가중치 대신 Kanana-2 LLM의 가중치와 구조를 활용해 이미지 특징을 학습하고, 큰 모델을 프루닝·증류해 작은 인코더를 만든다.[2]
“자체 개발”을 모든 파라미터의 무작위 초기화와 혼동하면 안 되는 이유다.[2]
또 하나의 중요한 경계는 공개 파일이 문장을 생성하는 완성형 VLM은 아니라는 것이다.
모델 카드는 텍스트 생성 모듈을 제외한 image-feature-extraction 전용 모델이라고 명시한다.[3]
개발기에 나온 캡션 생성 과정과 다운로드한 인코더의 기능을 구분해야 한다.[2][3]
무엇이 공개됐고, 무엇을 더 붙여야 하나
공개 모델은 이미지를 patch 특징으로 변환한다.[3]
언어 답변을 얻으려면 이 특징을 처리할 projector 또는 patch merger와 언어모델을 결합하고, 목적에 맞는 VLM 학습이 필요하다.[3]
| 공개 모델 | 공식 규모 / 특징 차원 |
|---|---|
| Medium | 약 426M / 768 |
| Tiny | 약 98M / 512 |
모델 카드의 예제도 AutoModel에서 last_hidden_state를 받아 (total_patches, feature_dim) 형태의 특징을 확인하는 흐름이다.[3][4]
LLM용 generate()로 사진 설명을 바로 얻는 배포가 아니므로, 독립적인 OCR 앱이나 채팅 모델을 찾는 경우에는 추가 통합 비용이 생긴다.[3]
한국어 문서 VLM을 직접 학습하거나 기존 시각 모듈을 교체하려는 팀에는 후보가 될 수 있다.
반면 Tiny가 작다는 이유만으로 전체 문서 질의응답 시스템이 1억 파라미터에 끝나거나 모든 모바일 기기에서 즉시 실행된다고 볼 수는 없다.
긴 이미지 설명을 예측하며 시각 특징을 학습한다
학습은 GenLIP 계열의 생성형 접근을 따른다.[2]
이미지 patch와 텍스트 토큰을 하나의 Unified Transformer에 입력하고, 이미지의 자세한 설명을 다음 토큰 예측으로 학습한다.[2]
메뉴판의 글자·가격·색상·배치까지 맞혀야 하는 dense visual caption을 구성해, 손실을 줄이려면 작은 시각 단서를 읽어야 하도록 만든다.[2]
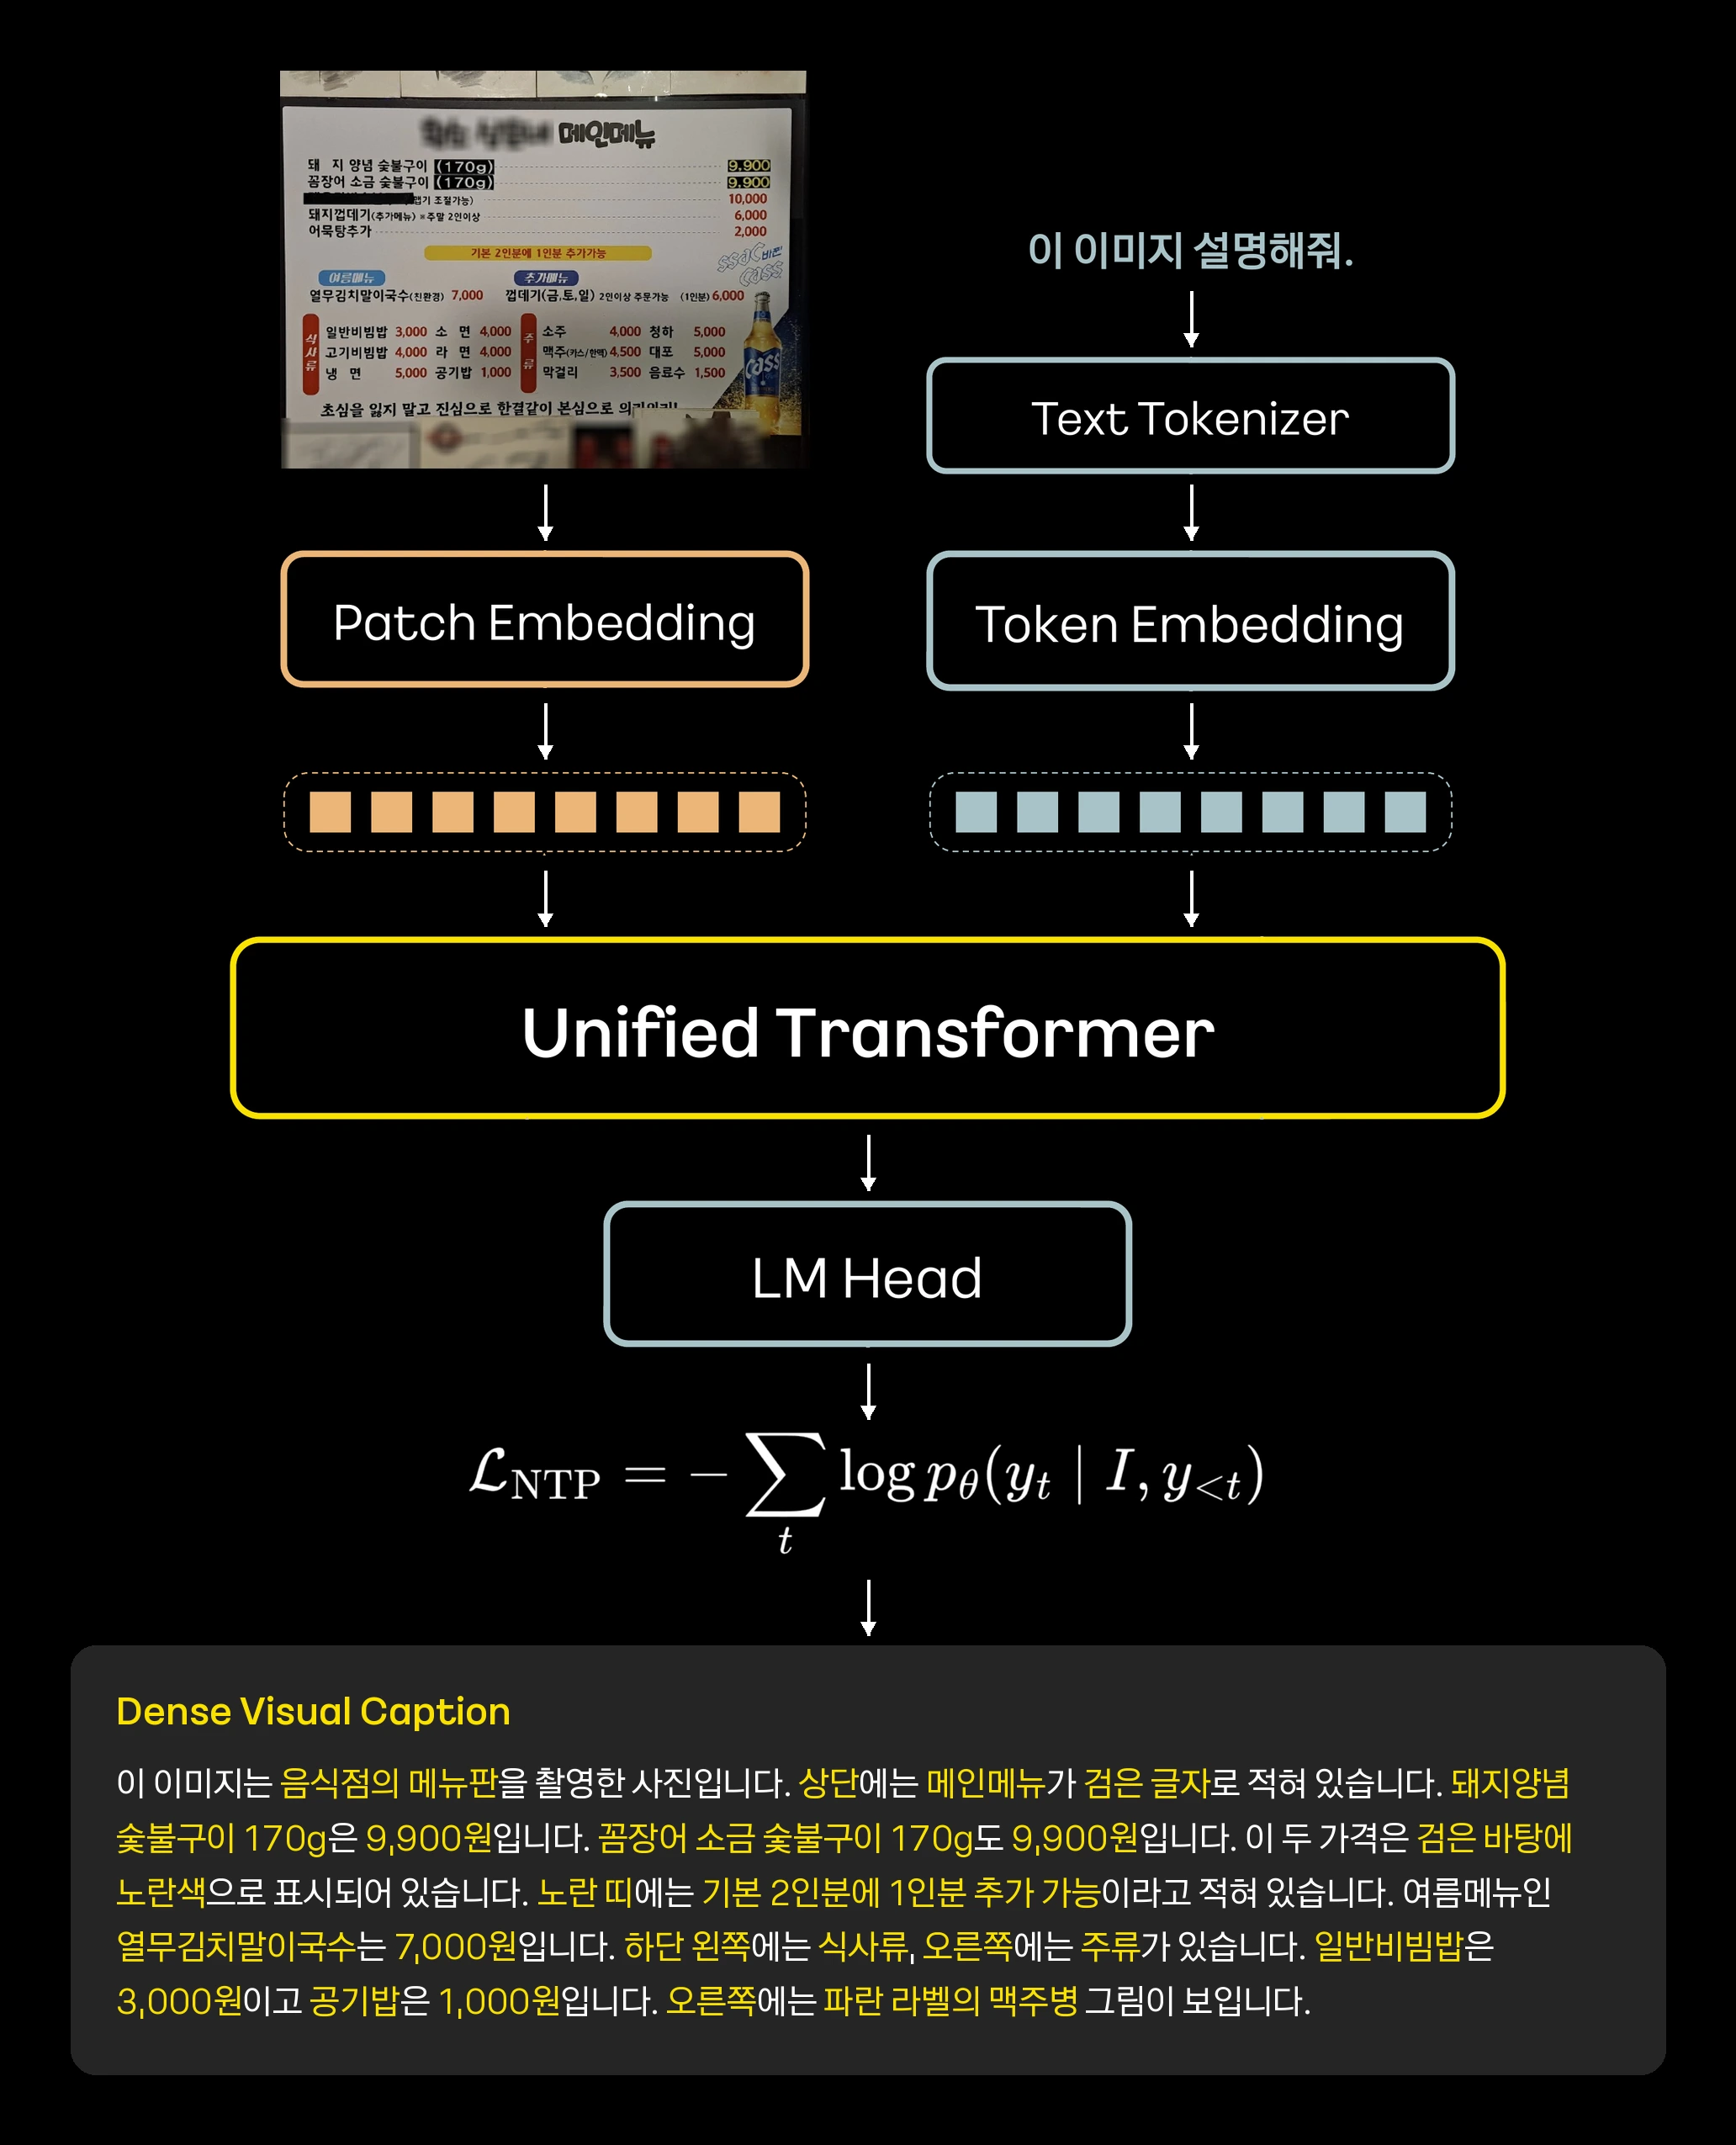
카카오 개발기 그림 2.
학습 시의 생성 구조이며, 공개 가중치에 텍스트 생성 모듈이 함께 들어 있다는 뜻은 아니다.
원본의 AI Hub 이미지 출처 표기를 따르며 모바일에서는 눌러 확대할 수 있다.[2][3]
Unified Transformer는 이미 문장 생성 능력이 있는 Kanana-2 LLM에서 초기화한다.[2]
개발기는 무작위 초기화와 비교해 비슷한 다음 토큰 예측 손실에 도달하는 학습 단계가 약 4분의 1로 줄었다고 보고한다.[2]
이는 해당 학습 곡선의 비교이지, 데이터 구축·교사 학습·전체 GPU 비용이 모두 4분의 1이라는 측정은 아니다.
학습은 세 단계로 해상도를 높이며 전 파라미터를 업데이트한다.[2]
| 단계 | 이미지 처리 |
|---|---|
| 1 | 224×224 고정 해상도 |
| 2 | 원본 비율 유지, 최대 640² |
| 3 | 원본 비율 유지, 최대 1280² |
SWA와 GQA는 고해상도에서 무엇을 줄이는가
구조적으로는 Sliding Window Attention과 Grouped Query Attention을 사용한다.[2]
SWA 층은 주변 토큰 범위로 attention을 제한하고, 일부 full-attention 층은 이미지 전체의 정보를 연결한다.[2]
GQA는 여러 query head가 key·value를 공유하도록 해 projection 연산과 관련 저장량을 줄인다.[2]
전체가 local attention만으로 구성된 것은 아니다.
Medium 설정 파일도 sliding_attention과 full_attention을 섞고 sliding_window를 1024로 지정한다.[6]
따라서 SWA 층의 계산 특성을 모델 전체가 모든 해상도에서 선형으로 실행된다는 보장으로 확대하면 안 된다.
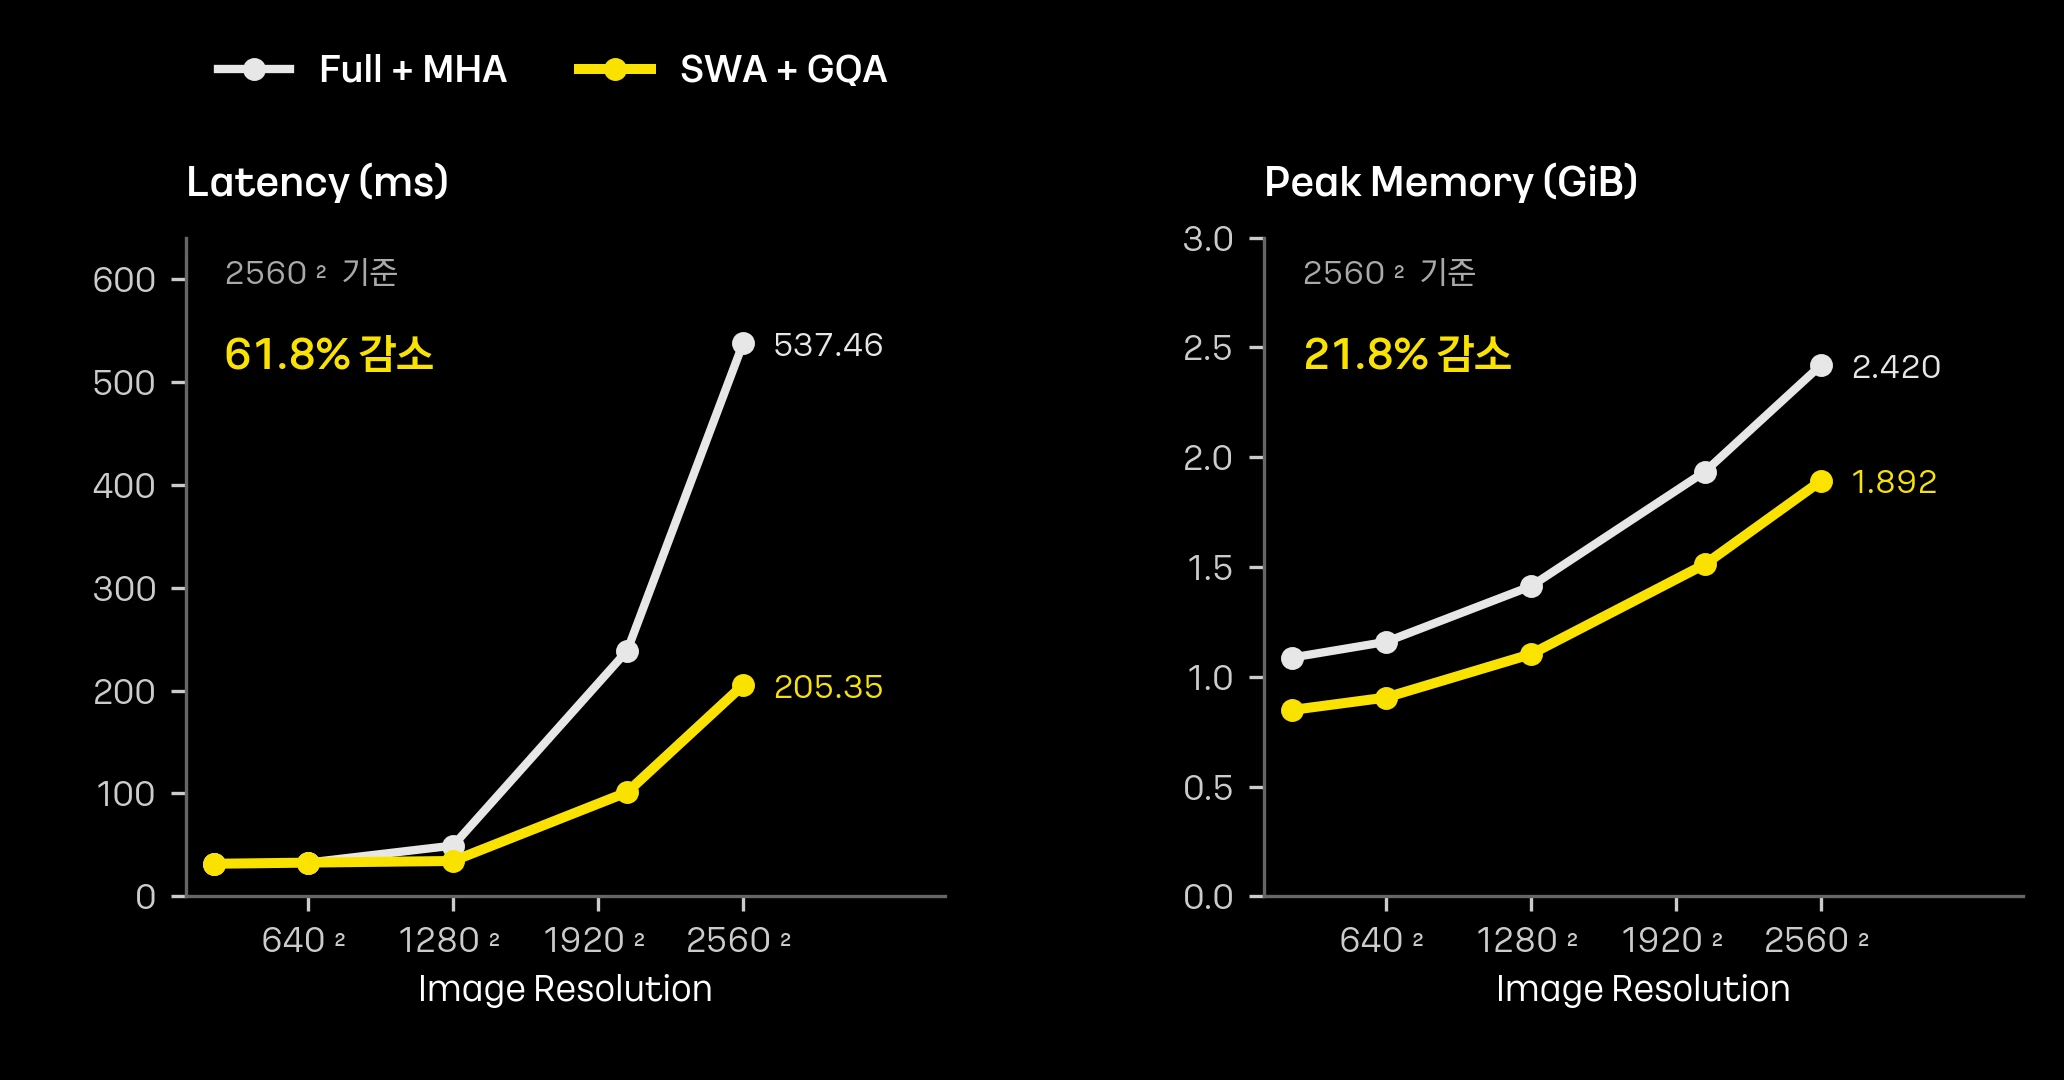
개발기 그림 7.
비교선은 Full + MHA와 SWA + GQA다.
다른 회사의 모든 인코더나 완성형 VLM 서비스의 전체 지연 시간을 직접 비교한 그래프가 아니다.
모바일에서는 눌러 확대할 수 있다.[2]
2560×2560 입력에서 공식 그래프는 지연 시간 61.8%, peak memory 21.8% 감소를 보고한다.[2]
보도자료의 “60% 이상 감소”를 해석할 때는 이 구조 비교 조건을 함께 봐야 한다.[1][2]
하드웨어·attention backend·입력 크기·전처리가 달라지면 실제 절감 폭도 다시 측정해야 한다.
공개 구현의 기본 attention은 PyTorch SDPA이며 FlashAttention 2는 선택 사항이다.[7]
모델 카드를 따라 기본 로딩했다고 개발기의 성능 그래프와 동일한 실행 환경이 자동 재현되는 것은 아니다.[3][7]
작은 모델은 프루닝 뒤에 두 종류의 증류를 받는다
Large를 줄일 때는 층 수, 내부 차원, attention head, FFN의 네 축을 조정한다.[2]
층 제거는 교사와의 KL 변화, 내부 차원은 activation의 PCA, head·FFN은 activation 중요도를 참고하며 GQA 그룹 구조를 보존한다.[2]
이후 작은 student의 전체 어휘 다음 토큰 분포를 Large teacher에 가깝게 만드는 Full-Vocabulary KL 증류를 수행한다.[2]
정답 토큰 하나의 확률만 높이는 것과 달리, 비슷한 색·표현 사이의 관계도 교사의 분포에서 학습 신호로 받는다.[2]
Tiny에는 on-policy distillation을 추가한다.[2]
Tiny가 실제 생성한 prefix를 Large에도 보여주고 다음 토큰 분포 차이로 교정하므로, student가 스스로 들어간 오류 문맥에서 학습하게 된다.[2]
메뉴 가격이나 작은 연도 문자를 바로잡은 개발기의 예시는 이 과정을 설명하는 사례이며, 모든 OCR 오류가 없어졌다는 증거는 아니다.
42개 benchmark를 인코더 단독 점수로 읽으면 안 된다
모든 비교는 같은 Kanana-2-1.3b-instruct와 patch merger를 사용한 VLM에서, 비전 인코더를 바꾸고 동일한 조건으로 학습·평가한 결과다.[3]
인코더에서 바로 나온 OCR 정답률도, 각 비교 회사가 배포한 원래 완성형 VLM끼리의 비교도 아니다.[3]
42개 benchmark는 9개 영역으로 묶이며, 최종 평균은 영역별 동일 가중치를 준다.[3]
42개 점수를 그대로 한 번에 평균한 값과도 다르다.[3]
| 인코더 | 9개 영역 평균 |
|---|---|
| Kanana-2 Medium | 55.62 |
| Kanana-2 Tiny | 51.81 |
| PE-Lang-L14-448, Medium 비교군 | 51.54 |
| Qwen3.5-0.8B의 ViT, Tiny 비교군 | 49.62 |
개발기는 두 모델이 각 규모 비교에서 9개 중 8개 영역 선두라고 소개하지만, 개별 benchmark 전체에서 최고라는 뜻은 아니다.[2]
예를 들어 Medium의 MMBench EN은 58.42로 SigLIP 2의 61.00보다 낮고, Tiny의 KoPDFBench는 51.64로 비교 Qwen ViT의 53.87보다 낮다.[3]
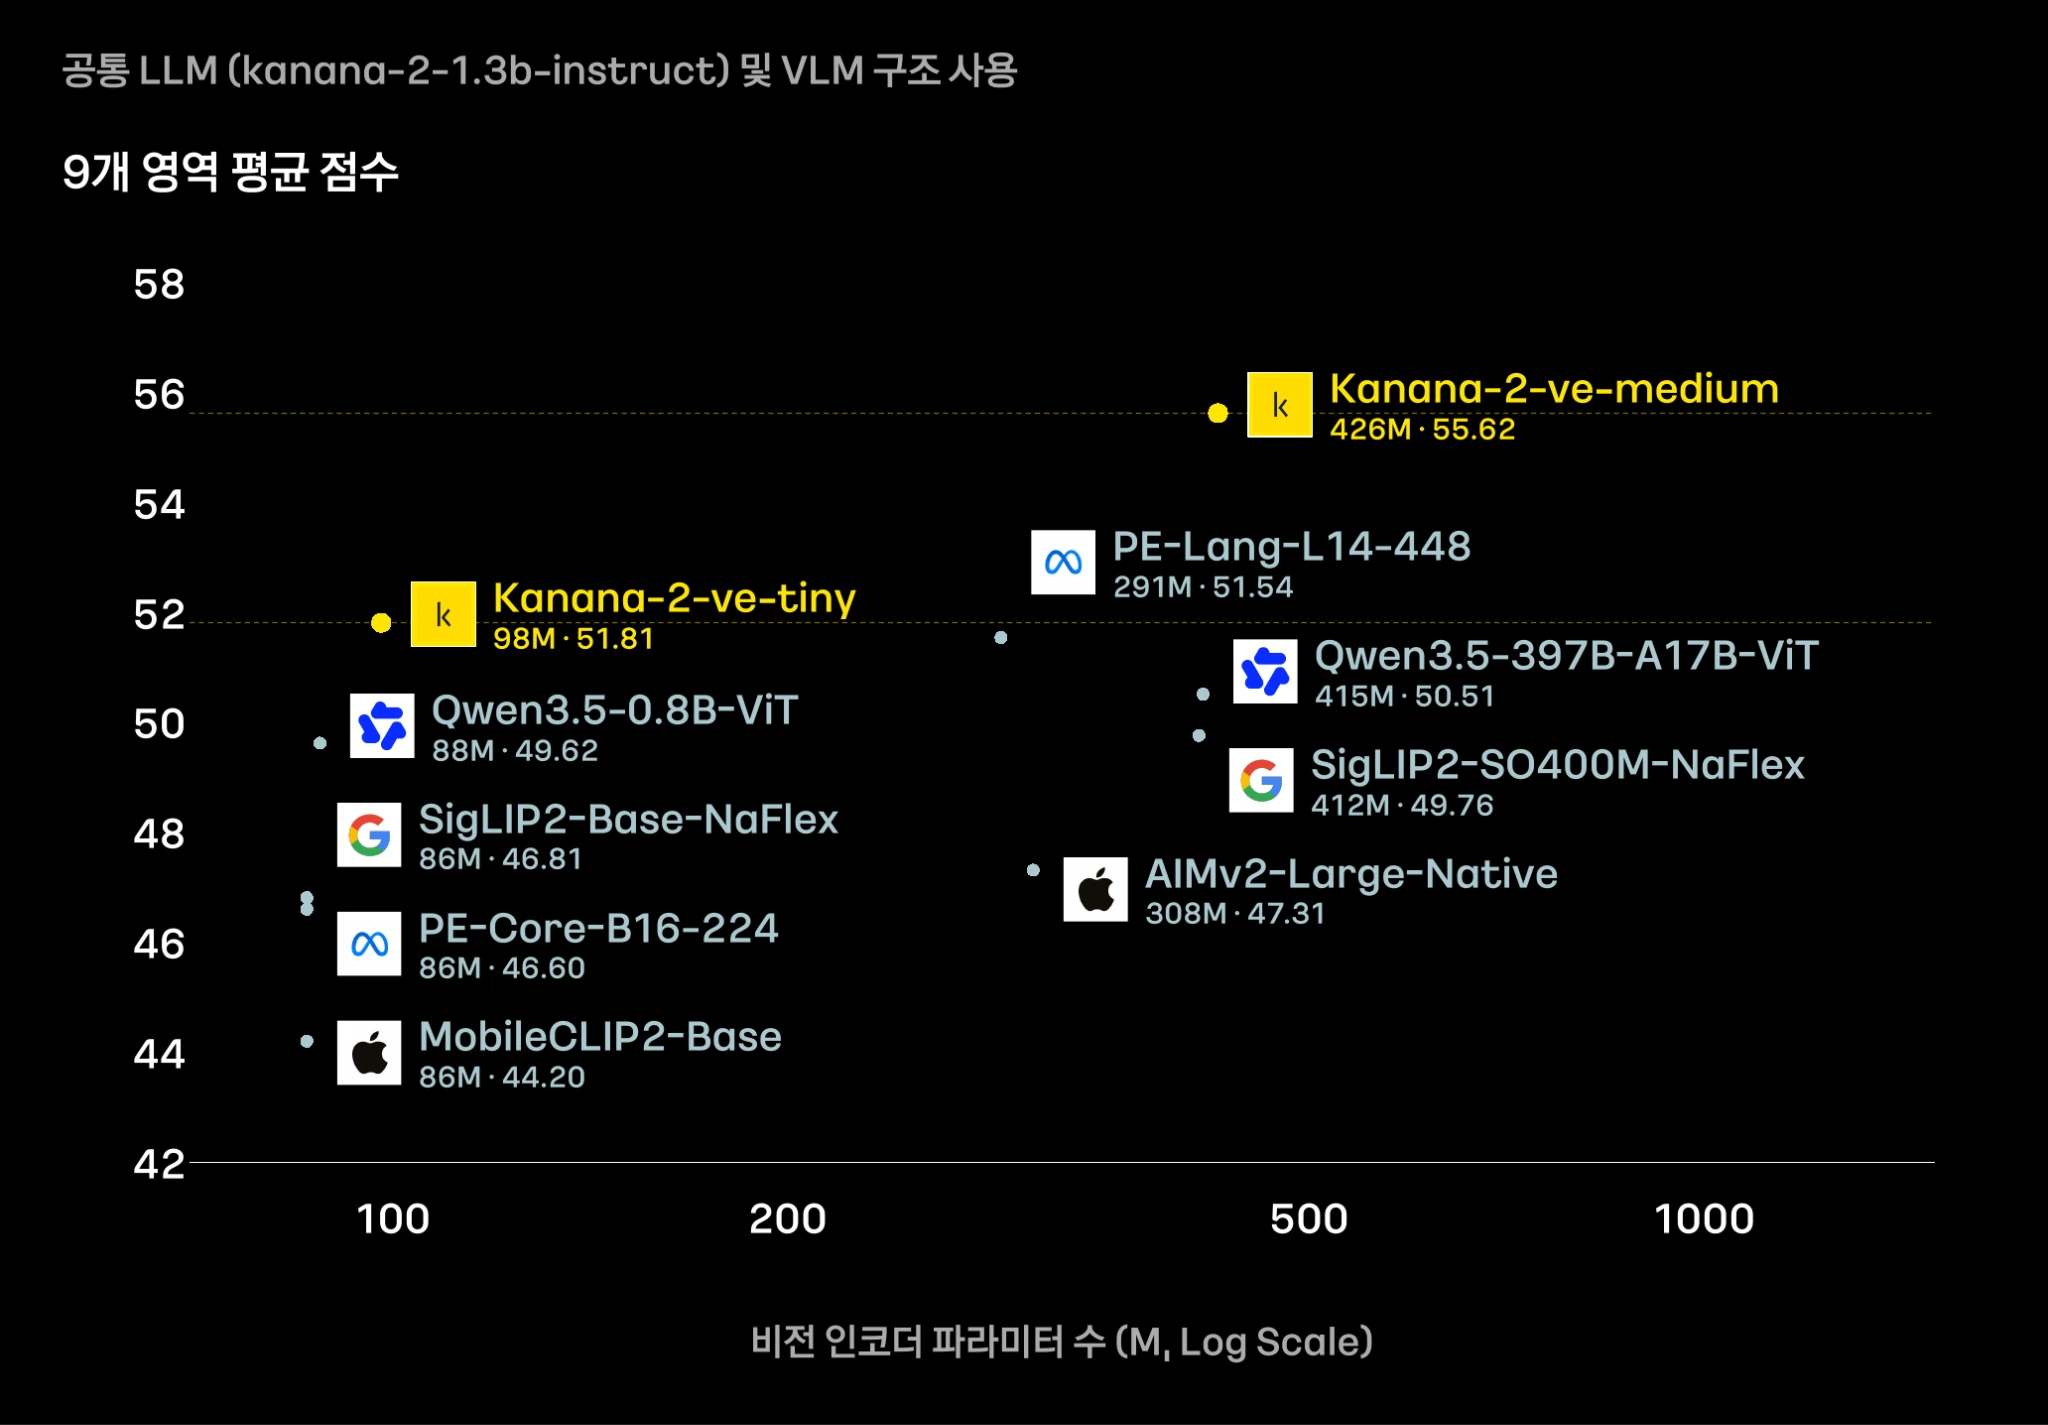
개발기 그림 17.
가로축은 비전 인코더 파라미터 수이며 전체 VLM 크기가 아니다.
본문의 수치는 모델 카드 표를 기준으로 읽는다.
모바일에서는 눌러 확대할 수 있다.[2][3]
한국어 평가에는 자체 구축한 benchmark가 여럿 포함되고, 일부 항목은 내부 한국어 번역본이다.[3]
따라서 결과는 카카오의 공식 평가 보고로 받아들이되, 독립적으로 재현된 범용 순위로 취급해서는 안 된다.
이 글에서도 가중치 추론이나 전체 benchmark 재실행은 수행하지 않았다.
실제 통합에서는 해상도와 출력 계약부터 확인한다
Native Resolution은 입력을 아무 변경 없이 그대로 통과시킨다는 뜻이 아니다.[8]
공개 processor는 가로·세로를 patch·merge 격자에 맞추고 픽셀 예산 안에서 크기를 조정한다.[8]
기본 최대 픽셀 수는 1,638,400으로 정사각형 1280²에 해당하므로, 2560² 성능 그래프를 기본 processor 입력과 동일시할 수 없다.[8]
또한 encoder 출력은 downstream patch merger가 처리할 순서를 따른다.[7]
특징 차원만 맞춰 기존 projector에 연결하면 충분한지는 별도 검증해야 한다.
공식 평가와 다른 LLM에 연결할 때도 한국어 문서 성능·학습 데이터·해상도 예산을 다시 확인하는 편이 낫다.
공식 예제는 trust_remote_code=True로 사용자 정의 processor와 모델 코드를 로드한다.[3]
도입 시에는 코드 검토와 revision 고정이 필요하며, 공개된 파일의 존재와 실제 배포 성능·안전성 검증을 분리해야 한다.
상업적 사용 가능하지만 무조건적인 허용은 아니다
보도자료는 상업적 활용 가능한 Kanana Open License로 소개한다.[1]
실제 LICENSE 4.2도 4.1에 해당하지 않는 자체 서비스 개발·운영은 별도 상업 라이선스 없이 가능하다고 규정한다.[5]
하지만 4.1은 특정 제공·판매 방식에 별도 라이선스가 필요하다고 명시한다.[5]
- 제3자에게 API·클라우드·원격 접근으로 모델 또는 파생물에 대한 접근을 제공하거나 재판매하는 경우.[5]
- SI·온프레미스 솔루션의 일부로 모델 또는 파생물을 제공·재판매하는 경우.[5]
- 온디바이스 영역에 내장해 제3자에게 제공·재판매하는 경우.[5]
재배포 시 계약 제공·수정 표시·NOTICE 등의 의무와 “Powered by Kanana” 표시 조건도 있다.[5]
재료나 출력을 사용해 다른 AI 모델을 만들거나 개선해 배포할 때는 모델 이름에 Kanana 접두어를 요구하는 조항도 확인해야 한다.[5]
이는 MIT·Apache와 같은 조건이라고 요약할 수 없으며, 실제 제품 제공 방식이 어느 조항에 속하는지는 별도 검토가 필요하다.
이번 공개의 가치는 한국어 문서와 작은 글자에 맞춘 인코더를, LLM 초기화·고해상도 구조·증류라는 연결된 설계로 제공했다는 데 있다.
다만 완성형 VLM과 인코더를 구분하고, 동일한 평가 조건에서 자신의 문서 분포와 상업 제공 방식을 확인해야 기술적 장점이 실제 도입 가치로 이어진다.