로봇이 “어디로 손을 뻗을지”를 좌표로 설명한다면, 점을 더 많이 예측할수록 생성해야 할 토큰도 늘어난다.
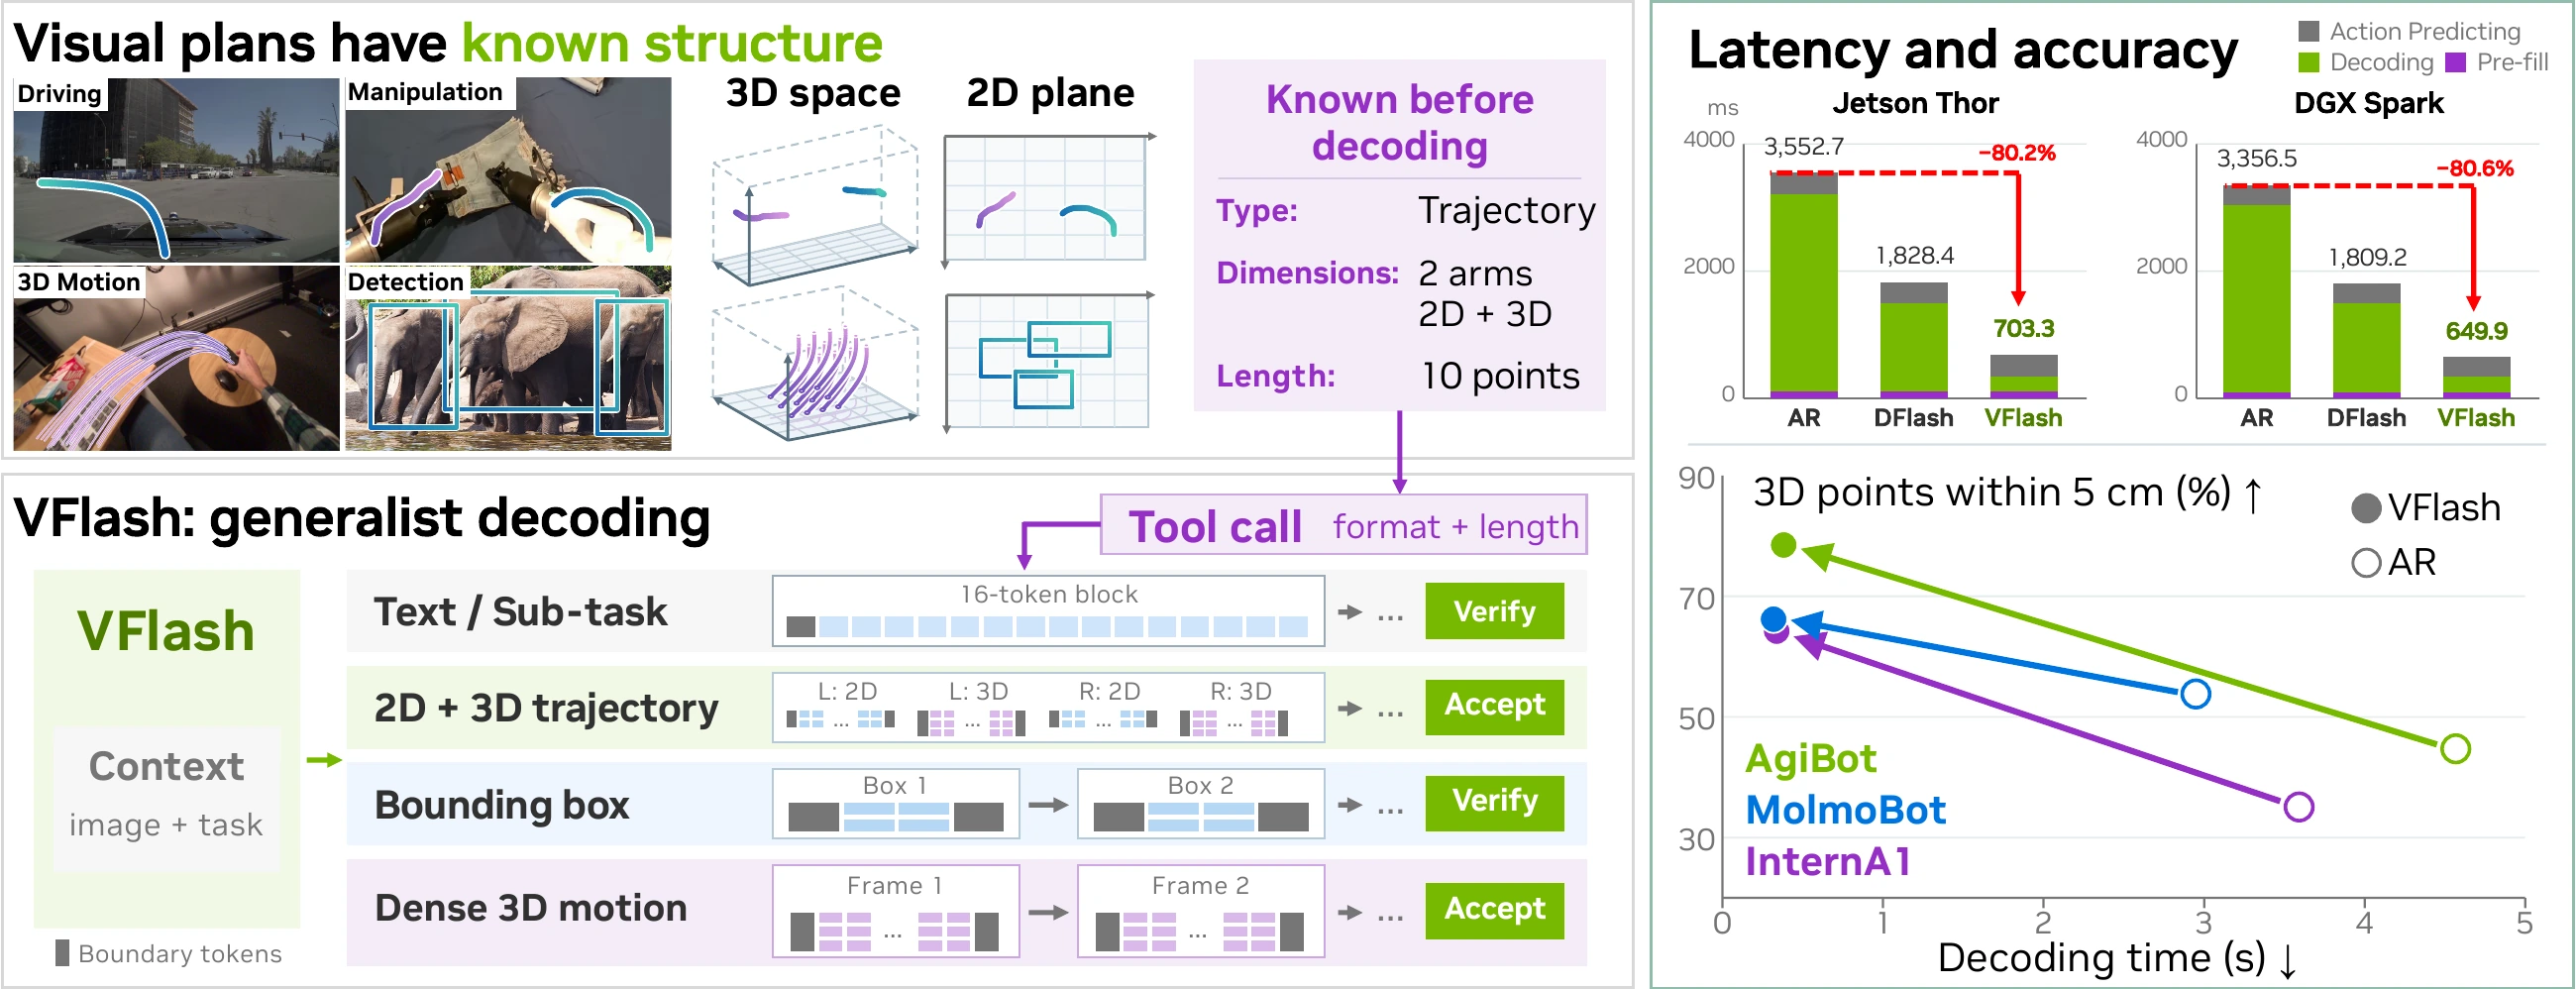
VFlash는 이 좌표를 문장처럼 하나씩 쓰는 대신, 박스나 궤적 하나를 구성하는 좌표 묶음을 한 번에 예측한다.[1]
핵심은 자기회귀 모델과 똑같은 토큰을 더 빨리 내는 것이 아니라, 행동에 유용한 기하를 더 빠르고 정확하게 만드는 것이다.[1]
2026년 11월 5일 공개된 논문은 2D·3D 로봇 궤적, 박스, 조밀한 3D 움직임 예측을 함께 다룬다.[4]
NVIDIA 공식 프로젝트는 이를 Physical AI용 범용 디코딩 프레임워크로 소개하지만, 성과를 읽을 때는 궤적 오차, 시뮬레이터 성공률, 모델 파이프라인 지연을 구분해야 한다.[2]
특히 모든 공간 출력에서 검증을 없애도 정확도가 좋아지는 것은 아니다.[1]
왜 일반적인 추측 디코딩만으로는 부족한가
DFlash 같은 추측 디코딩은 작은 초안 모델이 여러 토큰을 제안하고, 큰 타깃 모델이 이를 병렬 검증한다.[1]
타깃과 일치하는 가장 긴 앞부분만 받아들이므로, 좌표가 한 구간만 달라도 뒤의 토큰을 버리게 된다.[1]
이 방식은 타깃 출력을 보존하는 데 적합하지만, 조금 다른 좌표가 실제로는 더 정확한 공간 예측일 가능성을 평가하지는 않는다.[1]
VFlash의 출발점은 출력 구조를 미리 안다는 것이다.[1]
“10개 지점의 3D 궤적”이라면 각 슬롯이 몇 번째 지점의 어느 축인지 이미 정해진다.
논문은 이 정보를 이용해 시각 기본 요소인 primitive의 경계와 좌표 위치를 초안 블록에 맞추고, 구조적으로 유효한 좌표를 타깃 토큰과의 일치 없이 수용한다.[1]
Flash Primitive Decoding의 세 가지 설계
첫째는 블록 경계 정렬이다.
고정 길이 토큰 창이 궤적 중간을 자르는 대신, 박스 하나나 요청된 길이의 궤적 전체가 한 블록이 된다.[1]
가변 길이는 tool call이 선언하고, 기본 요소의 종류가 좌표 차원과 배치를 결정한다.[1]
둘째는 위치 정렬이다.
기본 VLM에서는 좌표마다 전용 숫자 토큰 하나를 사용한다.[1]
일반 텍스트 숫자를 쓰는 MolmoMotion 타깃에는 부호와 고정 폭 자릿수 배열을 적용해, 숫자 길이가 바뀌어도 뒤 좌표의 위치가 밀리지 않게 한다.[1]
조밀한 움직임 예측에서 병렬화 단위는 미래 프레임 하나이며, 여러 미래 프레임의 생성 자체는 순차적이다.[1]
셋째는 정답 기하로 학습한 초안 모델이다.
주 실험의 타깃은 Qwen3-4B·MoonViT·MLP 연결기로 구성되며, 과제별 미세조정 뒤 동결한다.[1]
다섯 층 초안 모델은 타깃의 중간 특징을 읽되, 타깃이 생성한 답을 복제하는 대신 주석 좌표의 교차엔트로피로 학습한다.[1]
부록의 초안 모델 학습 가능 파라미터는 537M이므로, “다섯 층”을 거의 비용 없는 모듈로 읽어서도 안 된다.[1]
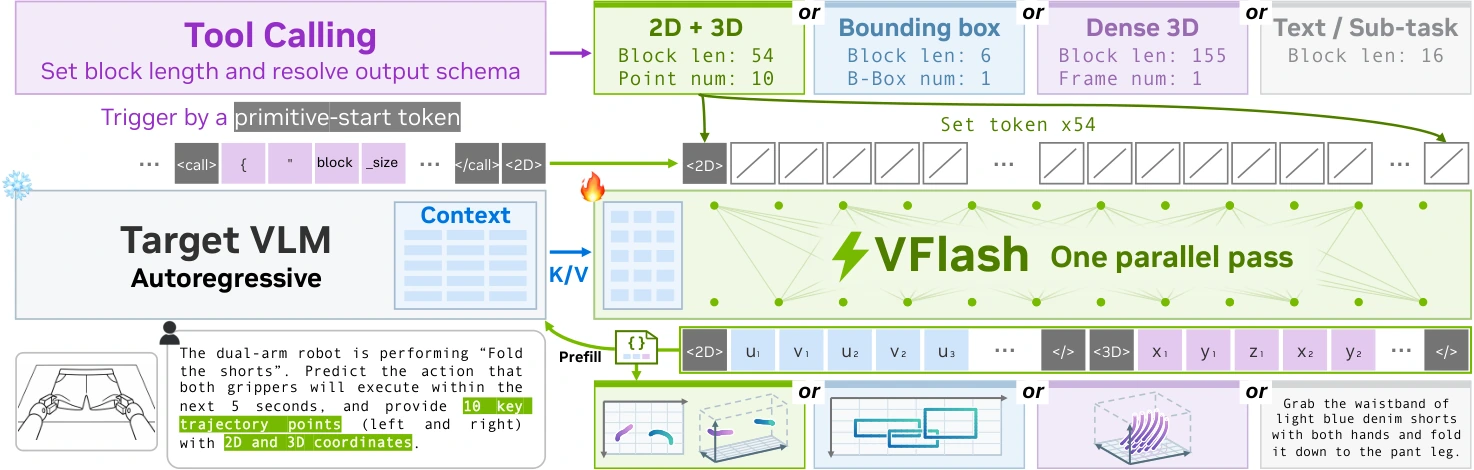
여기서 한 번의 초안 예측은 전체 시스템이 신경망을 한 번만 실행한다는 뜻이 아니다.[1]
수용한 기본 요소를 타깃 VLM이 다시 한 번 처리해 KV 캐시와 후속 문맥을 갱신하고, 행동 모델이 읽을 특징을 만든다.[1]
일반 텍스트는 기존 16위치 블록 검증을 유지하며, 잘못된 구조는 제약된 자기회귀 생성으로 되돌린다.[1]
구조 검사는 좌표가 문법과 범위에 맞는다는 뜻이지, 충돌 회피나 물리적 실행 안전성을 보증하는 검사가 아니다.
궤적 오차와 행동 성공률은 따로 본다
2D 궤적에서는 같은 타깃의 자기회귀 생성보다 두 벤치마크의 여섯 오차 지표가 모두 감소한다.[1]
그러나 ShareRobot-Bench에서는 비교표의 RoboBrain-2.0이 더 낮은 오차를 보이므로, 모든 외부 모델보다 우월하다는 결론은 아니다.[1]
3D 평가도 같은 타깃을 사용하는 비교가 핵심이다.
아래는 손목 카메라 추가 학습이 없는 2D+3D 출력 설정의 평균 지점 오차 ADE다.[1]
| 데이터 | AR | VFlash |
|---|---|---|
| InternA1 | 0.153 | 0.062 |
| AgiBot | 0.105 | 0.041 |
| MolmoBot | 0.076 | 0.055 |
논문 표 4.
단위는 미터이며 낮을수록 좋다.[1]
각 평가에는 1,000·999·4,221개 기록을 사용하고, 모두 주 카메라 입력을 준다.[1]
기준 궤적은 손당 10개 지점을 3D 호 길이 기준으로 재표본화한 경로이며, 고정 시간 간격의 저수준 제어 명령은 아니다.[1]
SR@5·SR@10도 각각 5cm·10cm 안에 들어온 지점 비율이지 작업 성공률이 아니다.[1]
실제 행동과의 연결은 별도 WAM이 담당한다.
MolmoSpaces에서는 Cosmos-Predict2.5를 제어용으로 후학습한 WAM이 시각 계획을 인코딩한 VLM 특징을 교차 어텐션으로 읽는다.[1]
다섯 조건은 같은 초기 WAM 체크포인트에서 각각 100,000회 후학습하며, 구조와 학습 예산을 맞춘다.[1]
최종 정책 가중치를 하나로 고정하고 추론 디코더만 교체한 실험은 아니다.
| 조건 | 평균 성공률(%) |
|---|---|
| 원래 텍스트 인코더 | 62.6 |
| AR의 2D+3D 계획 | 61.0 |
| VFlash, 궤적 대신 이미지 특징 | 63.7 |
| VFlash, 3D 계획만 | 69.3 |
| VFlash, 2D+3D 계획 | 70.2 |
논문 표 7.
네 과제군의 성공률을 동일 가중치로 평균했다.[1]
원래 WAM 대비 개선은 7.6%p다.
다만 이 비교에는 텍스트 인코더 교체와 계획 조건화가 함께 들어가므로, 디코더만 바꾼 효과와 같지는 않다.[1]
더 직접적인 비교는 같은 VLM 문맥을 쓰는 AR 계획 61.0%와 VFlash 계획 70.2%이며, 궤적 특징을 빼면 63.7%로 낮아진다.[1]
AR 계획은 원래 WAM의 62.6%보다도 낮으므로, 시각 계획을 추가한다는 사실만으로 제어 성과가 개선되는 것은 아니다.[1]
이 결과는 시뮬레이터 평가다.[1]
부록은 3,915개 에피소드, 한 학습 시드와 한 평가 시드를 사용하고, 20행동 묶음 세 개마다 새 계획을 생성하며 추론 중 시뮬레이터를 정지한다고 명시한다.[1]
따라서 현실의 움직이는 환경에서 지연을 그대로 감당하며 달성한 성공률이나 반복 시드의 통계적 우위로 확대할 수 없다.
‘약 5배’와 ‘약 25배’는 서로 다른 측정이다
MolmoSpaces 모델 파이프라인의 지연은 다음과 같다.
같은 과제·플랫폼에서 AR과 VFlash를 비교한 값이다.[1]
| 장치 | AR(ms) | VFlash(ms) |
|---|---|---|
| Jetson Thor | 3,552.7 | 703.3 |
| DGX Spark | 3,356.5 | 649.9 |
| H100 | 516.1 | 142.3 |
논문 부록 E의 단계별 지연 합계.
Thor·Spark는 약 5.1–5.2배, H100은 약 3.6배 가속이다.[1]
측정은 배치 크기 1, 맞춤형 TensorRT-Edge-LLM 런타임, FP16 VLM 엔진·KV 캐시 조건이며 가중치·KV 양자화는 쓰지 않는다.[1]
모델 로딩, 엔진 빌드, 워밍업, 파일 읽기, 측정 모듈 밖의 CPU 전처리와 출력 디토큰화는 제외된다.[1]
즉 센서 입력부터 액추에이터 반응까지의 종단 간 지연은 아니다.[2]
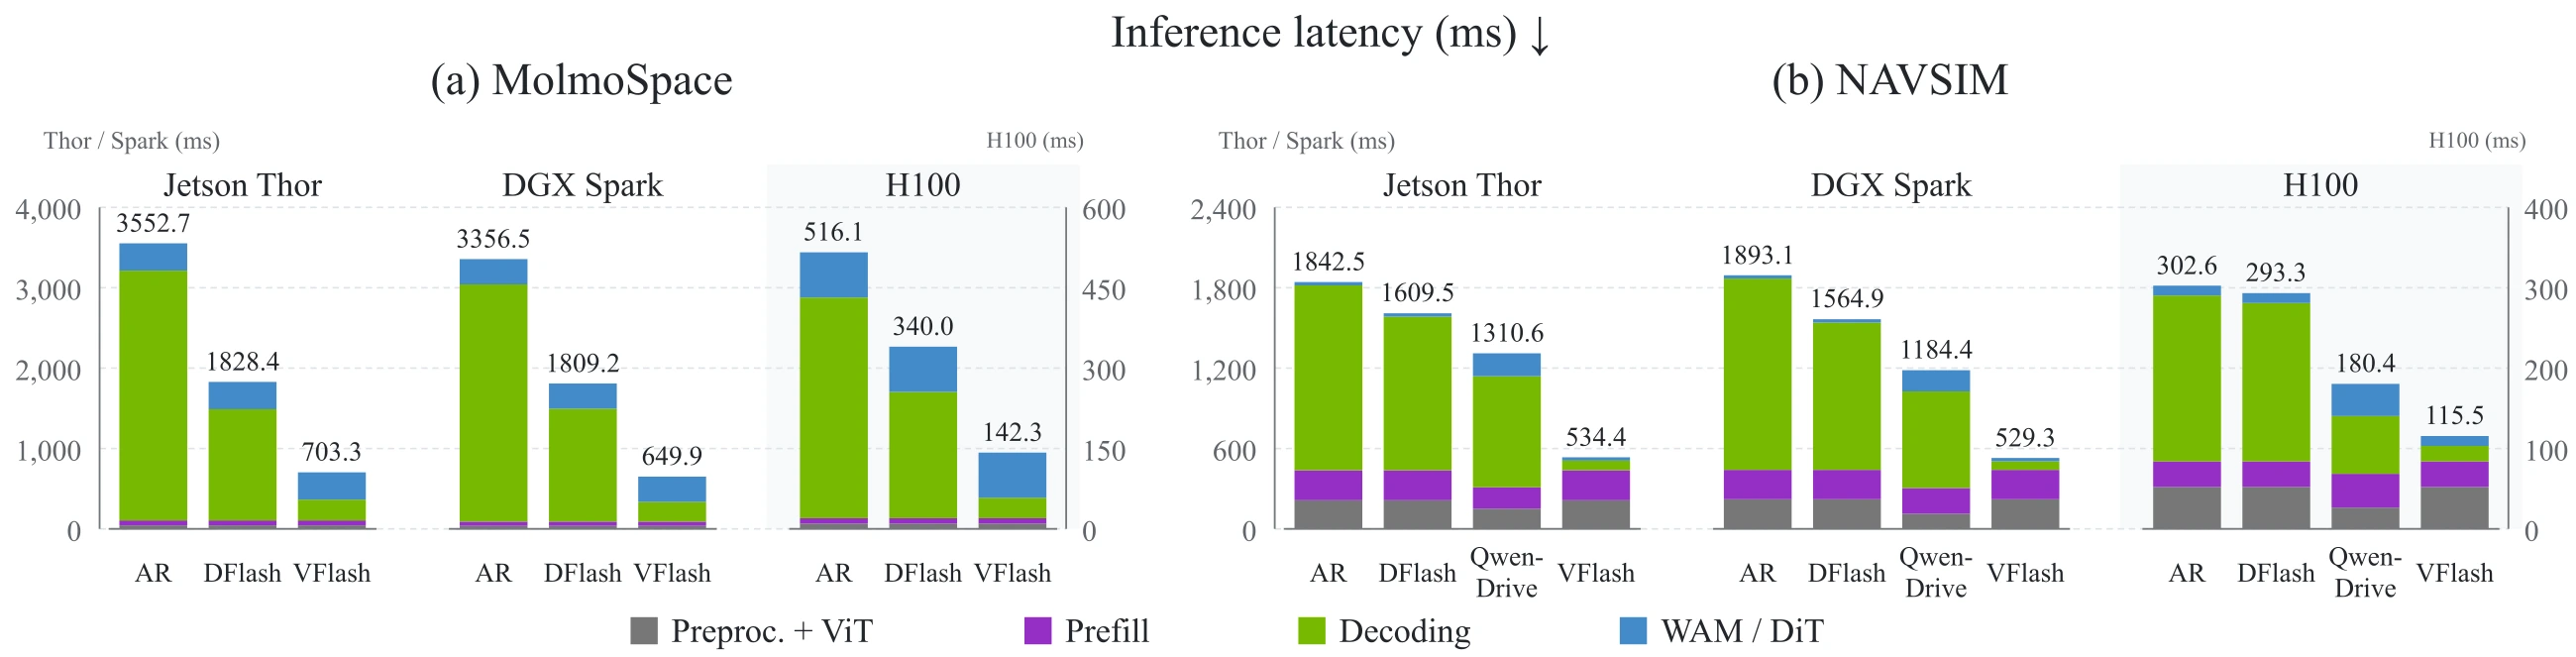
또한 이 측정에서는 모든 디코더에 같은 tool-call JSON을 미리 공급한다.[1]
MolmoSpaces의 AR 디코딩은 이전 별도 프로파일을 사용하고, 다른 단계는 디코더 간 같은 평균값을 공유해 합산하므로, 완전히 동일한 실행 전체를 반복한 벽시계 비교와도 구분해야 한다.[1]
프로파일 표본도 로봇 24개 기록, 주행 5개 기록으로 제한된다.[1]
조밀한 3D 움직임의 약 25배는 별개다.
H100·배치 1에서 동일 선택 기록의 단일 rollout 생성 시간을 비교한 예비 측정이며, 데이터셋별 약 23.5–26.4배다.[1]
이를 모든 과제의 반복 측정 처리량이나 전체 로봇 제어 가속으로 옮겨 쓰면 안 된다.
직접 수용이 항상 좋은 것은 아니다
박스는 중요한 반례다.
Dense200에서 유효한 구조만 확인해 모두 수용하면 평균 F1이 AR의 60.10에서 39.09로 떨어진다.[1]
불확실한 좌표를 AR로 재생성하는 fallback을 켜면 61.78로 회복되고, 초당 박스는 6.73에서 17.46으로 높아진다.[1]
그러나 엄격한 IoU 0.95의 F1은 여전히 AR보다 낮다.[1]
이 F1은 COCO AP와 다른 지표이기도 하다.[1]
조밀한 움직임 예측도 지표별로 엇갈린다.
DAVIS의 ADE는 1.227m에서 0.893m로 줄지만, WorldTrack FDE는 0.261m에서 0.300m로 커지고, 작은 오차 임계값에서의 PWT는 세 데이터셋 모두 AR보다 낮다.[1]
로봇 궤적의 일관된 개선을 모든 미래 움직임 예측으로 일반화할 수는 없다.[1]
자율주행에서는 VFlash-RL이 NAVSIM PDMS 90.7로 Qwen-Drive-1.0-RL과 같지만, Waymo RFS는 7.86으로 그 모델의 7.91보다 낮다.[1]
품질 평가는 5회 DDIM, 지연 프로파일은 10회 DDIM 조건이다.[1]
NAVSIM의 내부 검증 분할도 행동 헤드 학습에는 제외됐지만 상위 VLM 미세조정에는 포함됐으므로, 모든 구성요소에서 완전히 보지 않은 검증셋은 아니다.[1]
Waymo의 검증 장면 479개는 행동 헤드의 RL 보상과 체크포인트 선택에 쓰인다.[1]
다만 보고된 결과는 별도 테스트 분할이며, 두 테스트셋은 SFT·RL·체크포인트 선택에 사용되지 않았다고 명시한다.[1]
공개 코드가 곧 즉시 재현 가능한 모델은 아니다
Eagle의 Embodied에는 VFlash 학습·생성·평가 코드와 문서가 공개돼 있다.[3][5]
다만 확인한 revision 06edcff의 README는 타깃과 초안 체크포인트가 추후 공개 예정이라고 명시하며, 예제도 로컬 체크포인트 경로를 요구한다.[5]
기존 LocateAnything 체크포인트를 VFlash의 논문 모델로 간주해서는 안 된다.
현재 공개된 조밀한 움직임 평가기에도 주의할 점이 있다.
VFlash는 기본 5개 후보를 순차 생성한 뒤 정답에 대한 ADE가 가장 낮은 답을 고르는 oracle best-of-5를 쓰며, AR은 한 번의 greedy 답을 사용한다.[6][7]
논문의 단일 rollout 속도 설명과 이 공개 평가기의 후보 선택은 별개 조건이다.[1][7]
논문 부록 F.3은 품질 평가의 후보 선택 조건을 명시하지 않아, 표 5의 품질과 약 25배의 단일 rollout 속도가 동일 설정에서 대응하는지는 확인되지 않는다.[1]
논문 수치가 모두 이 공개 코드 설정으로 산출됐다고 단정해서도, 공개 명령의 결과를 단일 예측 성능으로 해석해서도 안 된다.
코드의 Apache-2.0 표기와 모델 권한도 분리해야 한다.[3]
저장소가 연결한 LICENSE_MODEL은 NVIDIA와 계열사의 예외를 두고 연구·평가 목적의 비상업적 사용으로 제한한다.[8]
향후 실제 체크포인트가 배포되면 그 패키지에 적용된 조건을 다시 확인해야 한다.
VFlash에서 오래 남을 아이디어는 “작은 모델로 큰 모델을 그대로 흉내 낸다”가 아니다.
출력의 구조를 알고 있다면, 그 구조에 맞는 학습 단위와 품질 기준으로 생성 자체를 바꿀 수 있다는 것이다.
다만 직접 수용 여부는 과제별로 설계하고, 기하 오차·행동 성과·지연·배포 가능성을 각각 검증해야 한다.
현재 근거는 그 가능성을 보여주는 연구 결과이지, 임의의 로봇에 바로 적용할 수 있는 완성된 제어 패키지는 아니다.