분산 학습 코드를 고쳐 “두 배 빨라졌다”고 말하기는 쉽다.
하지만 배치가 줄었거나, 마지막 옵티마이저 갱신이 측정 구간 밖으로 밀렸거나, 허용하지 않은 저정밀도 계산이 들어갔다면 같은 학습을 빠르게 만든 것이 아니다.
InfraRSI는 이런 가짜 가속을 걸러내면서 실행 설정과 소스 패치를 함께 탐색하려는 에이전트 하네스다.[1]
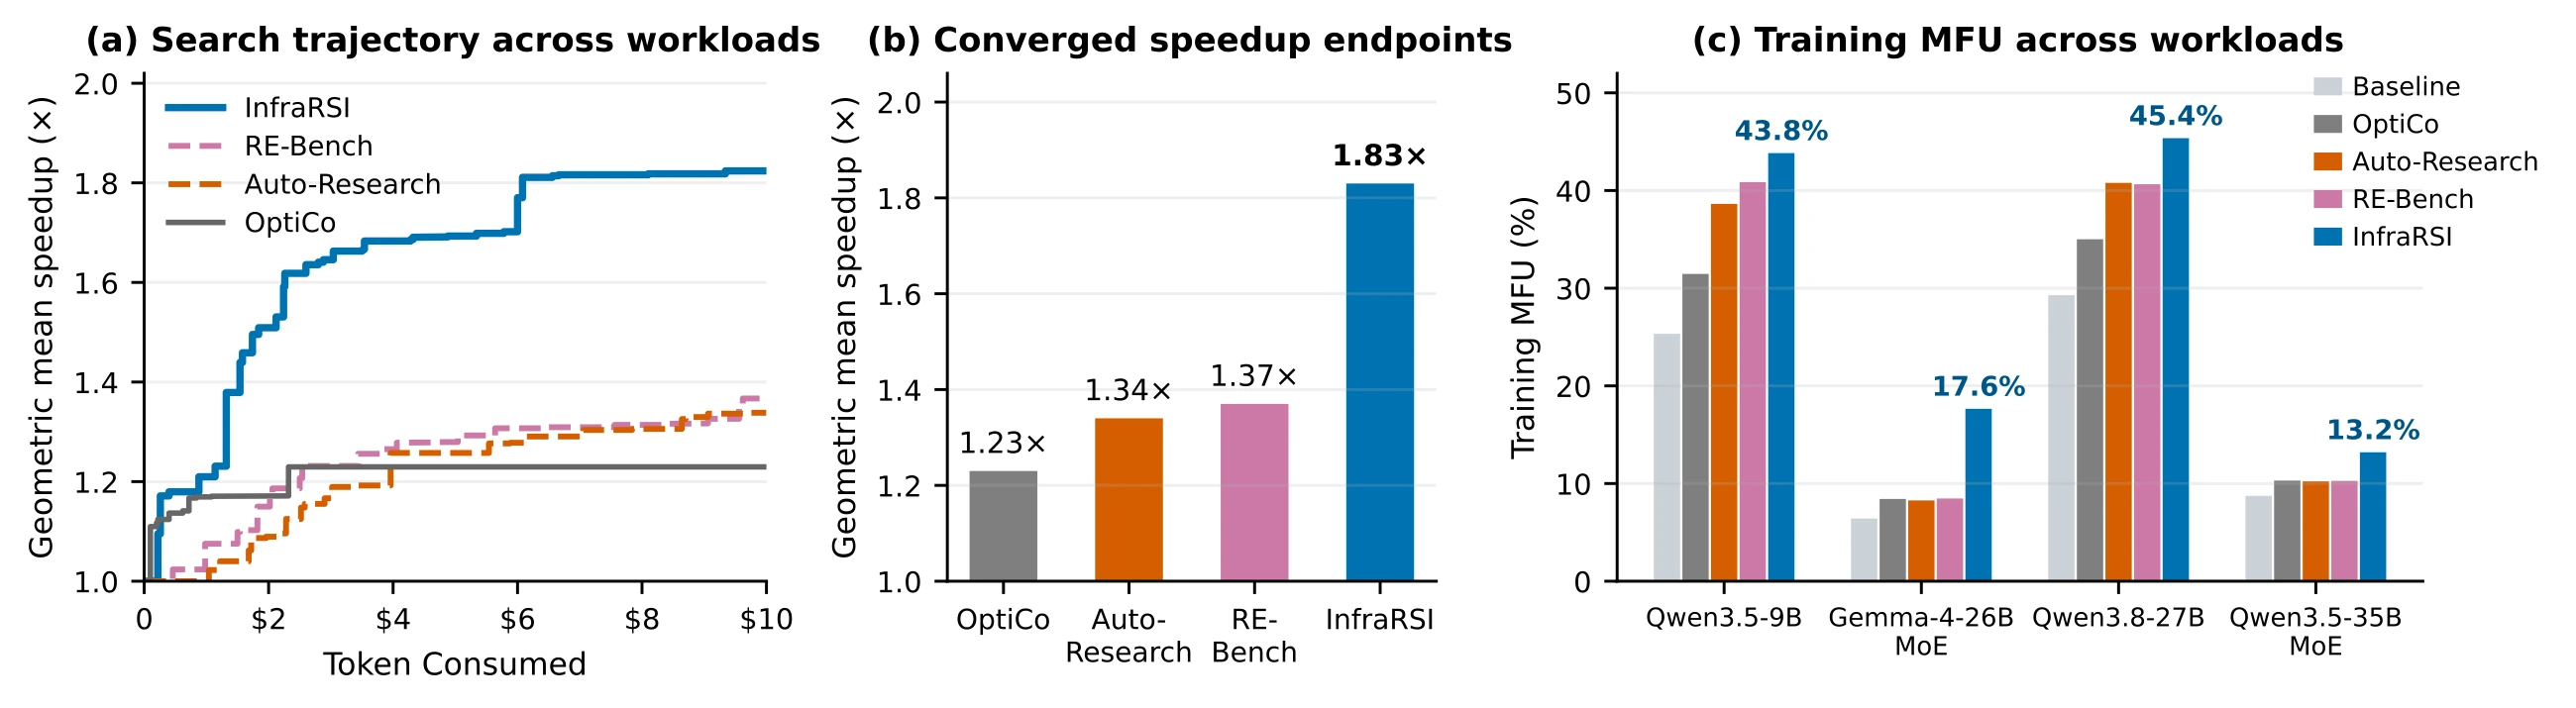
2026년 11월 8일 공개된 논문은 네 가지 dense·MoE 학습 부하에서 최대 2.75배, 기하평균 1.83배 가속을 보고한다.[4]
핵심은 모델에게 좋은 커널을 한 번 제안받는 데 있지 않다.
무엇을 바꿀 수 있는지 고정하고, 실제 측정과 실패로 탐색의 믿음을 수정하고, 검증된 경험을 다음 환경으로 옮기는 절차에 있다.[1]
다섯 단계가 탐색과 채택을 분리한다
InfraRSI는 실행 가능한 학습 스크립트나 코드 저장소를 받는다.[3]
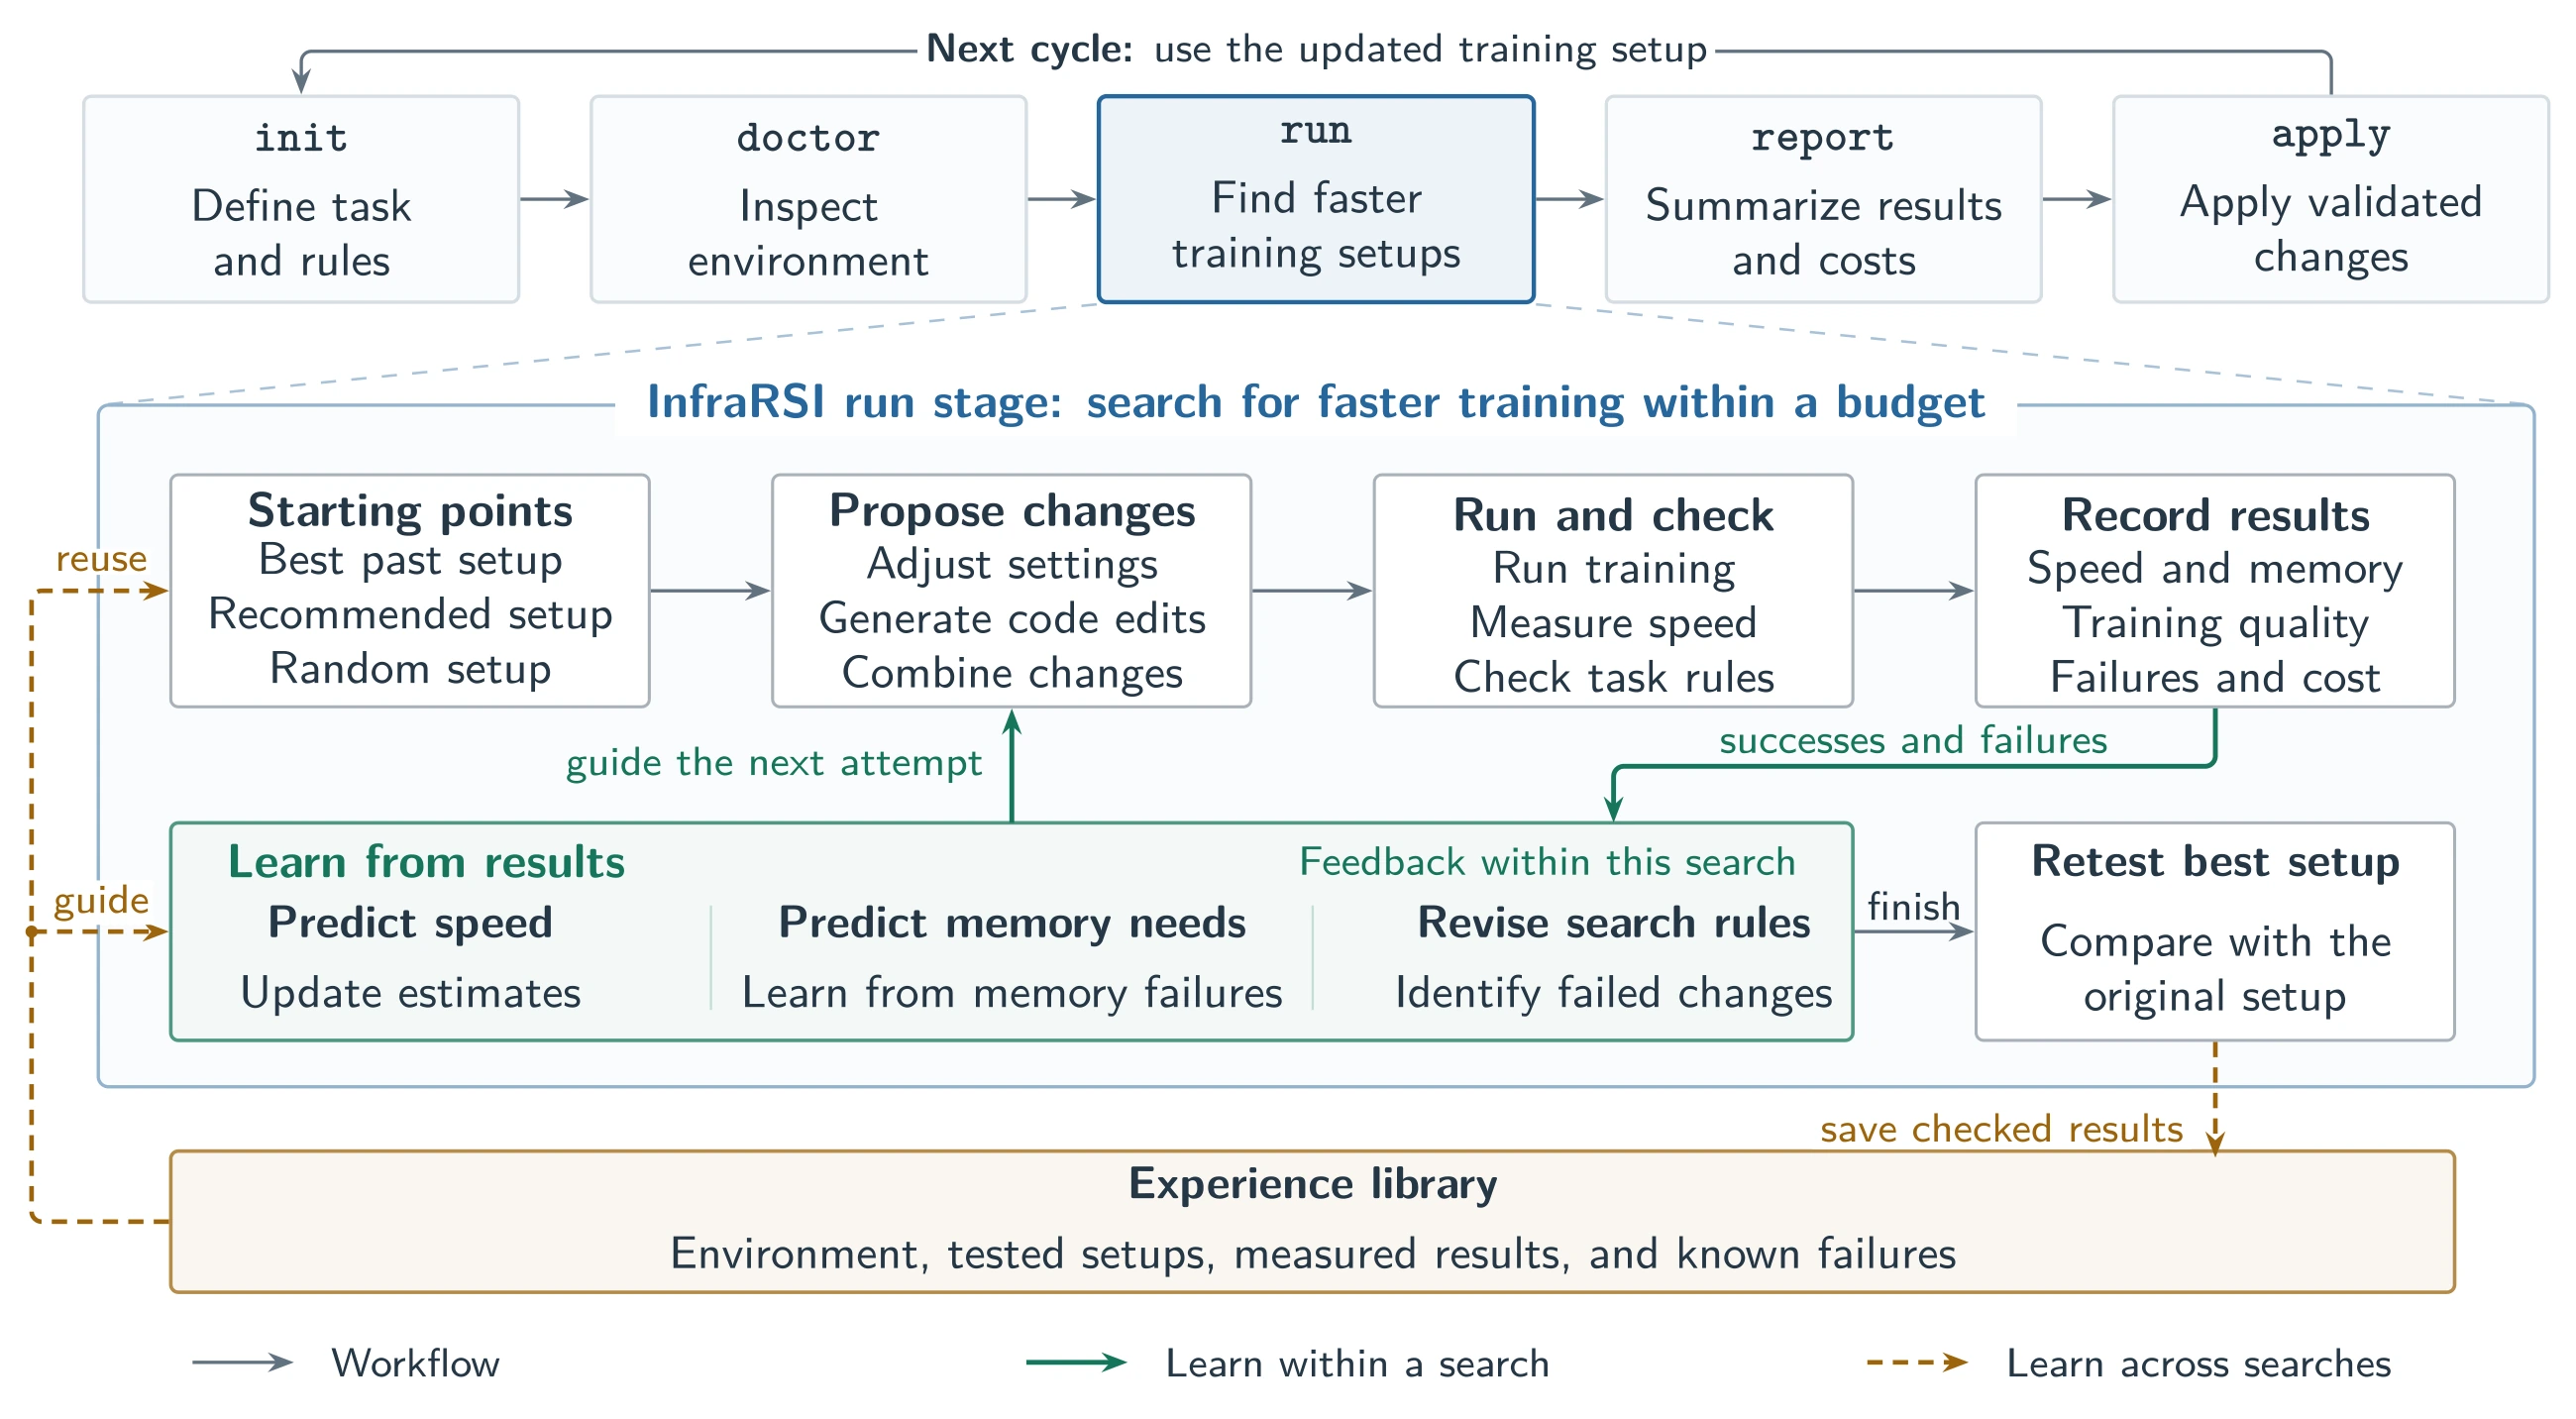
절차는 init → doctor → run → report → apply 순서다.[1]
init은 수정·동결 파일과 모델·데이터·업데이트당 처리량·정밀도·손실 허용치를 고정한다.[1]
doctor는 워밍업을 제외한 단계별 시간을 측정하고 클러스터 잡음을 추정한다.[1]
run은 명령행 옵션, 환경변수, 설정 키와 코드 패치를 함께 바꾸되 모든 시도의 실행 기록과 비용을 보존한다.[1]
마지막에는 원래 설정과 후보를 같은 GPU 할당에서 연달아 새로 실행하며, 검증과 승격 조건을 넘은 후보가 없으면 원래 설정의 1.00배를 결과로 남긴다.[1]
이 논문에서 재귀적 자기개선은 LLM 가중치를 계속 다시 학습한다는 뜻이 아니다.[1]
한 실행 안에서는 속도·메모리 예측과 탐색 사전확률을 수정하고, 실행 사이에서는 확인된 결과를 경험 뱅크에 축적한다.[1]
즉 자기개선의 단위는 훈련 인프라를 개선하는 실험 절차와 그 경험이다.
OOM은 버릴 실패가 아니라 메모리 관측이다
일반적인 탐욕적 탐색은 현재 가장 좋은 설정에서 하나씩 바꾼다.
그런데 재계산을 끄는 변경이 단독으로 OOM을 낸다면, 그것과 메모리 절약 설정을 동시에 적용해야 열리는 경로를 놓칠 수 있다.
InfraRSI는 서로 다른 세 시작 설정과 전체 이력을 쓰는 두 예측 모델로 이 문제에 접근한다.[1]
속도 모델은 설정·패치·조합별 로그 가속을 추정하는 Bayesian 선형 대리 모델이다.[1]
메모리 모델은 성공한 실행의 실제 피크뿐 아니라 OOM을 낸 실행이 요구한 메모리의 하한도 학습하는 검열된 Tobit 모델이다.[1]
OOM을 임의의 정확한 피크값으로 취급하지 않고, 부족한 GiB를 메울 절약 설정과 유망한 가속 설정을 묶는다.[1]
LLM의 예상 가속도 확정된 지식으로 쓰지 않는다.
논문이 조사한 초기 예측과 실제 속도의 순위 상관은 −0.49에서 −0.06으로 좋지 않았으며, 효과가 작다고 평가한 주요 설정도 불확실성이 크면 반대로 시험한다.[1]
오류가 발생하면 OOM·설정 충돌·수치 위반·패치 실패를 구분하고, 개별 옵션 전체를 금지하기보다 실패한 최소 조합을 제한한다.[1]
대표 사례가 Gemma-4 MoE다.
논문은 torch.compile, Liger 비활성화, 활성값 재계산 비활성화를 조합하고, 마스크를 캐시하는 FlexAttention 패치를 더해 2.75배에 도달했다고 설명한다.[1]
이는 각 설정의 독립 가속률을 더하거나 곱하면 얻는 수치가 아니라, 메모리와 컴파일 충돌을 함께 해결한 특정 실험 결과다.
네 부하에서 무엇이 빨라졌는가
아래는 논문 표 4의 InfraRSI 결과다.
MFU는 각 부하의 기준값에서 선택된 설정의 값으로 변한 것이다.[1]
| 모델·GPU | 가속 | MFU(%) |
|---|---|---|
| Qwen3.5-9B 8×H100 | 1.73× | 25.3 → 43.8 |
| Gemma-4-26B-A4B 8×H200 | 2.75× | 6.4 → 17.6 |
| Qwen3.8-27B 8×H200 | 1.55× | 29.3 → 45.4 |
| Qwen3.5-35B-A3B 16×H100·2노드 | 1.51× | 8.7 → 13.2 |
Gemma-4와 Qwen3.5-35B는 MoE다.
같은 계약 아래 측정한 저자 보고치다.[1]
네 가속률의 기하평균이 1.83배이고, MFU의 산술평균이 17.4%에서 30.0%로 오른다.[1]
동일 비교의 기하평균은 RE-Bench 에이전트 scaffold 1.37배, Auto-Research 1.34배, 설정만 조정하는 OptiCo 1.23배다.[1]
이는 RE-Bench 전체 벤치마크 점수나 모든 코딩 에이전트의 일반 성능 순위가 아니다.
또한 본문·부록에는 비교군의 제안 LLM 세부 설정, 반복 탐색 시드·신뢰구간, 동일 GPU-hour 상한 적용 여부가 충분히 제시되지 않는다.[1]
같은 작업 계약을 썼다는 사실만으로 모든 계산 자원과 통계적 조건까지 같았다고 해석할 수는 없다.
측정 기준도 중요하다.
MFU는 GPU당 비희소 BF16 피크 989.5TFLOP/s와 유효 모델 계산량을 기준으로 하며, 워밍업 뒤 11–30번째 업데이트의 평균 시간을 사용한다.[1]
재계산·통신·미선택 전문가의 연산은 MFU 분자의 유효 계산량에 포함하지 않는다.[1]
따라서 30.0%는 장치 사용률 센서의 값이 아니며, 단기 처리량 개선이 장기 학습 품질까지 같다는 증거도 아니다.
그림의 가로축은 Token Consumed로 적혀 있지만 눈금은 달러 단위다.[1]
실패·감사 제외 후보의 모델 사용 비용도 유지되지만, 이를 GPU 실행까지 포함한 총비용 10달러로 읽어서는 안 된다.[1]
탐색 비용과 이후 반복 학습에서 회수할 GPU 시간을 별도로 계산해야 실무적인 손익을 판단할 수 있다.
경험은 많을수록 좋은 것이 아니다
경험 뱅크는 환경, 관측, 효과를 구분하고 프레임워크별 설정을 공통 메커니즘으로 정규화한다.[1]
하드웨어·모델·시퀀스 길이·병렬 배치·연결망의 유사성은 경험을 고르고 정렬하는 데 사용하며, 실제 타깃에서 측정한 값이 이후 예측을 갱신한다.[1]
H20에서 유리한 텐서 병렬화가 H100에서는 통신 부담 때문에 불리해지는 식의 부호 반전도 보존한다.[1]
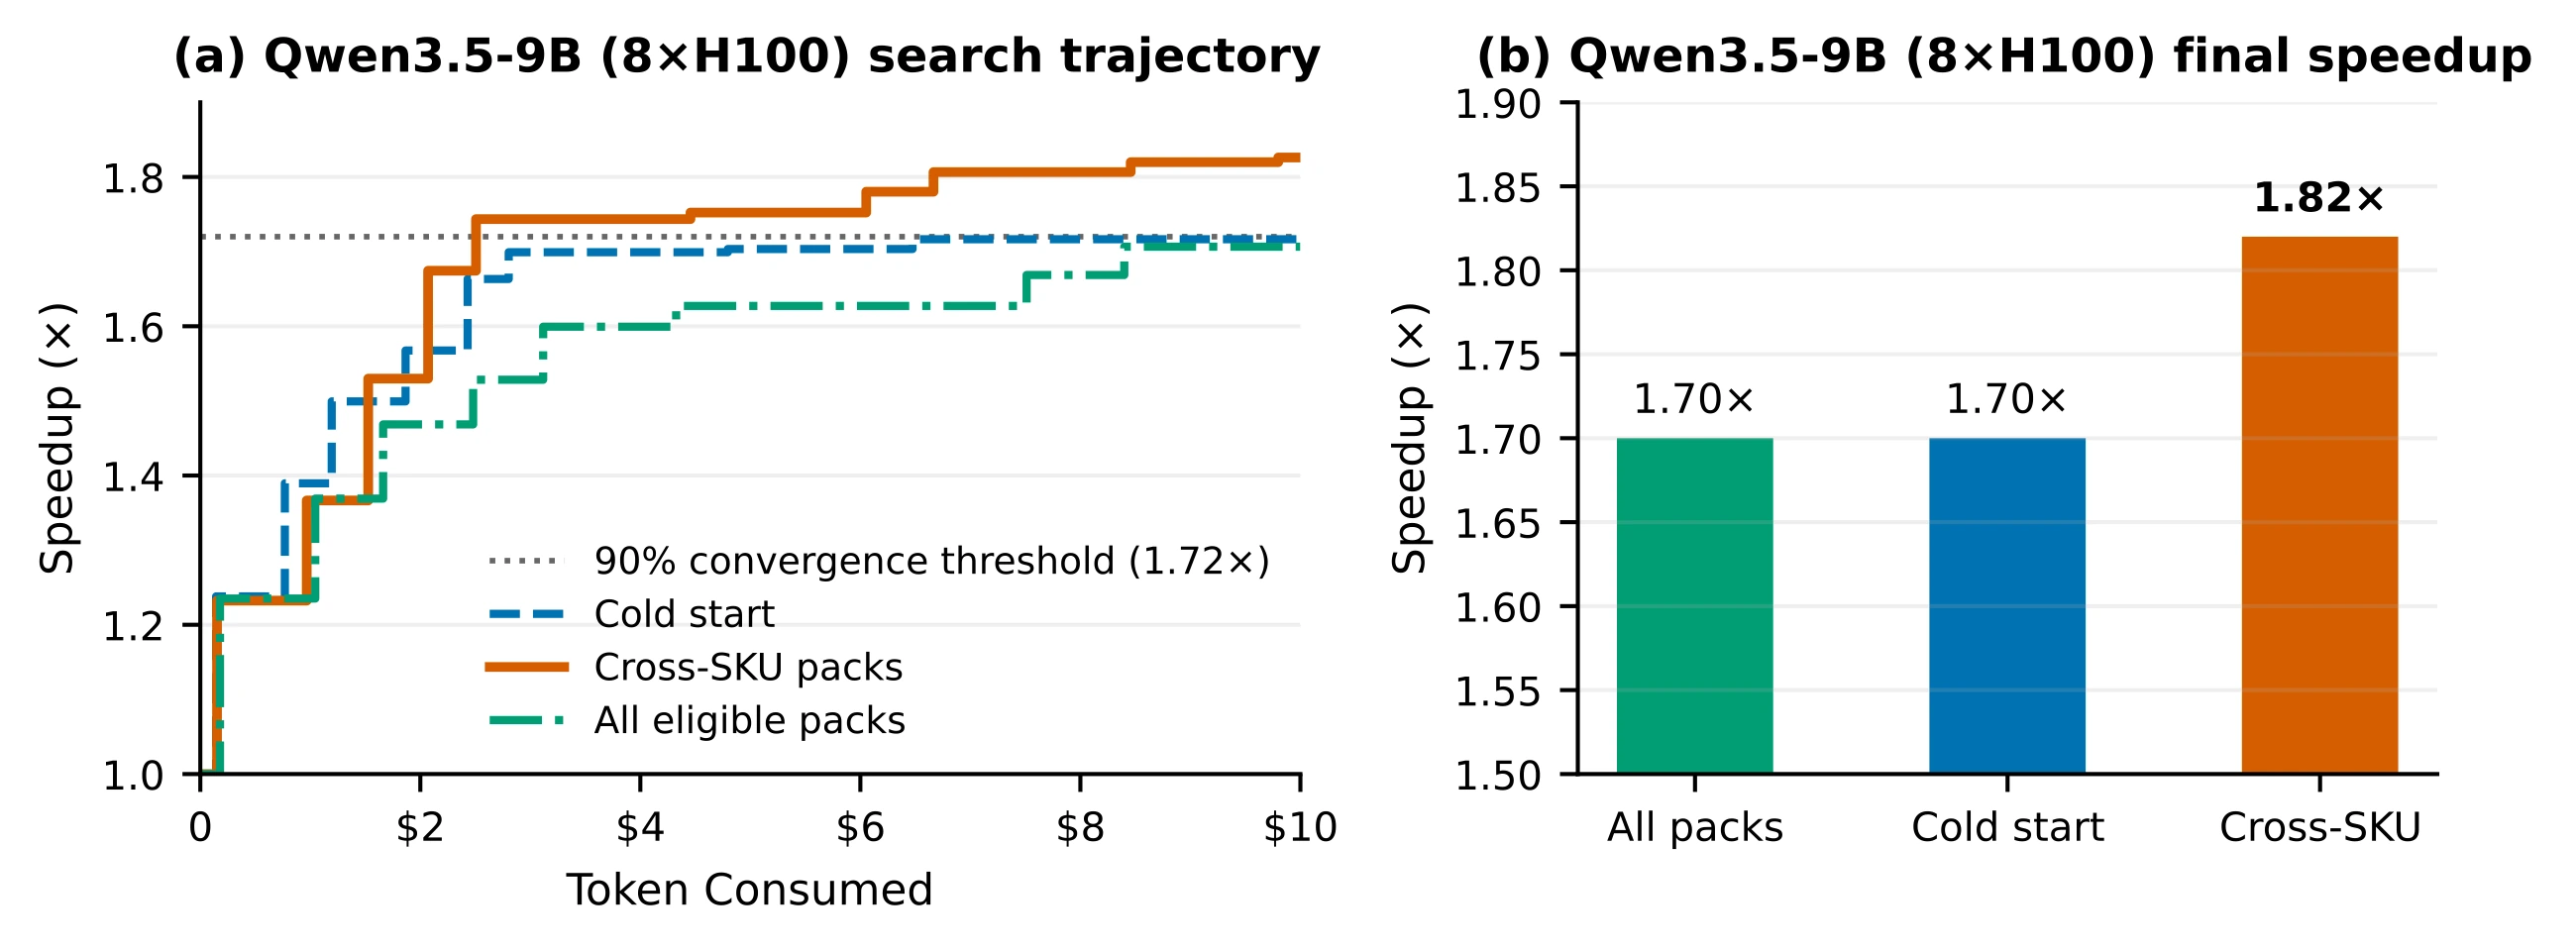
Qwen3.5-9B·8×H100 전이 실험은 다음과 같다.
다른 GPU의 경험만 쓰는 조건은 같은 작업·같은 GPU SKU의 이력을 제외한다.[1]
| 경험 조건 | 최종 가속 |
|---|---|
| 경험 없는 시작 | 1.70× |
| 사용 가능한 경험 전체 | 1.70× |
| 다른 GPU SKU 경험 | 1.82× |
논문 표 5.
주 성능 표의 1.73배와는 별도 전이 실험이다.[1]
다른 SKU 경험은 공통 최고 로그 가속의 90% 임계점에 9회, 2.97GPU·h로 도달했다.[1]
경험 없는 조건과 전체 경험 조건은 각각 15회·17회를 넘는 관측 예산에서도 그 임계점에 이르지 못했으므로, 정확한 도달 횟수가 아니라 검열된 결과다.[1]
이 한 전이 실험은 무조건 많은 기록을 넣기보다 현재 환경에 맞는 경험을 걸러 쓰는 것이 중요하다는 근거지만, 모든 GPU 조합의 일반화 보장은 아니다.
‘16개 불변식’이 모든 것을 자동 증명하지는 않는다
논문의 검증기는 실행 완료·작업량·업데이트 일정·수치·시간의 다섯 층을 검사한다.[1]
하지만 부록의 16개 항목은 상시 검사 11개, 조건부 3개, 정보 제공 1개, 최종 승격 게이트 1개로 구성된다.[1]
예를 들어 precision은 정보 제공 항목이며, 공개 코드도 정밀도 메타데이터 차이를 보고할 뿐 이 항목 자체로 거부하지 않는다.[5]
데이터 순서의 digest가 없으면 same_data는 미검증이고, 같은 첫 배치가 증명되지 않은 gradient norm 비교도 보고에 머무를 수 있다.[1]
반면 필수 작업량 항목을 검증할 수 없으면 거부한다.[1]
기본 손실 상대 허용 오차는 3%지만, 기준 실행 자체의 변동에 따라 사전 정의된 통계 규칙으로 넓어질 수 있으므로 항상 3%를 넘는 차이를 거부하는 장치도 아니다.[1]
일반 프로젝트용 공개 구현의 기본 필수 항목은 completes, same_workload, loss_within_tolerance 세 개다.[10]
실패 판정은 거부하지만, 필수가 아닌 항목의 unchecked는 반드시 승격을 막지는 않는다.[10]
따라서 논문의 더 강한 고정 계약과, 임의의 기존 프로젝트에 연결한 어댑터가 실제 제공하는 증거 범위를 구분해야 한다.
저자들의 오프라인 재판정은 1,212회 중 400회를 거부했고, 39회는 수치 계층이 없으면 통과했을 사례였다.[1]
또한 의도적으로 만든 변형 28개와 정상 12개의 테스트에서 40/40 기대 판정을 재현했다.[1]
이것은 검증기 검사 사례에 대한 일치율이지, 임의의 보상 해킹을 100% 찾아낸다는 탐지율은 아니다.
실제 논문에서도 시간 밖으로 밀린 상태 갱신과 무허가 저정밀도 변경은 별도 소스 경로 감사가 걸러냈다.[1]
결국 짧은 손실 일관성 검사, 새 기준 실행과의 속도 재현, 소스 감사가 서로 다른 역할을 맡는다.[1]
장기 수렴·최종 평가 점수·체크포인트 재개까지 중요하다면, 해당 작업이 실제로 어떤 신호와 추가 평가 명령을 제공하는지 확인해야 한다.[1]
공개 구현을 읽을 때의 현실적인 경계
공개 패키지 명세는 Python 3.10 이상, 버전 0.3.0이며, 다섯 단계 CLI와 여러 LLM 백엔드를 제공한다.[3][6]
다만 확인한 고정 revision 5e5f694의 전체 트리에는 경험 seed와 테스트가 있지만, 논문의 모든 학습 실행 기록을 묶은 완전한 실험 배포물로 간주할 근거는 부족하다.[9]
또한 이 트리에 라이선스 파일이 없고 패키지 명세에도 라이선스 선언이 없어, 공개 저장소라는 이유만으로 상업적 재사용 권한을 가정해서는 안 된다.[6][9]
새 프로젝트의 기본 예산은 탐색용 전체 실행 16회다.[3]
기준 실행, 진단, 최종 검증은 이 탐색 예산과 별도이며 시간·토큰·GPU-hour·금액 한도는 따로 설정한다.[3]
토큰 예산이 끝나도 준비된 패치와 일부 추가 탐색은 남은 실행 예산으로 계속될 수 있다고 공식 문서는 설명한다.[2]
optimize는 승격된 후보를 기본적으로 적용한다.[11]
더 주의할 점은 --dry-run이 마지막 적용 단계만 미리보기로 바꾼다는 것이다.[11]
기준 실행·진단·탐색까지 실행하지 않는 전역 무실행 모드는 아니므로, 비용 없는 사전 확인 명령으로 오해하면 안 된다.
공개 CLI 백엔드는 Claude Code의 도구를 비활성화하거나 Codex를 읽기 전용 sandbox로 호출하는 제한도 둔다.[7][8]
그러나 로컬 학습 executor는 호출 환경을 상속하고 shell=True로 명령을 실행하므로, 모델 호출부의 제한이 전체 작업의 격리를 보장하지는 않는다.[12]
먼저 별도 저장소·GPU 할당·허용 파일·예산과 실행 시간 제한을 정하고 작은 작업에서 검증하는 편이 맞다.
InfraRSI의 의미는 새로운 최적화 옵션 하나보다, 어떤 가속을 믿을 수 있는지 정의하는 실험 운영 계층에 있다.
성공한 설정만 기억하지 않고 OOM·수치 실패·충돌과 비용까지 남긴다는 방향은 유용하다.
다만 다른 프로젝트로 옮길 때는 성능 숫자보다 계약, 측정 창, 검증 신호, 경험 필터를 먼저 옮겨야 한다.