이미지 속 컵이 어디 있는지 아는 것과, 반대편에서 보면 컵이 어느 쪽에 놓일지 판단하는 것은 다른 능력이다.[2]
S-Space는 멀티모달 언어 모델이 이 두 단계 중 어디에서 실패하는지를 내부 표현으로 분리한다.[2]
객체 이름 토큰의 중간 활성화에서 좌우·상하·거리 좌표를 읽어내고, 그 좌표를 명시적으로 회전시키면 모델이 직접 말한 답보다 정확한 판단을 얻을 수 있다는 연구다.[2]
S-Space: Exploring Spatial Workspace in Multimodal Language Models는 2026년 10월 9일 arXiv에 공개된 MirroS 기술 보고서다.[2]
저자는 Zhiyuan Shi 등 11명이며 논문은 MirroS, Tsinghua University, Peking University를 소속 목록으로 제시한다.[2]
공개 저자·소속 블록에는 개인별 대응이 표시되지 않아 특정 저자를 특정 기관에 임의로 연결하지 않는다.[1][2]
이 글의 핵심은 “모델 안에서 완전한 3D 세계 모델을 발견했다”는 선언이 아니다.[2]
정답을 말하지 못한 모델에도 쓸 만한 공간 정보가 남아 있을 수 있으며, 이를 읽어내는 일과 올바르게 계산하는 일을 구분해야 한다는 진단이다.[2]
논문의 높은 시점 전환 점수는 모델 혼자 얻은 결과가 아니라, 내부 좌표 판독에 외부의 지정된 회전 연산을 붙인 결과다.[2]
무엇을 해결하려는가
최종 답만 보면 공간 오류의 원인을 구별하기 어렵다.[2]
물체 위치 자체를 잘못 보았을 수도 있고, 위치는 제대로 표현했지만 좌표계를 바꾸는 계산을 틀렸을 수도 있다.[2]
논문은 중간 활성화의 공간 성분을 직접 측정해 이 두 경우를 분해한다.[2]
S-Space는 객체 토큰 표현 안의 세 방향이 만드는 선형 부분공간이다.[2]
각 축은 좌우, 상하, 가까움·멀어짐에 대응하며 같은 모델·같은 층 안에서 여러 객체와 질문에 공통으로 사용된다.[2]
다만 축은 모델과 층마다 별도로 식별해야 하므로, 모든 모델이 같은 좌표 벡터를 공유한다는 주장은 아니다.[2]
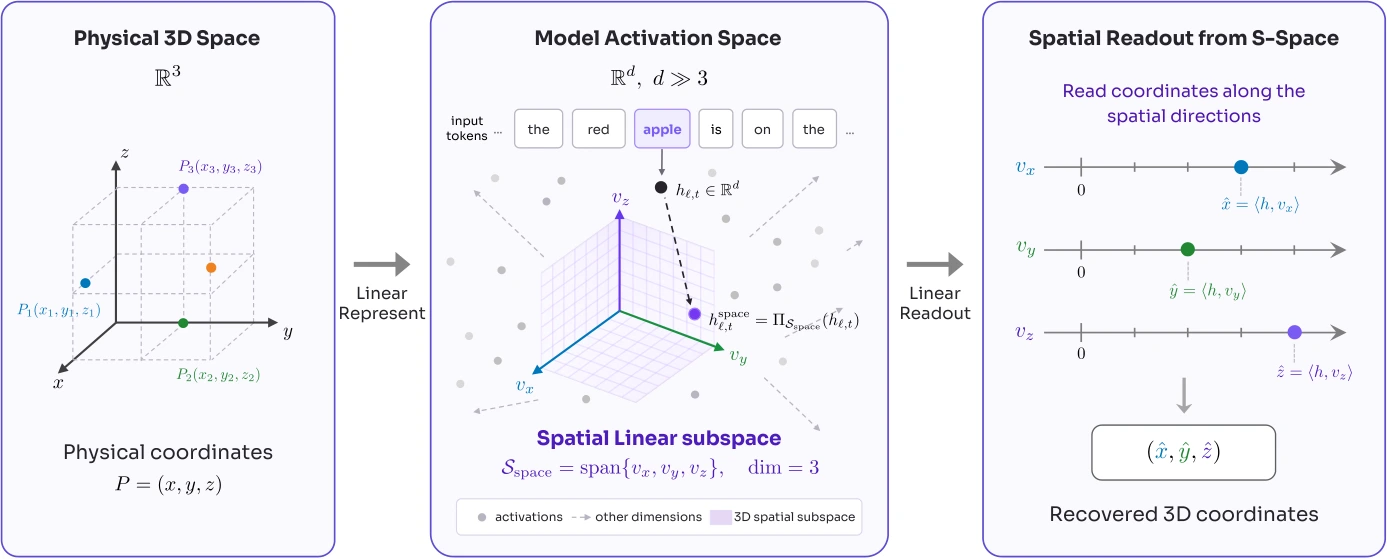
논문 그림 2.
객체 이름 토큰의 고차원 표현에서 세 공간 방향으로 투영해 좌표를 읽는다.
원본 영문 표기는 유지했다.
모바일에서는 그림을 좌우로 밀거나 눌러 확대하면 세부 수식을 볼 수 있다.[2]
공간 축을 찾고 읽는 방법
축 식별에는 상대 위치 질문을 쓴다.[2]
예를 들어 “사과가 컵의 왼쪽인가, 오른쪽인가?”
에서 right와 left의 출력 로짓 차이를 객체 토큰 활성화에 대해 미분한다.[2]
질문 대상 객체의 기울기에서 기준 객체의 기울기를 빼고, 두 객체의 순서를 바꾼 질문과 여러 템플릿에 걸쳐 평균을 내면 역할·문구에 덜 의존하는 방향을 얻는다.[2]
실험은 COCO-2017의 6,000개 이미지·객체 쌍으로 축을 식별하고, 별도의 1,800개로 판독 층을 선택한다.[2]
각 축에 다섯 질문 템플릿과 두 객체 순서를 사용하며, 객체 이름이 여러 토큰이면 마지막 토큰의 활성화를 읽는다.[2]
가로·세로 기준값은 객체 경계 상자 중심이고, 거리 기준값은 Depth Anything V2-Small이 추정한 역깊이를 객체 마스크 안에서 평균한 값이다.[2]
축을 얻은 다음에는 질문마다 다시 역전파할 필요가 없다.[2]
한 번의 순전파에서 객체 표현 h를 세 방향 행렬 V에 투영한 c = Vᵀh가 좌표 판독값이고, 두 객체의 해당 축 좌표 차이의 부호로 상대 위치를 판단한다.[2]
공간 질문 대신 객체 색을 묻는 문맥에서도 같은 축으로 위치를 읽을 수 있다는 점이, 특정 질문에만 맞춘 판독기와 구별되는 근거다.[2][3]
좌표 해석에는 중요한 경계가 있다.[2]
가로·세로는 세계 좌표가 아니라 영상 평면의 위치이며, 깊이에 따른 원근 효과를 명시적으로 분리하지 않는다.[2]
거리 축도 미터 단위의 실제 거리 복원이 아니다.[2]
따라서 S-Space를 그대로 로봇 제어용 정밀 3D 좌표 센서로 취급하는 것은 논문의 실험 범위를 넘는다.[2]
관측 가능한 정보와 실제 사용하는 정보
정확한 판독이 언제나 더 좋은 답은 아니다
논문은 CV-Bench의 관계·깊이 질문 1,250개, EmbSpatial의 균형 표본 1,200개, SpatialTunnel의 1,200개에서 공간 판독을 평가했다.[2]
축과 층은 COCO에서 정했으며, 이 벤치마크들은 판독의 일반화를 확인하는 용도다.[2]
CV-Bench에서 Qwen3.5-4B는 직접 답변 73.60%, S-Space 판독 89.36%를 기록했다.[2]
반면 Molmo2-ER는 직접 답변 94.40%, 판독 91.92%였고 Qwen3.6-27B도 직접 답변 93.76%, 판독 91.84%였다.[2]
즉 내부 좌표가 유용하다는 결과이지, 좌표 판독이 모든 모델과 작업에서 직접 답변을 이긴다는 결과는 아니다.[2]
인과 개입은 선택적이지만 완전히 무해하지는 않다
연구진은 이미지와 질문을 그대로 두고, 객체 활성화의 S-Space 좌표만 옮긴 다음 생성을 재개한다.[2]
공간 밖의 표현 성분은 보존하며, 두 객체를 반대 방향으로 옮기는 개입과 같은 크기의 무작위 방향 개입을 비교한다.[2]
공간 방향의 편집이 공간 답을 더 크게 바꾼다는 결과는 단순한 상관관계보다 강한 인과적 근거다.[2]
다만 효과의 크기도 정확히 읽어야 한다.[2]
Molmo2-ER의 L17, EmbSpatial 800개 예제에서 좌표 교환 강도 α=1의 상대 위치 답 유지율은 98.71%이고, 강도를 α=6으로 늘렸을 때 43.93%까지 낮아진다.[2]
같은 강도의 무작위 편집은 99.83%를 유지했다.[2]
단순한 한 번의 자연스러운 교환만으로 답이 대부분 뒤집혔다고 표현하면 과장이다.[2]
비공간 답변도 완전히 고정되는 것은 아니다.[2]
한 객체의 이동 강도를 |β|=30까지 키우면 절대 위치 답 유지율은 41.05%, 색 답 유지율은 78.13%다.[2]
따라서 결론은 “공간 답에 더 선택적으로 영향을 준다”이지, “공간을 바꿔도 나머지 능력은 전혀 손상되지 않는다”가 아니다.[2]
가장 중요한 결과: 위치 지각과 회전 계산의 분리
SpinBench에서는 현재 장면을 왼쪽·오른쪽·뒤쪽에서 본다고 가정했을 때 물체 관계가 어떻게 달라지는지 묻는다.[2]
연구진은 S-Space 좌표를 읽고, 요청된 시점에 맞는 고정 회전 행렬을 적용한 뒤 좌표 차이의 부호로 답하는 별도 파이프라인을 구성했다.[2]
이 연산은 모델이 스스로 회전 규칙을 찾아내는 과정이 아니라, 연구자가 정확한 시점 변환을 제공하는 진단용 계산이다.[2]
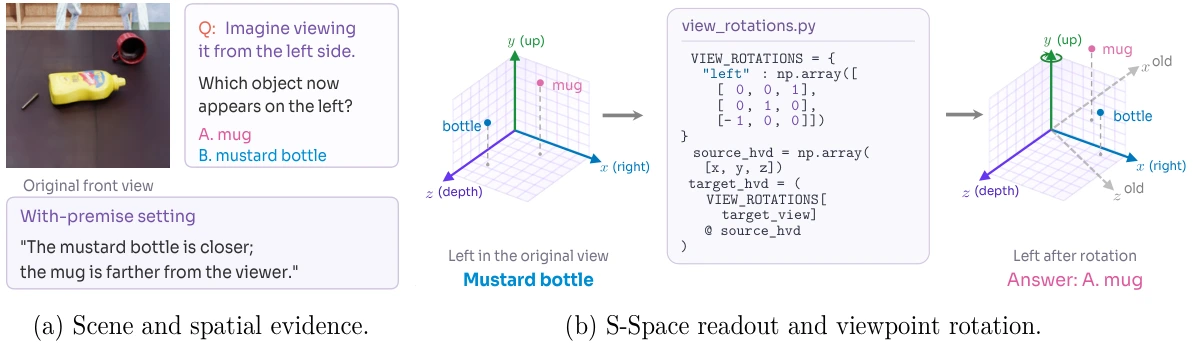
논문 그림 8.
원래 시점의 지각 정보와 새 시점으로의 계산을 분리한다.
그림의 전제 제공 조건은 원래 시점의 올바른 관계를 추가한다.
모바일에서는 좌우로 밀거나 눌러 확대할 수 있다.[2]
아래는 정답 공간 전제를 추가하지 않은 146개 질문에서의 정확도다.[2]
논문 표 1·10의 세 모델을 비교했다.
Molmo2-ER는 중간 추론 모드가 없다.[2]
- Molmo2-ER: 직접 답 60.96% → 좌표·회전 94.52%. 중간 추론 모드는 없다.[2]
- Qwen3.5-4B: 직접 답 60.96% → 추론 62.33% → 좌표·회전 91.10%.[2]
- Qwen3.6-27B: 직접 답 60.96% → 추론 83.56% → 좌표·회전 95.21%.[2]
단위는 %.[2]
직접 답은 최대 128토큰의 탐욕적 생성이고, Qwen의 추론은 최대 32,768토큰의 chain-of-thought를 허용한다.[2]
좌표·회전 경로는 COCO에서 선택한 층을 사용한다.[2]
이 표는 정확도 비교이며, 서로 다른 경로의 지연시간이나 전체 계산비용 우위를 측정한 표는 아니다.[2]
원래 시점의 올바른 공간 관계를 전제로 제공한 별도의 144개 질문에서도 차이는 남는다.[2]
Qwen3.6-27B의 직접 답변은 72.92%, 추론은 91.67%, 좌표·회전은 99.31%였다.[2]
지각 정보를 보완해도 생성 경로의 변환 오류가 완전히 사라지지 않는다는 점이 핵심이다.[2]
두 전제 조건은 표본 수가 다르므로 하나의 동일 시험 전후값처럼 합치지 않는다.[2]
내부 추론을 추적할 때의 주의점
논문은 chain-of-thought가 진행되면서 객체 좌표가 요청된 시점에 맞게 변하는 징후도 보여준다.[2]
하지만 이 분석은 Qwen3.6-27B에 원래 관계, 목표 시점, 회전 후 관계를 담은 수동 템플릿을 제공한 통제 실험이다.[2]
두 관계를 벤치마크 정답으로 채웠으므로, 자연 발생한 자유 추론이 정답 좌표계를 독립적으로 찾아냈다는 증거로 해석하면 안 된다.[2]
또 다른 분석에서는 동쪽·북쪽 같은 방위 단어가 오른쪽·위쪽 같은 영상 상대 방향과 얽혀 나타났다.[2]
보이지 않는 공이나 관찰자의 위치, 정치적 좌우 개념의 투영 사례도 제시한다.[2]
이런 사례는 시각과 언어가 공유하는 공간적 표현의 가능성을 보여주지만, 언어 학습이 S-Space를 만들어냈다는 설명 자체는 가설과 사례 분석이며 학습 과정을 통제한 인과 실험은 아니다.[2]
공개 코드와 재현 범위
공식 저장소는 단순한 예고 페이지가 아니다.[4]
모델별 사전 식별 축, 실험 설정, 데이터 준비와 축 구성·벤치마크·인과 개입·SpinBench 실행 명령을 포함한다.[4]
공개 축은 sspace/core/artifacts/pretrained/ 아래에서 확인되며, 기존 축을 사용하면 매번 6,000개 예제로 재구성할 필요가 없다.[4]
설치는 CUDA 호스트와 uv를 전제로 한다.[4]
설치 스크립트는 Molmo2, MolmoAct2, Qwen용 세 환경을 만들고 주요 모델과 보조 모델을 준비하므로, 가벼운 CPU 데모와는 다르다.[6]
패키지 메타데이터 버전은 1.0.0이지만 조회 시점의 GitHub Releases와 태그는 없어, 안정화된 배포판과 연구 코드의 버전 표기를 구분할 필요가 있다.[4][5][6]
코드는 Apache-2.0이며 논문은 CC BY-NC-SA 4.0으로 공개됐다.[1][4]
모델·데이터셋의 이용 조건은 각각 별도 확인해야 한다.[2]
이 글은 공개 자료와 코드 구조를 검토했으며 GPU에서 모델을 실행하거나 논문 점수를 독립 재현한 결과는 아니다.[1][4]
실무 관점에서의 해석
S-Space가 제안하는 가장 유용한 설계 관점은 지각, 상태 표현, 좌표 변환, 답변 생성을 별도로 평가하자는 것이다.[2]
공간 에이전트가 틀렸을 때 더 긴 프롬프트나 더 큰 모델부터 투입하기보다, 이미 표현된 위치 정보가 충분한지와 그 정보 위에서의 계산이 정확한지를 나눠 점검할 수 있다.[2]
이는 모든 공간 연산을 언어 모델 내부에 맡기는 대신, 읽을 수 있는 상태에 명시적 회전·기하 도구를 연결하는 방향을 뒷받침한다.[2]
다만 현재 결과는 선택된 모델·층과 비교적 작은 시점 전환 시험에 기반한다.[2]
정밀 물리 좌표, 일반 로봇 행동, 모든 장면과 언어에서의 안정성까지 입증한 것은 아니다.[2]
결국 이 연구의 의미는 새로운 범용 공간 모델을 출시한 데 있지 않다.[2]
모델이 가진 정보와 그 정보를 쓰는 능력 사이의 간극을 측정 가능한 대상으로 만든 데 있다.[2]
공간 추론의 다음 개선은 더 많은 지각 정보뿐 아니라, 이미 가진 정보를 신뢰할 수 있게 조작하는 계산 경로에서 나올 수 있다.[2]