라우터가 도메인 분류, 프롬프트 공격 탐지, 안전성, PII, 환각 등을 각각 별도 모델에 맡기면 신호마다 배포와 보정 경로가 늘어난다.[15]
vLLM-SR의 Vela 2.0은 이 판단들을 공통 질문 인터페이스에 담으려는 모델 패밀리다.[1][2]
Hugging Face 컬렉션에는 네 가지 체크포인트와 Vela Studio 데모가 연결돼 있다.[1][11]
공식 공개 글은 기술 논문을 후속 공개할 예정이라고 밝힌다.[2]
핵심은 “분류기 하나로 모든 문제를 해결한다”기보다 요청 텍스트를 읽고 여러 종류의 구조화된 질문에 답하도록 만드는 것이다.[2]
따라서 Vela 2.0의 가치는 개별 점수 하나보다 라우터 신호를 한 모델 런타임에 묶는 방식과 그에 따른 비용 변화에서 드러난다.[13][15]
무엇을 해결하려는가
Semantic Router의 기존 내장 신호는 신호별 전문 모델을 병렬로 호출했다.[15]
Vela 2.0은 Choice, Noul, Score, Span, Set 타입의 질문으로 선택, 예·아니오, 점수, 텍스트 구간, 집합 판단을 표현한다.[2]
모델은 자유 형식 답변 대신 신호와 스팬을 구조화해 반환한다.[2]
모델은 공통 요청 상태를 공유하면서 질문별 출력을 분리한다.[2]
그러므로 “한 번 호출”은 언제나 모든 질문이 하나의 동일한 Transformer 순전파로 처리된다는 뜻은 아니다.[2]
다만 Semantic Router 통합은 한 요청의 지원 신호들을 하나의 /v1/decisions 작업으로 묶는다.[15]
핵심 아이디어와 모델 구성
네 체크포인트는 같은 인터페이스를 공유하지만, 크기와 구조·추출 능력은 서로 다르다.[2][3]
- Vela-2.0-0.3B: 307M ModernBERT 인코더이며 입력 한도는 8,192토큰이고, CPU·ONNX 사용을 겨냥하면서 라우터용 span head만 제공한다.[2][3]
- Vela-2.0-0.8B: 756M Qwen3.5 하이브리드 디코더로, 16,384토큰 입력과 라우터·broad span head를 제공한다.[4]
- Vela-2.0-4B: 4.2B Qwen3.5 하이브리드 디코더이며, 입력 한도와 두 종류 span head는 0.8B와 같다.[5]
- Vela-2.0-9B: 7.9B Qwen3.5 하이브리드 디코더로, 같은 16,384토큰 입력과 두 종류 span head를 제공한다.[6]
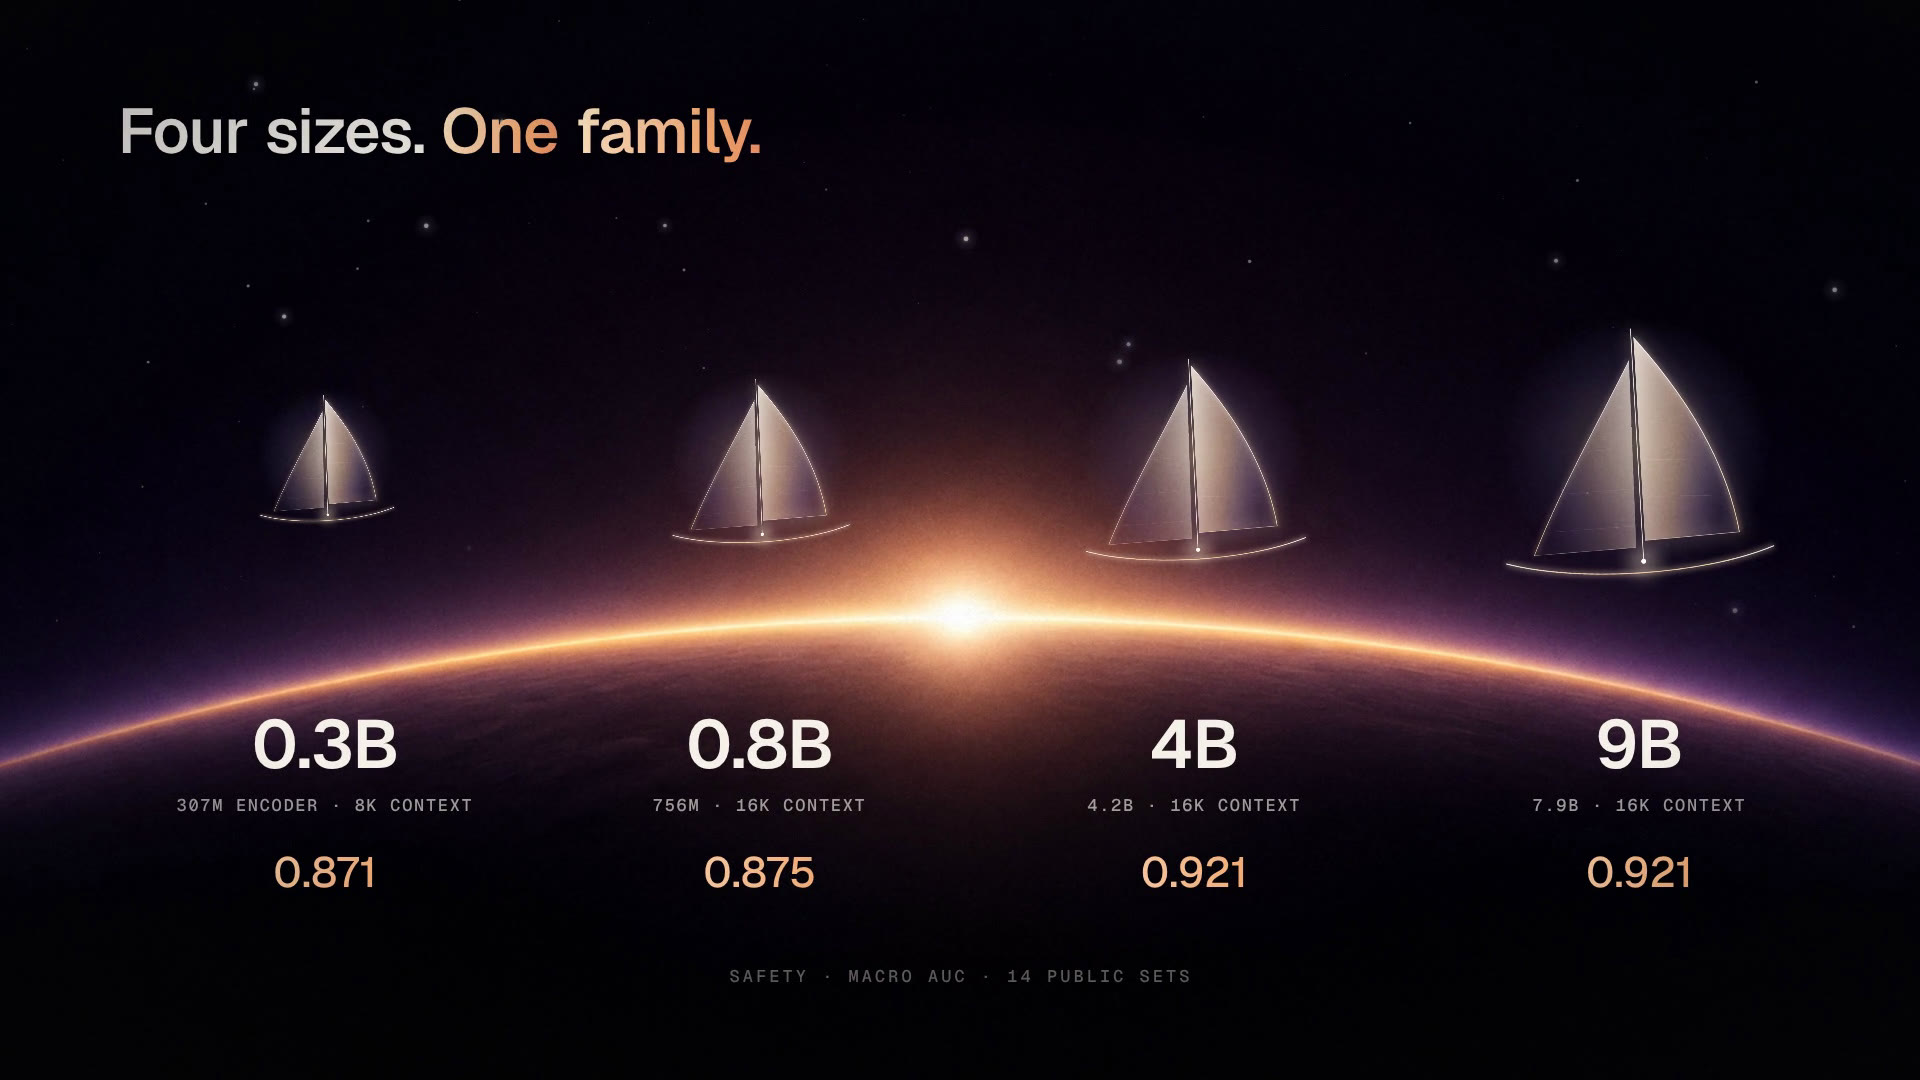
공식 Vela 2.0 패밀리 개요 그림이다.[8]
14개 안전성 세트의 macro-AUC는 평가표에 보고된 수치이며, 일반적인 미관측 작업으로의 무조건적 일반화를 뜻하지 않는다.[8]
공유 요청 상태에서 다섯 가지 질문 유형으로 분기해 구조화된 값을 반환한다.
여러 질문은 한 모델 요청에 함께 전달할 수 있다.[2][15]
공개된 근거에서 확인되는 점
모델 카드가 보고한 14개 안전성 세트의 macro-AUC는 0.3B 0.871, 0.8B 0.875, 4B와 9B 각각 0.921이다.[8]
Vela가 해당 안전성 과제군으로 학습됐고 비교 기준인 GLiNER2.5-Decide는 그렇지 않았으므로, 이 비교는 제로샷 일반화 우위를 입증하지 않는다.[8]
8K PII 추출에서 0.3B의 공개 F1은 0.929다.[7]
그러나 모델 카드의 평가 기록은 테스트 결과를 본 뒤 최저 임계값을 낮췄다고 공개한다.[7]
테스트를 보지 않고 보정한 경로의 점수는 0.896이므로, 0.929를 순수한 미관측 테스트 성능처럼 읽으면 안 된다.[7]
디코더 계열의 broad span head는 7개 개체명 인식 세트에서 0.8B 28.9, 4B 40.7, 9B 43.5의 F1을 보고했다.[8][9][10]
같은 공식 비교에서 GLiNER2.5-base는 55.9였지만, ACL-Verbatim 증거 구간 추출에서는 Vela 9B가 24.5 word-F1을 기록해 GLiNER 계열보다 높았다.[8][9][10]
즉 Vela의 장점은 모든 추출 과제에서의 우위라기보다 여러 출력 유형을 한 패밀리로 다루는 데 있다.[8][9][10]
Vela 2.0의 실제 통합은 공개 글의 로드맵보다 빠르게 진행됐다.[2][13]
2026년 10월 7일 병합된 Semantic Router PR #4702는 0.3B를 기본 내장 신호의 모델로 설정했다.[13][14]
도메인, 프롬프트 가드, 안전성, 팩트체크, 사용자 피드백, 모달리티, PII, 환각 판단은 한 배포·한 요청 번들로 처리된다.[13][15]
Hazard와 임베딩·Omni·재순위화 모델은 이 경로에 포함되지 않는다.[15]
이 선택은 무조건적인 성능 개선으로 발표된 것이 아니다.[13]
프로젝트의 같은 CPU 비교에서 AMD EPYC 9575F 12코어, 캐시 비활성화, 539개 요청 조건의 순차 처리 p50은 Vela 1.0 전문 모델들의 16.2ms에서 Vela 2.0 0.3B의 79.5ms로 늘었다.[15]
처리량은 초당 38.9건에서 11.9건으로 낮아졌다.[15]
이 수치는 특정 CPU와 평가 설정의 결과이지 다른 장비의 지연시간 예측치는 아니다.[15]
별도의 이전 비교에서는 Vela 1.0 전문 모델들이 새 Python 런타임에서 p50 15.5ms, 구형 in-process 경로에서 53.4ms를 기록했다.[16]
두 기록은 비교 대상이 다르므로 수치를 한 실험의 전후값처럼 합쳐 해석하면 안 된다.[15][16]
신호별 정확도도 엇갈린다.[13][15]
프로젝트의 paired 평가에서 안전성 AUC는 +0.052, 프롬프트 가드 AUC는 +0.026 개선됐다.[13][15]
반면 모달리티 AUC는 −0.180, 팩트체크 AUC는 −0.101, 도메인 정확도는 −0.037 하락했다.[13][15]
사용자 피드백 정확도도 미관측 세트에서 −0.038, 새 세트에서 −0.178 낮았다.[13][15]
PII와 환각은 미관측 세트에서 대체로 동률 범위였다.[13][15]
CPU 통합 프로파일은 요청 텍스트를 최대 8,192 토큰까지만 읽고 초과 부분을 잘라낸다.[15]
프로젝트 기록에는 22,541 토큰 뒤에 배치된 공격이 점수 0.58을 받아 0.75 임계값 아래로 내려간 사례가 있다.[15]
기존 Vela 1.0 Guard는 윈도 방식으로 32K까지 검사했다.[15]
긴 입력을 다루는 프롬프트 방어에서 이 차이는 도입 전에 직접 시험해야 할 제한이다.[15]
실무 관점에서의 해석
Vela 2.0의 실질적 이점은 “한 호출이면 더 빠르다”가 아니라, 여러 라우터 신호를 하나의 질문 모델과 배포 경로로 구성할 수 있다는 점이다.[13][15]
반대로 공개 CPU 벤치마크에서는 지연시간과 처리량이 악화됐고, 작업별 성능도 서로 다른 방향으로 움직였다.[13][15]
CPU 지연이 중요하거나 긴 프롬프트를 검사해야 한다면 전문 모델을 즉시 대체하기보다 신호별 오버라이드와 자체 평가를 유지하는 편이 안전하다.[13][15]
배포 성숙도도 구분해서 볼 필요가 있다.[11][12]
Vela Studio UI는 4B와 9B를 “examples only”로 표시하므로, 데모 화면을 네 모델 모두의 실시간 서빙 증거로 간주하면 안 된다.[11][12]
Semantic Router의 최신 태그 v0.4.0은 9월 27일 릴리스다.[17]
Vela 2.0 기본값 병합은 10월 7일이므로, 해당 변경이 포함된 버전 패키지는 별도로 확인해야 한다.[13][17]
0.3B 저장소는 Apache-2.0을 표시한다.[3][18]
다만 공식 안내에 따르면 상속된 토크나이저에는 별도의 Gemma 이용 약관과 배포 고지가 적용된다.[18][19]
따라서 모델 카드의 Apache 표기만으로 모든 파일의 조건을 동일하게 판단해서는 안 된다.[18][19]
현재 공개 자료만으로 Vela 2.0을 범용 라우팅의 승자로 결론 내리기는 이르다.[2][13][15]
더 설득력 있는 평가는 공식 논문 공개와 외부 재현, CPU·GPU별 지연, 긴 입력 처리, 신호별 자체 테스트가 쌓인 뒤 가능하다.[2][13][15]
지금은 통합 인터페이스의 이점을 원하는 팀이 기존 전문 모델을 보존한 채 카나리 비교를 시작할 수 있는, 평가와 라이선스 범위를 명시한 초기 모델 패밀리로 보는 편이 정확하다.[13][15]