이미지를 이산 토큰으로 바꾸면 세부 정보가 사라져 이해 성능도 반드시 떨어질까.
FVQ(Factorized Vector Quantization) 연구는 이 질문을 양자화 오차와 실제 멀티모달 이해 성능으로 나눠 살핀다.
특징을 더 부정확하게 복원하는 코드가 오히려 질문에 더 잘 답할 수 있다는 것이다.[1][2]
논문 제목의 ‘의미적으로 무손실’은 픽셀이나 모든 시각 정보를 완벽하게 복구한다는 보장이 아니다.[2]
저자들은 멀티모달 이해를 의미 보존의 대리 지표로 사용한다.[2]
그 실험 안에서 이산 표현을 연속 표현 수준으로 끌어올릴 수 있는지, 그리고 충분히 큰 비트 예산에서도 성능이 계속 좋아지게 만들려면 무엇이 필요한지를 묻는다.[2]
복원 오차가 작다고 더 잘 이해하는 것은 아니다
언어 모델이 받는 것은 복원된 연속 특징이 아니라 이산 인덱스와 새로 학습한 임베딩이다.[2][4]
따라서 원래 특징에 얼마나 가까운지를 재는 MSE와, 질문에 답하는 데 필요한 정보가 남았는지는 다른 문제다.
논문은 같은 QwenViT 특징에서 학습한 VQ와 8개 코드북의 RVQ를 비교한다.[2]
RVQ-Odd는 잔차 체인을 모두 계산하되, 0부터 센 1·3·5·7번 코드 인덱스만 VLM에 전달한다.[4]
이 경우 ImageNet 검증셋의 특징 복원 MSE는 0.246으로 VQ의 0.027보다 훨씬 크지만, 8개 이해 평가 평균은 60.7 대 51.2로 높다.[2]
비슷한 MSE를 가진 RVQ-Even도 0.028 / 평균 59.3으로 VQ보다 높다.[2]
이는 MSE가 모든 경우에 무의미하다는 결론이 아니라, 재구성 오차 하나를 의미 보존의 순위표로 쓰면 오판할 수 있다는 반례다.
코드북 수와 정보량도 다른 비교이므로, 오차만 독립적으로 바꾼 실험으로 볼 수는 없다.[2]
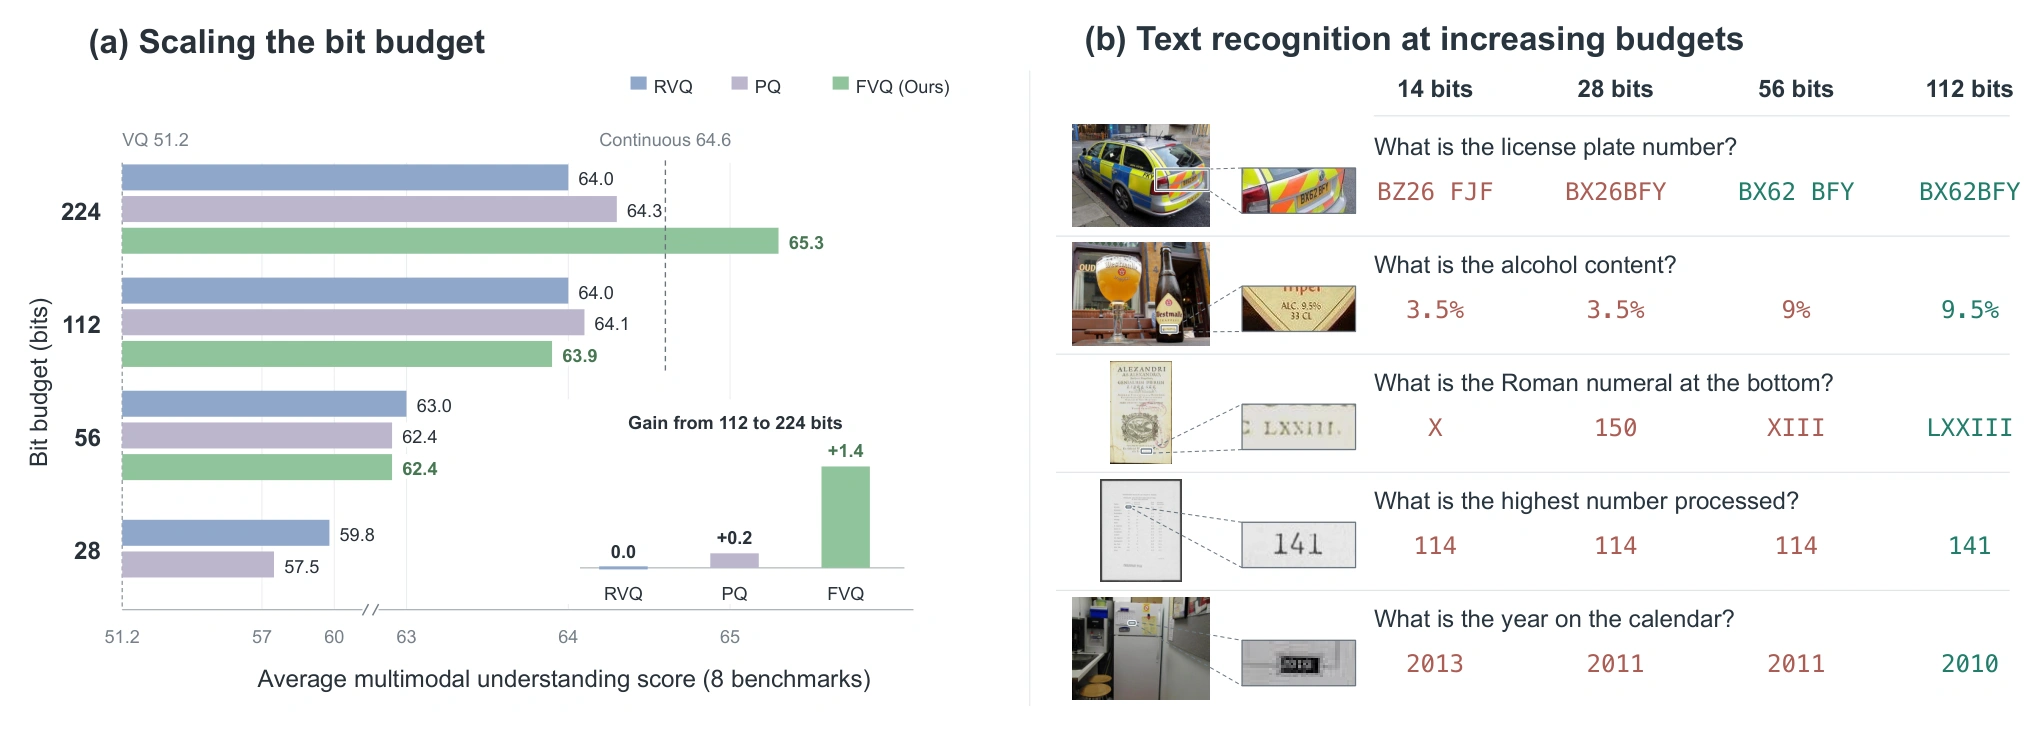
비트는 늘릴 수 있지만, 추가 코드가 유용해야 한다
코드북 하나의 크기를 C, 코드북 수를 L이라고 하면 패치당 명목 비트 예산은 B = L log₂C다.[2]
실험의 C=16,384에서는 코드북 하나가 14비트, 16개는 224비트/패치에 해당한다.[2]
코드북 크기를 키우는 것보다 개수를 늘리는 쪽이 명목 용량을 선형으로 확장할 수 있다.[2]
그러나 RVQ는 뒤 코드북이 점점 작은 잔차를 받고, PQ는 특징을 더 좁은 채널 그룹으로 나눈다.[2]
추가 코드북이 볼 정보가 약해지면 비트 수만 늘고 성능은 포화한다.[2]
아래는 같은 Qwen3-1.7B 기반 학습·평가 조건의 결과다.[2]
| 표현과 패치당 예산 | 8개 평가 평균 |
|---|---|
| VQ · 14비트 | 51.2다.[2] |
| RVQ · 112→224비트 | 64.0 → 64.0이다.[2] |
| PQ · 112→224비트 | 64.1 → 64.3이다.[2] |
| FVQ · 112→224비트 | 63.9 → 65.3이다.[2] |
| 연속 QwenViT | 64.6이다.[2] |
이 평균은 8개 벤치마크의 비가중 평균이며, OCRBench는 10으로 나눈 뒤 포함한다.[2]
FVQ는 높은 예산에서 평균 기준 연속 표현에 도달하지만 모든 세부 평가에서 앞서는 것은 아니다.[2]
예를 들어 같은 표의 OCRBench는 663 대 676, MMStar는 44.3 대 45.8로 연속 표현이 높다.[2]
FVQ는 전체 특징을 여러 관점으로 병렬 양자화한다
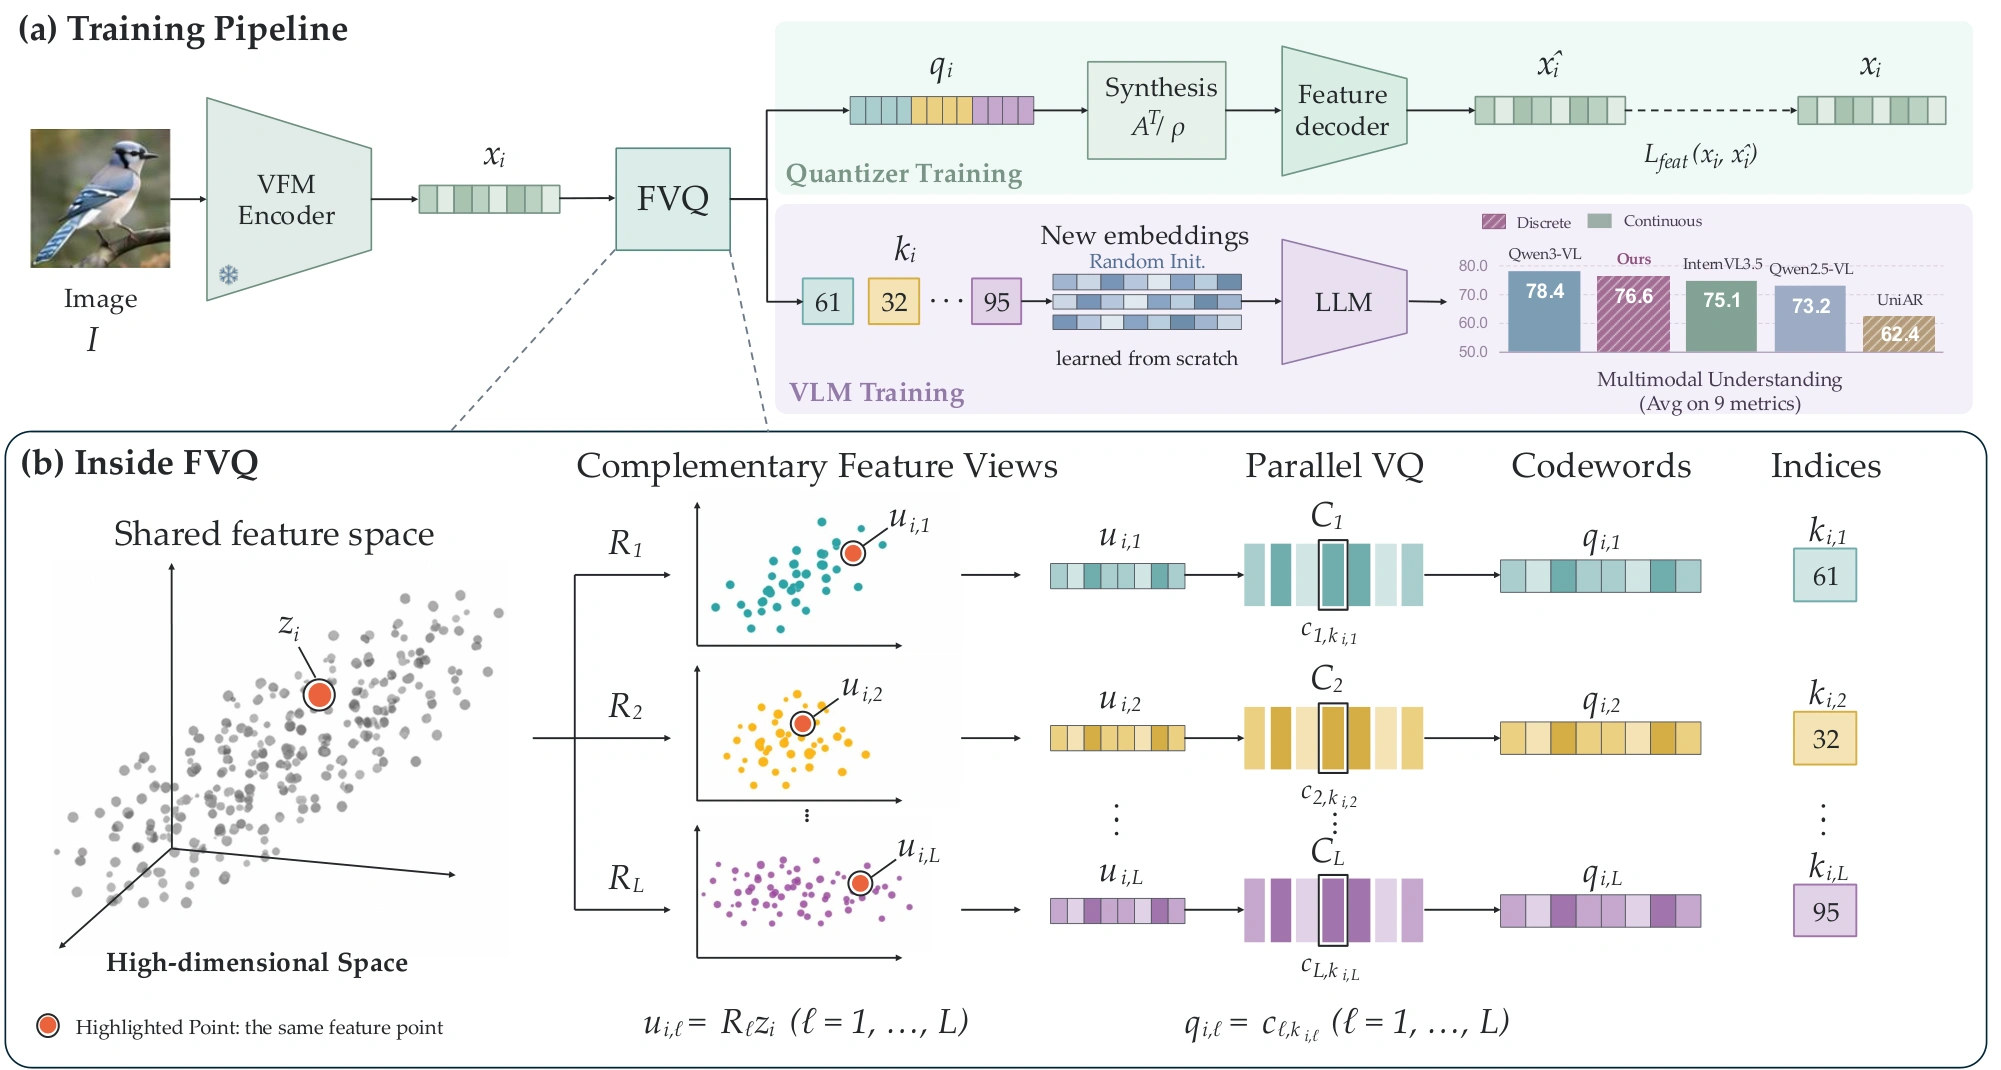
FVQ는 특징을 채널별로 잘라 배분하지 않고, 전체 특징에서 유도한 고정 차원 관점(view)을 코드북마다 준다.[2]
코드북을 늘려도 각 관점의 차원은 줄지 않고, 모든 코드북은 잔차의 앞뒤 순서 없이 독립적으로 최근접 코드워드를 찾는다.[2]
추가 코드북에도 구조적으로 동등한 역할을 주는 설계다.
관점들은 임의로 따로 뽑는 것이 아니라 tight frame 조건을 만족하도록 함께 구성한다.[2]
충분한 총 투영 차원 아래에서 고정 Gaussian 행렬의 QR 분해로 투영을 만들고, 이를 학습 중에는 고정한다.[2][3]
여러 투영을 모은 분석 연산과 합성 연산은 최근접 양자화 이전에는 원래 투영 입력 특징을 정확히 복원한다.[2]
중요한 구분은 ‘분해 자체가 추가 오차를 만들지 않는다’와 ‘양자화에도 오차가 없다’는 다른 말이라는 점이다.[2]
코드워드로 반올림하는 단계에는 여전히 왜곡이 생긴다.[2][3]
토크나이저도 픽셀 복원이 아니라 고정된 비전 인코더 특징의 재구성으로 학습한다.[2]
이미지 생성 디코더까지 학습·검증한 연구로 읽어서는 안 된다.
VLM 학습에서는 토크나이저를 고정하고 코드 인덱스만 새 시각 임베딩으로 변환한다.[2][4]
패치당 16개 인덱스가 곧 LLM 시퀀스 위치 16배를 뜻하지는 않는다.[10]
공개 구현은 그룹별 임베딩을 채널 방향으로 이어 붙인 뒤 2×2 패치를 합치는 공간 merger를 거쳐 언어 모델에 넣는다.[10]
통제 실험과 대규모 8B 결과를 나눠 본다
대표 모델은 Qwen3-8B 언어 모델 + Qwen3 ViT + 16-codebook FVQ 조합이다.[2]
언어 모델에는 표준 1차원 RoPE를 쓰고, Qwen3 ViT의 DeepStack 연결은 제거한다.[2]
즉 같은 이름의 Qwen3-VL 체크포인트를 입력 표현만 바꿔 그대로 사용한 비교는 아니다.
대규모 학습의 단계별 토큰 예산은 토크나이저 100B → 정렬 10B → 사전학습 60B → SFT 30B다.[2][3]
정렬에서는 토크나이저와 LLM을 고정하고 새 임베딩·merger만 학습한다.[2]
이후 두 단계에서는 토크나이저는 고정한 채 LLM과 시각 인터페이스를 함께 갱신한다.[2]
네 단계 합계를 LLM 자체의 학습량으로 해석하면 안 된다.
앞서 본 8개 평가의 1.7B 통제 실험과 달리, 아래는 산업규모 데이터로 학습한 8B급 시스템의 결과다.[2]
| 평가 | FVQ-8B / Qwen3-VL-8B |
|---|---|
| MMMU | 64.3 / 69.6이다.[2] |
| MathVista | 77.4 / 77.2다.[2] |
| OCRBench | 867 / 896이다.[2] |
| CharXiv-DQ | 86.1 / 83.0이다.[2] |
| CharXiv-RQ | 49.3 / 46.4다.[2] |
| DocVQA | 95.4 / 96.1이다.[2] |
논문의 UniAR 대비 +22.8%, Emu3-Chat 대비 +59.2%는 9개 지표 평균의 상대 개선율이다.[4]
퍼센트포인트 증가가 아니다.[1][4]
MMMU·MathVista·MMStar·OCRBench/10·ChartQA·CharXiv-DQ/RQ·DocVQA·InfoVQA의 평균은 FVQ가 76.6, UniAR가 약 62.4, Emu3-Chat이 48.1이다.[4][5]
Qwen3-VL-8B 평균은 78.4다.[2][5]
따라서 평균 수준의 경쟁력과 모든 평가의 우위는 다른 주장이다.
대규모 결과에는 토크나이저 설계뿐 아니라 학습 데이터와 언어 모델·인터페이스 구성도 함께 반영된다.[2]
별도로 산업규모 PT/SFT를 제외한 LLaVA-OneVision SFT 비교도 제시하며, FVQ는 그 설정에서 ViQ보다 높은 MMMU·MMStar·OCRBench·ChartQA·DocVQA 점수를 보고한다.[2][3]
이를 모든 과제의 일관된 우위로 확대할 수는 없다.
코드 공개와 학습된 모델 공개는 같은 상태가 아니다
공식 저장소에는 토크나이저 학습, 이미지 코드 추출, VLM 학습·추론 코드가 있다.[4]
하지만 확인 시점의 공식 HF 저장소는 .gitattributes만 있고 가중치 파일은 없었다.[6][9]
README가 안내하는 FVQ-Tokenizer/와 FVQ-8B/ 경로를 학습된 배포물이 이미 준비됐다는 증거로 삼을 수는 없다.[4][9]
초기화 도구도 주의해야 한다.
Qwen3-VL에서 시각 인코더를 가져와도 양자화기와 특징 디코더는 새로 초기화되며, 초기화 명령은 학습을 수행하지 않는다.[4]
따라서 공개 코드가 있다는 사실만으로 논문 수준의 8B 추론을 즉시 재현할 수 있다고 소개하면 부정확하다.
공개 stage YAML도 산업규모 실험의 정확한 재현 설정이 아니라 실행 예제라고 명시한다.[4]
해당 학습 데이터는 코드에 포함되지 않으며, 사용자가 데이터 혼합과 하이퍼파라미터를 준비해야 한다.[4]
본 글에서는 가중치 추론이나 학습을 실행하지 않았고 성능 수치는 저자 보고값으로 다룬다.
저자의 검증 문서도 기능·수치 일치의 smoke test와 새 벤치마크 평가를 구분한다.[11]
공개 경로의 검증 범위는 해당 Qwen3-VL·G16·1D-RoPE 모델군이며, 다른 시각 백본·픽셀 복원·음성·영상까지 검증한 것은 아니다.[11]
FVQ 코드의 라이선스는 Apache-2.0이다.[7]
다만 비전·언어 백본, 토크나이저 자산, 각종 의존성의 기존 조건과 고지 의무가 사라지는 것은 아니다.[8]
‘공개 예정 경로’, ‘실제 파일’, ‘실행 가능한 레시피’, ‘재배포 권한’을 각각 확인하는 편이 안전하다.
의미 보존은 복원 점수 하나로 끝나지 않는다
FVQ의 중요한 메시지는 ‘충분히 많은 비트면 모든 문제가 해결된다’가 아니다.
추가 코드가 유용한 정보를 담는 구조를 만들고, 복원 오차와 실제 이해 능력을 별도로 평가해야 한다는 것이다.[2]
비트 예산은 인덱스의 명목 용량이며, 직렬화된 파일 크기나 전체 추론 메모리·지연시간을 직접 보장하는 숫자는 아니다.
문서·OCR 예제 역시 선택된 사례다.[3]
부록은 수동으로 고른 예시를 통계적 증거로 의도하지 않았다고 명시한다.[3]
따라서 이번 결과는 이산 표현이 세부 시각 이해와 양립할 수 있다는 실험적 근거로 읽는 것이 적절하다.
픽셀 무손실 압축, 모든 이미지 질문의 완전한 해결, 이해·생성을 모두 검증한 완성형 멀티모달 모델을 뜻하지는 않는다.