대화형 LLM은 강력하지만, 소프트웨어 안에서는 자유로운 문자열이 곧바로 실행 가능한 결정을 뜻하지 않는다.[1][2] ticket을 어느 팀으로 보낼지, 기록이 정책을 만족하는지, 사람이 검토해야 하는지 같은 작업은 문장 한 편보다 정해진 선택지와 불확실성을 가진 좁은 판단을 요구한다.[1][2]
TypeSafe AI의 Jev는 이 지점에서 LLM을 정면으로 대체하기보다 다른 인터페이스를 제안한다.[1][2]
상태와 사전에 타입을 정한 질문을 받아, 텍스트 생성 대신 구조화된 결정·확률·신뢰도를 반환하는 ‘System One’ 모델이다.[1][2]
무엇을 해결하려는가
일반적인 LLM을 application control flow에 넣으려면 output parsing, schema validation, retry, ambiguity 처리, human escalation을 주변 코드가 따로 만들어야 한다.[1][2]
Jev의 출발점은 모델의 자유도를 더 키우는 것이 아니라, code가 가능한 답의 공간을 먼저 선언하고 모델에는 그 안에서의 판단만 맡기는 것이다.[1][2]
현재 문서는 text input만 지원한다고 설명한다.[2][3]
문자열·JSON object·text array를 state로 주고, app이 questions map 안에 판단할 항목을 정의하면 Jev는 같은 key 아래에 구조화된 답을 돌려준다.[3][4]
핵심 아이디어 / 구조 / 동작 방식
API의 primitive는 세 가지다.[2][4]Noul은 yes일 확률을, Choice는 app이 정의한 선택지의 확률 분포와 최상위 선택을, Score는 정의한 level들의 확률 가중 점수를 반환한다.[2][4]
Choice와 Score response에는 confidence도 포함된다.[2][4]
이 방식에서 중요한 것은 질문을 작게 쪼개고, 답을 합치는 policy는 코드에 남긴다는 점이다.[2]
예를 들어 refund workflow는 refund 요청 여부, duplicate charge 근거, policy 충족 여부를 독립 질문으로 판단한 뒤 application code가 자동 처리·추가 정보 요청·사람 검토를 결정할 수 있다.[2]
| 구분 | 생성형 LLM을 workflow에 넣는 방식 | Jev / System One 방식 |
|---|---|---|
| 모델의 기본 출력 | 문자열·코드·자유 형식 응답 | 사전 정의된 타입 값과 확률 |
| software가 해야 할 일 | parsing과 validation, failure recovery를 별도로 구축 | 질문과 허용된 answer space, 이후 policy를 코드에서 정의 |
| uncertainty 사용 | prompt로 묻거나 별도 평가기를 붙여야 함 | Choice·Score의 확률 분포와 confidence를 response에 포함 |
| 맞는 문제 | 대화, 글쓰기, code generation, open-ended planning | 분류, routing, score, extraction, conditional branching |
TypeSafe는 여러 질문을 한 request에서 병렬 평가한다고 설명한다.[1][3]
현재 Jev 1.13 문서는 request당 64k token context, 초당 250,000 token과 분당 1,200 request rate limit, input million token당 $0.042를 명시하며 output token은 무료로 표시한다.[3]
‘타입 안전’과 ‘정답’은 다른 주장이다
Jev의 product claim 가운데 가장 쉽게 혼동되는 부분은 type safety다.[1]
가능한 output과 schema를 요청에서 미리 정의하므로, 회사는 schema mismatch가 수학적으로 불가능하다고 설명한다.[1]
하지만 타입에 맞는 값이 현실에 대해서도 맞는 것은 아니다.[2]
TypeSafe 문서도 calibration은 prediction group 전체에서 uncertainty가 outcome을 반영하도록 측정하는 것이며, 단일 answer의 correctness를 보장하지 않는다고 분명히 적는다.[2]
이 차이는 실제 automation 설계에서 결정적이다.
choice: "billing"이 parsing error 없이 돌아왔다고 해서 실제 담당 팀이 billing이라는 뜻은 아니다.[2][4]
confidence threshold, business-rule cross-check, audit log, human review queue는 model response 뒤에도 남겨야 한다.[2][4]
공개된 성능 근거는 무엇인가
TypeSafe가 공개한 workflow eval은 expense claim, security incident, agent trace observability, invoice processing처럼 여러 좁은 판단을 code로 조합한 네 workflow를 기준으로 accuracy·cost·time을 비교한다.[1][5]
모든 point는 네 workflow의 동등 가중 평균이며, reference label은 GPT-6 Astra와 Claude Fable 5.1의 high-thinking response 평균으로 만든다고 설명한다.[1][5]
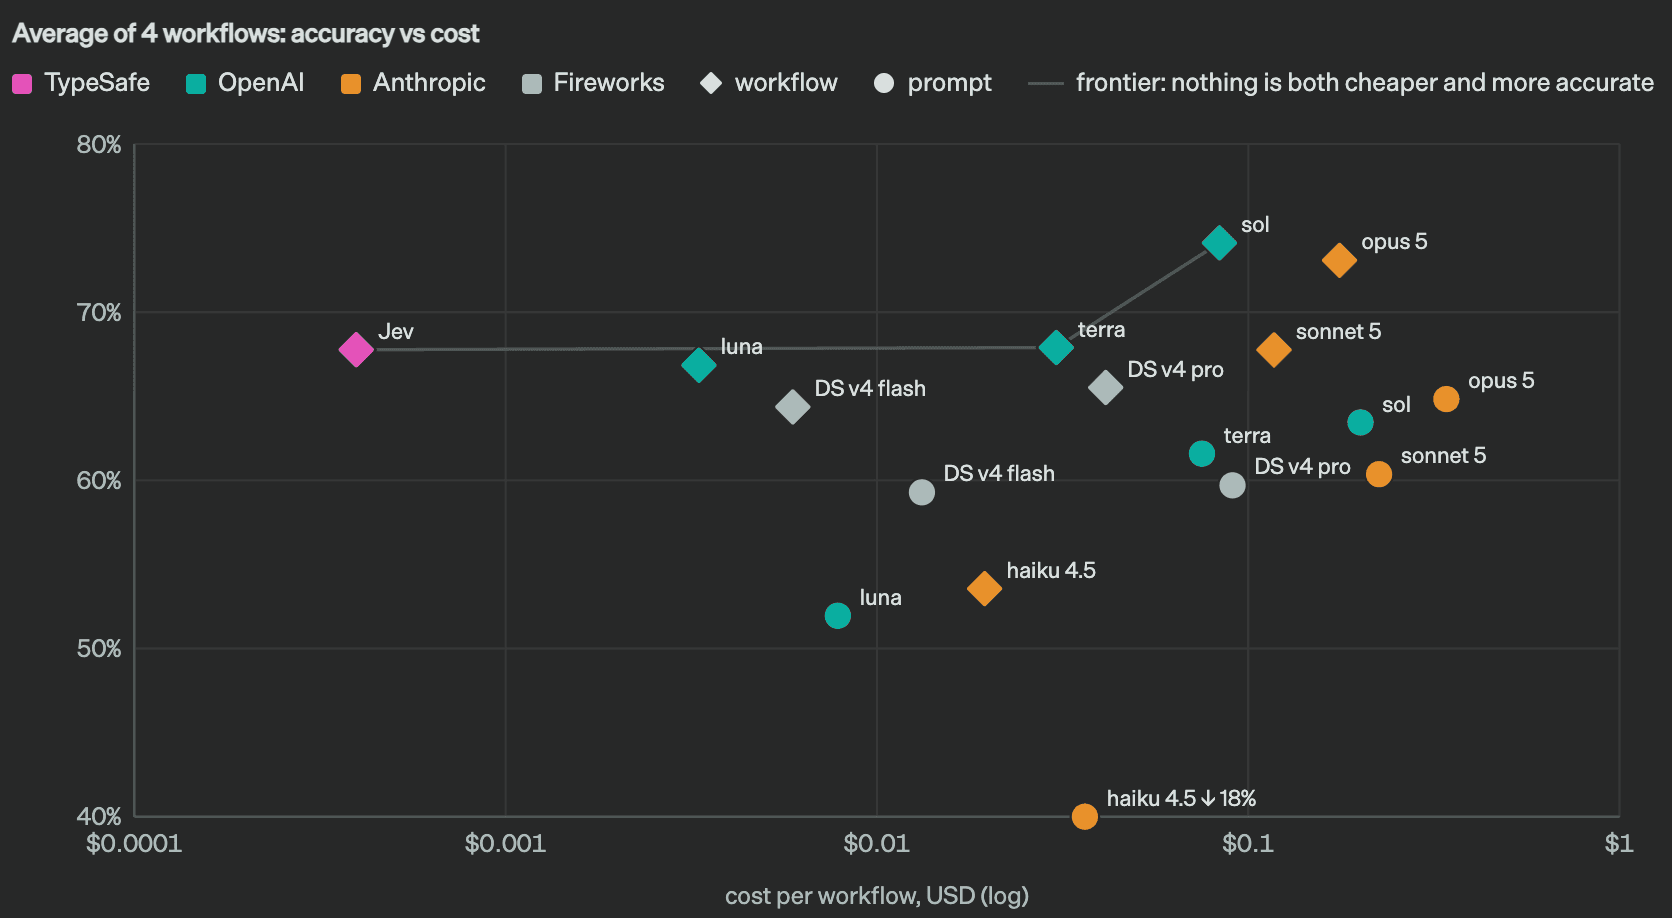
launch post는 이 설정에서 Jev가 193.6배 빠르고 444.6배 저렴하다는 최대치 성격의 수치를 제시한다.[1]
동시에 workflow가 model capability 팀 구성원에 의해 만들어져 bias가 있을 수 있고, reference answer가 OpenAI·Anthropic 계열에 치우칠 수 있으며, LLM comparison은 TypeSafe의 structured-decision adapter를 사용해 direct free-form response보다 느리고 비싸질 수 있다고 명시한다.[1][5][6]
따라서 차트는 “Jev가 모든 LLM보다 일반 지능이 높다”는 증거가 아니다.
더 정확한 해석은 TypeSafe가 정한, System One 형태로 분해된 네 workflow에서 Jev가 좋은 cost–accuracy point를 보였다는 vendor-provided evidence다.[1][3][5]
다른 language, schema, threshold, tool surface, user distribution에서는 직접 benchmark가 필요하다.[1][3][5]
제품 범위와 도입 조건
Jev는 현재 early access 제품이며, current model page는 jev-1.13.0과 alias를 안내한다.[1][3]
English가 primary training language이고 CJK도 처리하지만 동등한 정확도를 약속하지 않으므로, 한국어 workload에서는 confidence를 특히 주의하고 자체 corpus로 test하라는 것이 공식 문서의 권고다.[3]
도입할 때는 LLM prompt를 통째로 옮기기보다 반복되는 판단부터 고르는 편이 낫다.[2][4]
예를 들면 incoming request의 intent routing, evidence-backed citation check, low-confidence ticket escalation, agent trace review처럼 answer space와 후속 action을 code로 명시할 수 있는 지점이다.[2][4]
반대로 긴 설명을 쓰고, 새로운 계획을 만들고, code artifact를 고치고, 예상 밖의 상황을 열린 언어로 협상해야 하는 일은 여전히 생성형 LLM의 영역이다.
Jev의 흥미로운 점은 그 경계를 없애기보다, LLM workflow 주변의 분류·판정·가드레일을 별도의 빠른 모델 계층으로 떼어낼 수 있는지 시험한다는 데 있다.