사진 속 물체를 찾았다고 거리를 계산할 수 있는 것은 아니다.
어느 영역을 찾았는지 보여주는 그림과, 그 영역의 마스크·깊이 값을 다음 계산에 전달하는 경로가 함께 필요하다.
OpenVLHarness는 이 둘을 모델이 읽는 근거와 도구가 다시 쓰는 원본 데이터로 나누어 연결하는 멀티모달 하네스다.[2]
OpenVLHarness: Real World Visual Agentic Tool-Use with Multimodal Memory는 2026년 10월 19일 arXiv에 제출됐다.[1]
Yu Zhou 등 UCLA·Apple 연구진은 모델 가중치를 바꾸지 않고 지각·검색·Python 계산을 조합하는 구조와 22개 벤치마크 평가를 공개했다.[2]
공식 프로젝트에는 기록된 궤적 재생과 대화형 데모가 있고, 구현은 별도 저장소로 배포된다.[3][4]
중요한 구분이 있다.
이름의 persistent memory는 사용자를 여러 날 기억하는 장기 기억이 아니라, 한 질문을 해결하는 여러 턴 동안 유지되는 작업 메모리다.[2]
공개 구현도 새 질문마다 메모리를 새로 만든다.[6]
도구 호출과 근거 표현을 함께 설계한다
OpenVLHarness의 capability layer는 도구의 호출 계약과 출력 표현을 함께 다룬다.[2]
같은 visual grounding 기능 아래에 서로 다른 backend를 연결하되, orchestrator는 이미지 참조와 검색할 대상을 전달하는 공통 인터페이스를 사용한다.[2]
도구가 반환한 데이터를 그대로 프롬프트에 붙이는 것과도 다르다.
분할 마스크의 RLE 문자열이나 큰 수치 배열은 정확한 원본일 수 있어도 모델이 곧바로 이해하기 좋은 관찰은 아니다.[2]
따라서 grounding은 표시된 영역과 좌표를, 깊이 추정은 색상화된 지도를 보여주면서 원본 데이터는 따로 보존한다.[2]
기본 구성의 아홉 기능은 다음 세 묶음으로 나뉜다.[2][4]
| 역할 | 제공하는 기능 |
|---|---|
| 지각 | 확대, grounding, OCR, 깊이 추정, 카메라 궤적 |
| 검색 | 텍스트 검색, 이미지 검색, 웹페이지 방문 |
| 계산 | 저장된 중간 결과를 사용하는 Python Coding Agent |
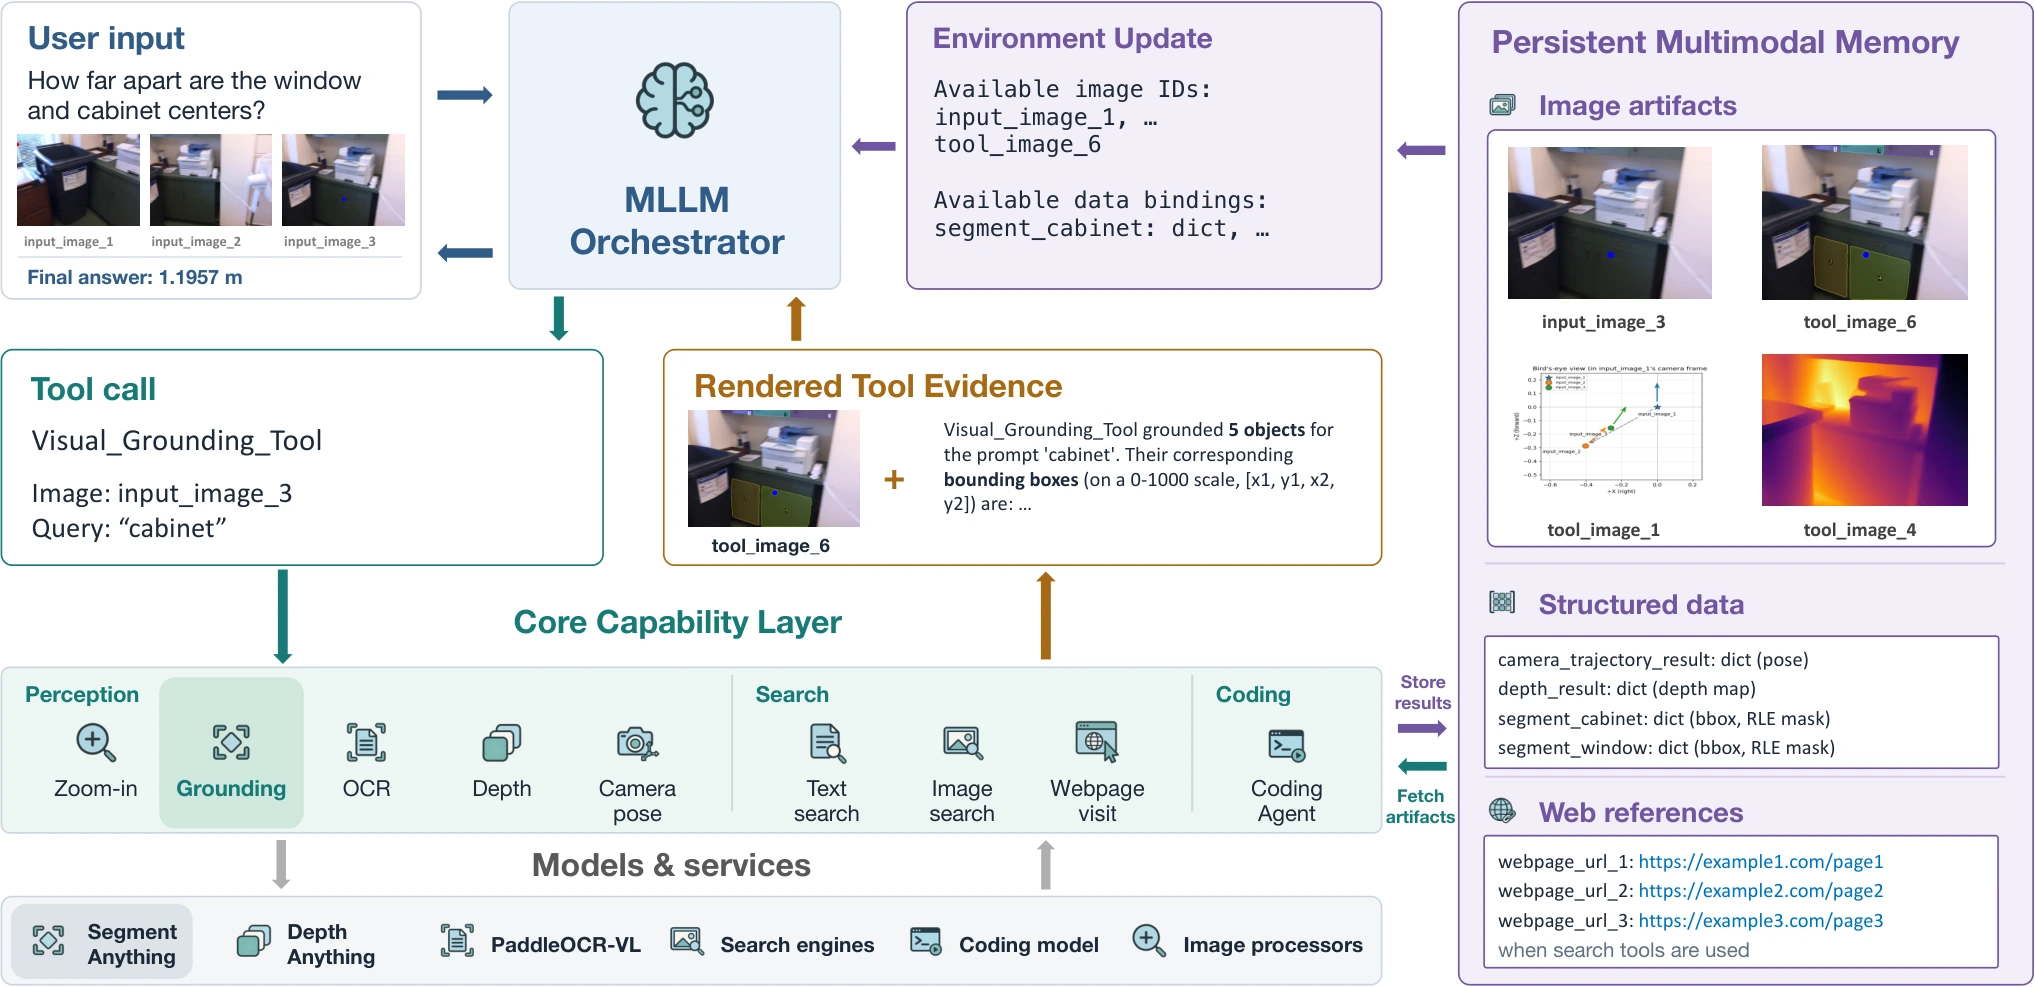
논문 그림 2(CC BY 4.0).
모델에 보여주는 관찰과 메모리에 보존하는 원본을 구분한다.
공식 고해상도 이미지의 영문 표기는 유지했다.
모바일에서는 눌러 확대할 수 있다.[2]
메모리는 설명이 아니라 참조 가능한 산출물을 남긴다
메모리 레지스트리는 입력·생성 이미지, 구조화된 데이터 바인딩, 웹 참조를 관리한다.[2]
모델에는 핸들과 간단한 설명을 보여주고, 실제 이미지·배열·마스크는 하네스가 보존해 다음 도구 호출에서 해석한다.[2]
예를 들어 input_image_3은 입력 이미지를, tool_generated_image_6은 도구가 만든 이미지를 가리킬 수 있다.[2]
webpage_url_1 같은 참조는 긴 URL을 모델이 다시 정확히 써야 하는 부담을 줄인다.[2]
각 도구 턴 뒤의 Environment Update는 사용 가능한 이미지·데이터·웹 참조 목록을 알린다.[2]
Python Coding Agent는 orchestrator와 같은 backbone을 별도 생성 컨텍스트에서 사용한다.[2]
코드 생성에는 데이터의 필드·타입·배열 모양 같은 설명을 전달하고, 실제 실행에는 저장된 값을 변수로 제공한다.[2][6]
따라서 큰 깊이 배열을 모델이 텍스트로 다시 작성하지 않고도, 마스크 안의 평균 깊이나 여러 검출 결과의 중복 제거를 계산할 수 있다.[2]
이는 모든 Python 실행 상태를 영구 보존하는 노트북과도 다르다.
공개 runtime 문서는 생성된 변수를 새 메모리 바인딩으로 자동 저장하지 않는다고 명시한다.[6]
핵심은 임의의 모든 상태를 쌓는 것이 아니라, 지원하는 산출물을 명시적인 계약으로 전달하는 데 있다.[6]
실제 궤적에서 무엇을 연결했는가
논문은 카메라 자세·깊이·grounding을 결합해 3D 거리를 계산하고, 물체를 잘라 OCR·이미지 검색으로 넘긴 뒤 웹에서 확인하는 사례를 제시한다.[2]
서로 다른 grounding 질의에서 얻은 마스크를 코드로 대조해 개수를 보정하는 사례도 있다.[2]
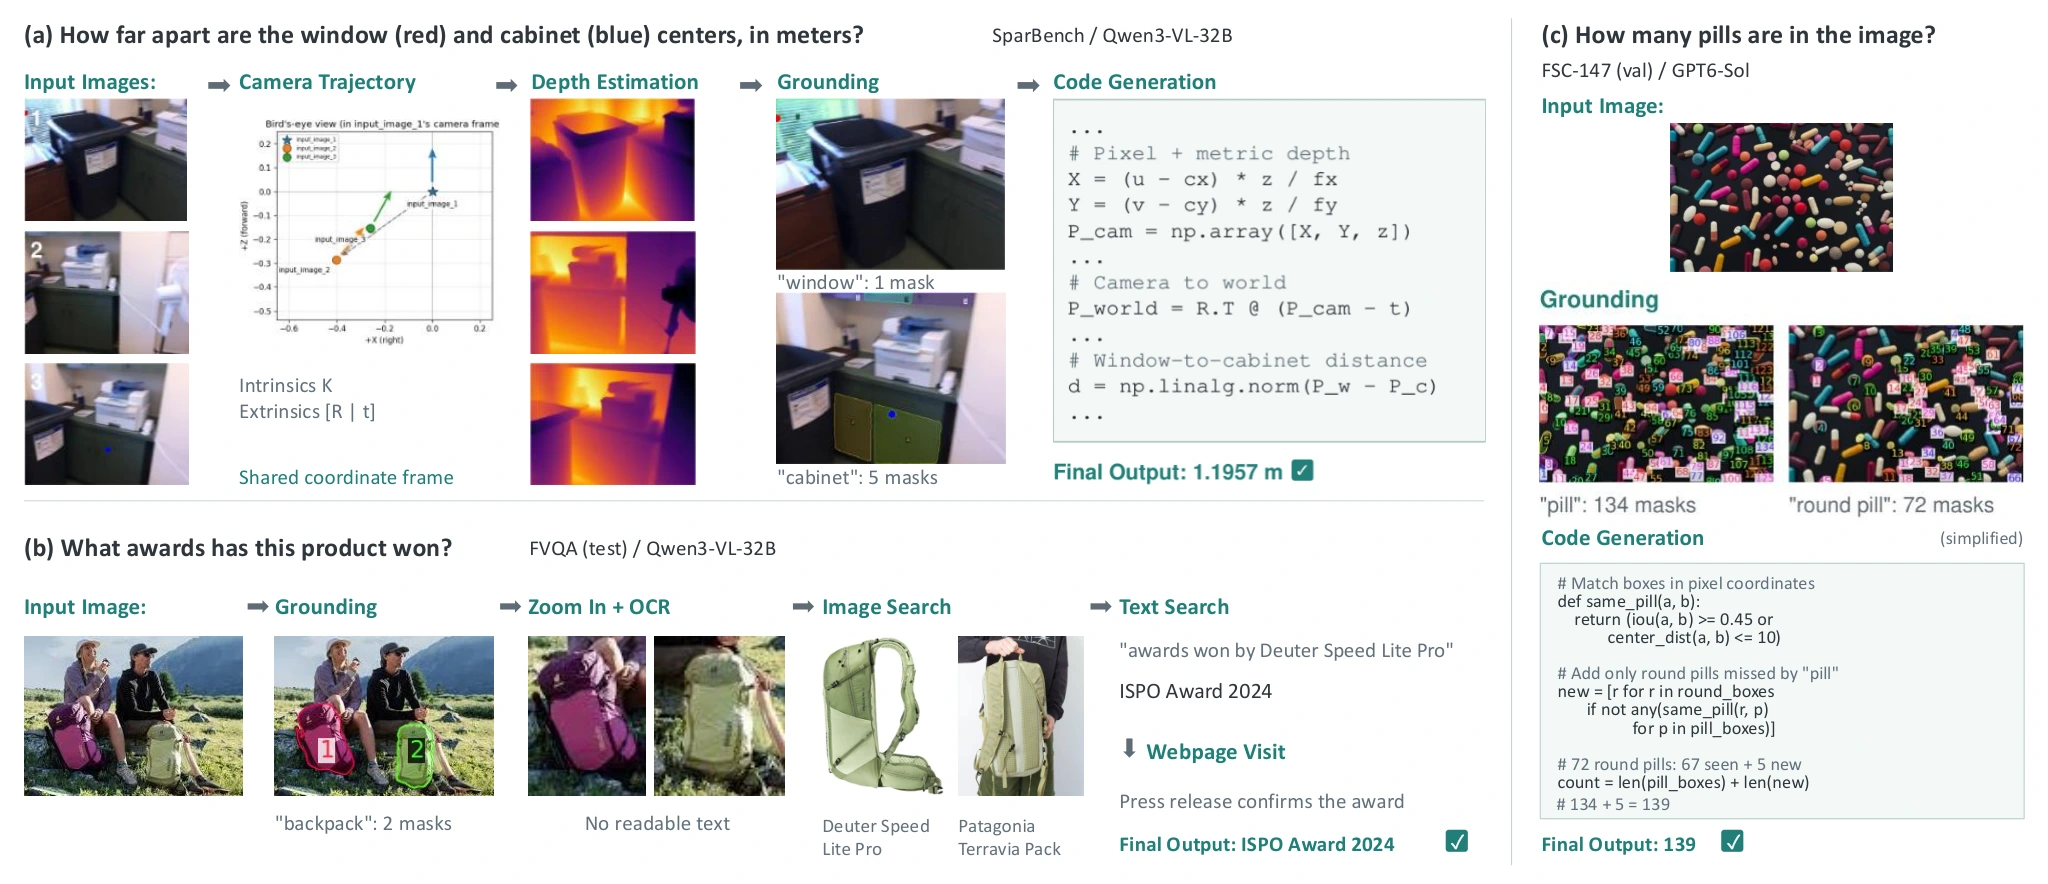
논문 그림 3.
왼쪽 위는 공간 계산, 왼쪽 아래는 제품 검색, 오른쪽은 개수 보정이다.
개별 성공 궤적은 동작 방식을 보여주는 사례이며 모든 입력에서의 정확도를 보장하지 않는다.
원본은 CC BY 4.0이며 모바일에서는 좌우로 밀거나 눌러 확대할 수 있다.[2]
이 구조의 실무적인 의미는 “도구를 많이 붙이면 된다”보다 구체적이다.
사람이 보는 시각화와 코드가 읽는 수치를 함께 유지해야, 앞 단계에서 얻은 근거가 다음 단계의 입력으로 이어진다.
다만 계산이 정확해도 검출된 영역이나 추정 깊이가 틀리면 최종 답은 틀릴 수 있다.
22개 벤치마크 결과는 어떻게 읽어야 하나
평가는 개수 세기·grounding 5개, 시각 검색·심층 조사 6개, 일반 VQA·환각 6개, 공간 추론 5개로 구성된다.[2]
평균은 AP·정확도·judge 점수의 혼합이다.[9]
실무 성공률과 같지 않다.
아래는 논문 주요 표의 22개 데이터셋 평균이다.
각 행에서 같은 backbone을 도구 없이 쓴 결과와 OpenVLHarness를 적용한 결과를 비교한다.[2]
| Backbone | 기본 → OpenVLHarness |
|---|---|
| Qwen3-VL-8B | 34.24 → 45.41 |
| Qwen3-VL-32B | 38.30 → 50.92 |
| GPT-6 Luna, medium | 45.76 → 56.52 |
| GPT-6 Astra, medium | 60.27 → 70.17 |
Qwen3-VL 결과는 세 번 실행한 평균이고, GPT-6 결과는 API 비용 때문에 단일 실행이다.[2]
추가 backbone과 Qwen2.5-VL 비교는 부록에 제시되며, 공개 배포의 논문용 preset은 여덟 backbone 중 일곱 개를 포함한다.[2][4]
평균 개선이 모든 개별 벤치마크의 개선을 뜻하지는 않는다.
예를 들어 Qwen3-VL-8B의 FREAK-VQA는 44.68 → 37.05로 하락한다.[2]
반면 GPT-6 Astra는 주요 표의 22개 벤치마크 모두에서 개선됐다.[2]
같은 GPT-6 Luna의 medium 설정에서 Codex는 43.78, Visual Sketchpad는 45.55, OpenVLHarness는 56.52를 보고한다.[2]
이 결과는 이 실험의 시각 도구·근거 전달 방식이 중요함을 보여주지만, Codex의 일반적인 코딩 능력이 열등하다는 결론은 아니다.
추론 예산 연구에서도 Codex가 실제 명령을 실행한 질문 비율은 max 설정에서 6.17%에 그쳤다.[2]
비용 37%는 전체 운영비가 아니다
추론 예산 비교에서 OpenVLHarness의 medium 평균은 56.52다.[2]
이는 기본 모델의 max 48.04, Codex의 max 48.58, Visual Sketchpad의 max 48.84보다 높다.[2]
논문이 계산한 1,000문항당 모델 토큰 비용은 각각 OpenVLHarness medium 0.92달러, 나머지 max 설정 3.17·2.52·5.15달러다.[2]
여기서 “최대 37% 비용”은 서로 다른 추론 노력 설정에서의 GPT-6 Luna 토큰 청구액 비율이다.[2]
추론 토큰과 캐시 읽기·쓰기를 포함하며 Coding Agent 호출도 집계하지만, 지각 도구 실행·검색 API·judge 비용은 제외한다.[2]
GPU 서비스와 보조 모델까지 필요한 배포 전체가 그 비용에 운영된다는 뜻은 아니다.[2][4]
같은 medium 설정의 기본 모델 비용은 0.58달러로 하네스의 0.92달러보다 낮다.[2]
따라서 정확한 해석은 “항상 더 싸다”가 아니라, 이 평가에서는 기본 모델의 생각만 길게 늘리는 것보다 근거를 획득하고 조합하는 편이 높은 점수에 도달했다는 것이다.[2]
제거 실험: 원시 도구, 읽을 수 있는 출력, 재사용 가능한 이미지
Qwen3-VL-8B의 구성별 Overall은 다음 순서로 올라간다.[2]
| 누적 구성 | Overall |
|---|---|
| 도구 없는 기본 모델 | 37.06 |
| 원시 도구 접근 추가 | 40.84 |
| capability layer 추가 | 44.23 |
| 텍스트 메모리 추가 | 44.93 |
| 전체 멀티모달 메모리 | 47.14 |
이 제거 실험은 큰 데이터셋을 최대 500개로 고정 추출하고 세 번 실행한 별도 조건이다.[2]
따라서 앞의 전체 평가 평균 34.24·45.41과 숫자를 직접 이어 붙이면 안 된다.[2]
capability layer 단계는 도구 schema 복원과 출력 후처리를 함께 바꾸므로, 차이를 시각화만의 순수 효과로 분해할 수도 없다.[2]
텍스트 메모리도 구조화 데이터·URL 참조를 제공하지만 도구 생성 이미지를 다시 이름으로 전달하지 못한다.
전체 구성은 이미지 첨부와 재사용 가능한 핸들까지 제공한다.[2]
다만 현재 공개 runtime은 이미지 메모리를 끄면 시작 단계에서 거부하므로, 논문의 모든 제거 실험이 공개 설정 한 줄로 재현된다고 가정해서는 안 된다.[6]
특화는 실패 원인에 따라 다른 변경을 요구한다
논문은 실패 궤적을 분석한 뒤 지시·설명·출력 템플릿을 고치는 harness search와, 기존 기능을 조합한 새 도구를 만드는 tool generation을 비교한다.[2]
두 방법 모두 가중치를 바꾸지 않지만, 후보 선택에는 과제 실행과 benchmark 채점 피드백을 사용한다.[2]
ERQA에서는 harness search가 4.1점 개선한 반면 tool generation은 0.2점에 그쳤다.
SparBench에서는 tool generation이 8.2점 개선하고 harness search는 0.5점 하락했다.
어떤 실패든 프롬프트를 길게 고치는 방식으로 해결되지 않는다는 근거다.[2]
추가 도구의 채택 gate는 기존 실패 사례 중 회복한 수를 확인하는 절차다.[2]
처음부터 맞혔던 사례의 퇴행까지 검증하는 지표는 아니며, 최종 표준 평가와 분리해서 읽어야 한다.[2]
이는 실패 진단 결과를 곧바로 “복구 가능한 정확도”로 해석하지 말아야 하는 이유이기도 하다.[2]
공개 구현은 어디까지 준비됐는가
저장소는 Python 3.10 이상을 지원하고, 모델·지각 서비스는 별도로 준비하는 구조다.[4]
SAM 3·PaddleOCR-VL·Depth Anything 3와 검색 API 등이 필요하며, 주 모델을 GPT나 Kimi로 쓰더라도 모든 논문용 preset은 검색 요약·웹 추출용 Qwen3-VL-8B endpoint를 추가로 사용한다.[4]
저자들은 오프라인 회귀 테스트와 저장된 응답 replay, 작은 지각·도구 연결 검증을 보고한다.[7]
하지만 validation 문서 스스로 이 작은 집합이 전체 벤치마크 성능 추정이나 통계적 동등성 검증은 아니라고 구분한다.[7]
이 글의 성능 수치도 논문 보고치를 검토한 것이며, 모델과 GPU 서비스를 직접 구동해 독립 재현한 결과는 아니다.
배포 전에는 다음 경계를 반드시 확인해야 한다.[4][5][8]
- Python 실행: 생성 코드는 호스트 사용자의 권한으로 파일시스템·네트워크에 접근한다. subprocess timeout은 sandbox가 아니다.[5]
- 도구 서비스: router와 GPU worker는 인증이 없으므로 loopback 또는 사설망에 두어야 한다.[5]
- 이미지 외부 전송: 역이미지 검색은 외부에서 읽을 수 있는 이미지 URL을 요구한다. bucket 방식에서는 업로드한 객체가 자동 삭제되지 않아 lifecycle 정책이 필요하다.[4][5]
- 라이선스: 하네스의 MIT가 모든 구성요소에 적용되는 것은 아니다. 기본 Depth Anything 3 checkpoint는 CC BY-NC 4.0, SAM 3는 별도 SAM License와 접근 조건을 따른다.[8]
OpenVLHarness의 기여는 더 긴 독백보다 검사할 수 있는 관찰과 다시 계산할 수 있는 산출물의 연결에 있다.
실제 서비스에 적용한다면 도구 수를 늘리기 전에, 산출물의 타입·참조 수명·오류 전달·외부 전송 범위를 먼저 정하는 편이 낫다.
근거를 보존하는 하네스와 그 근거가 옳은지 검증하는 절차는 함께 필요하다.