문서 내용을 JSON에 담는 것과, 업무 시스템이 요구하는 필드를 채우는 것은 다르다.[1][2]
청구서의 텍스트를 모두 읽었더라도 그중 어느 값이 공급자이고, 납기일이며, 합계인지 다시 구분해야 한다.[1]
Dharma Field Extractor는 이 후속 작업에 초점을 맞춘 문서 이미지 추출 모델이다.[1]
Dharma-AI는 2B 모델이 자체 필드 추출 평가에서 0.834를 기록하고, 비교한 네 가지 범용 모델 구성보다 높은 점수를 얻었다고 발표했다.[1][6]
핵심은 ‘작은 모델이 모든 대형 모델을 이긴다’가 아니라, 좁게 정의한 출력 계약에 맞춰 모델을 특화한다는 접근이다.
품질 수치의 의미와 비용 산정 조건, 실제 공개 배포 범위를 나눠 보면 이 발표의 가치와 한계가 더 분명해진다.
OCR의 JSON과 업무 필드의 JSON은 다르다
기존 DharmaOCR-LITE도 JSON을 출력한다.[2]
다만 주요 키는 문서의 header, text, footer, margin처럼 전체 내용을 구조화하는 데 맞춰져 있다.[2][5]
새 Field Extractor는 공급자, 문서 번호, 날짜, 표의 행별 품목처럼 업무에서 사용할 개별 필드를 추출하도록 설계됐다.[1]
따라서 차이는 JSON 여부가 아니라, 그 JSON이 어떤 데이터 계약을 표현하느냐에 있다.
발표는 두 가지 요청 방식을 설명한다.[1]
| 요청 방식 | 출력의 기준 |
|---|---|
| Open | 스키마 없이 문서의 레이블·배치·표 구조를 보고 필드를 찾아 키와 값으로 반환한다.[1] |
| Schema-directed | 지정한 키와 string, number, boolean 타입에 맞춰 값을 채우며, 표는 행과 열의 구조를 따른다.[1] |
예를 들어 시스템이 service_provider와 client_company라는 이름을 쓰면, 모델도 그 키 이름으로 결과를 반환하도록 요청한다.[1]
문서에 없는 필드는 null로 반환한다는 설명이다.[1]
서로 다른 문서 양식마다 후처리 규칙을 만드는 대신, 원하는 결과 구조를 입력에 명시하는 방식이다.
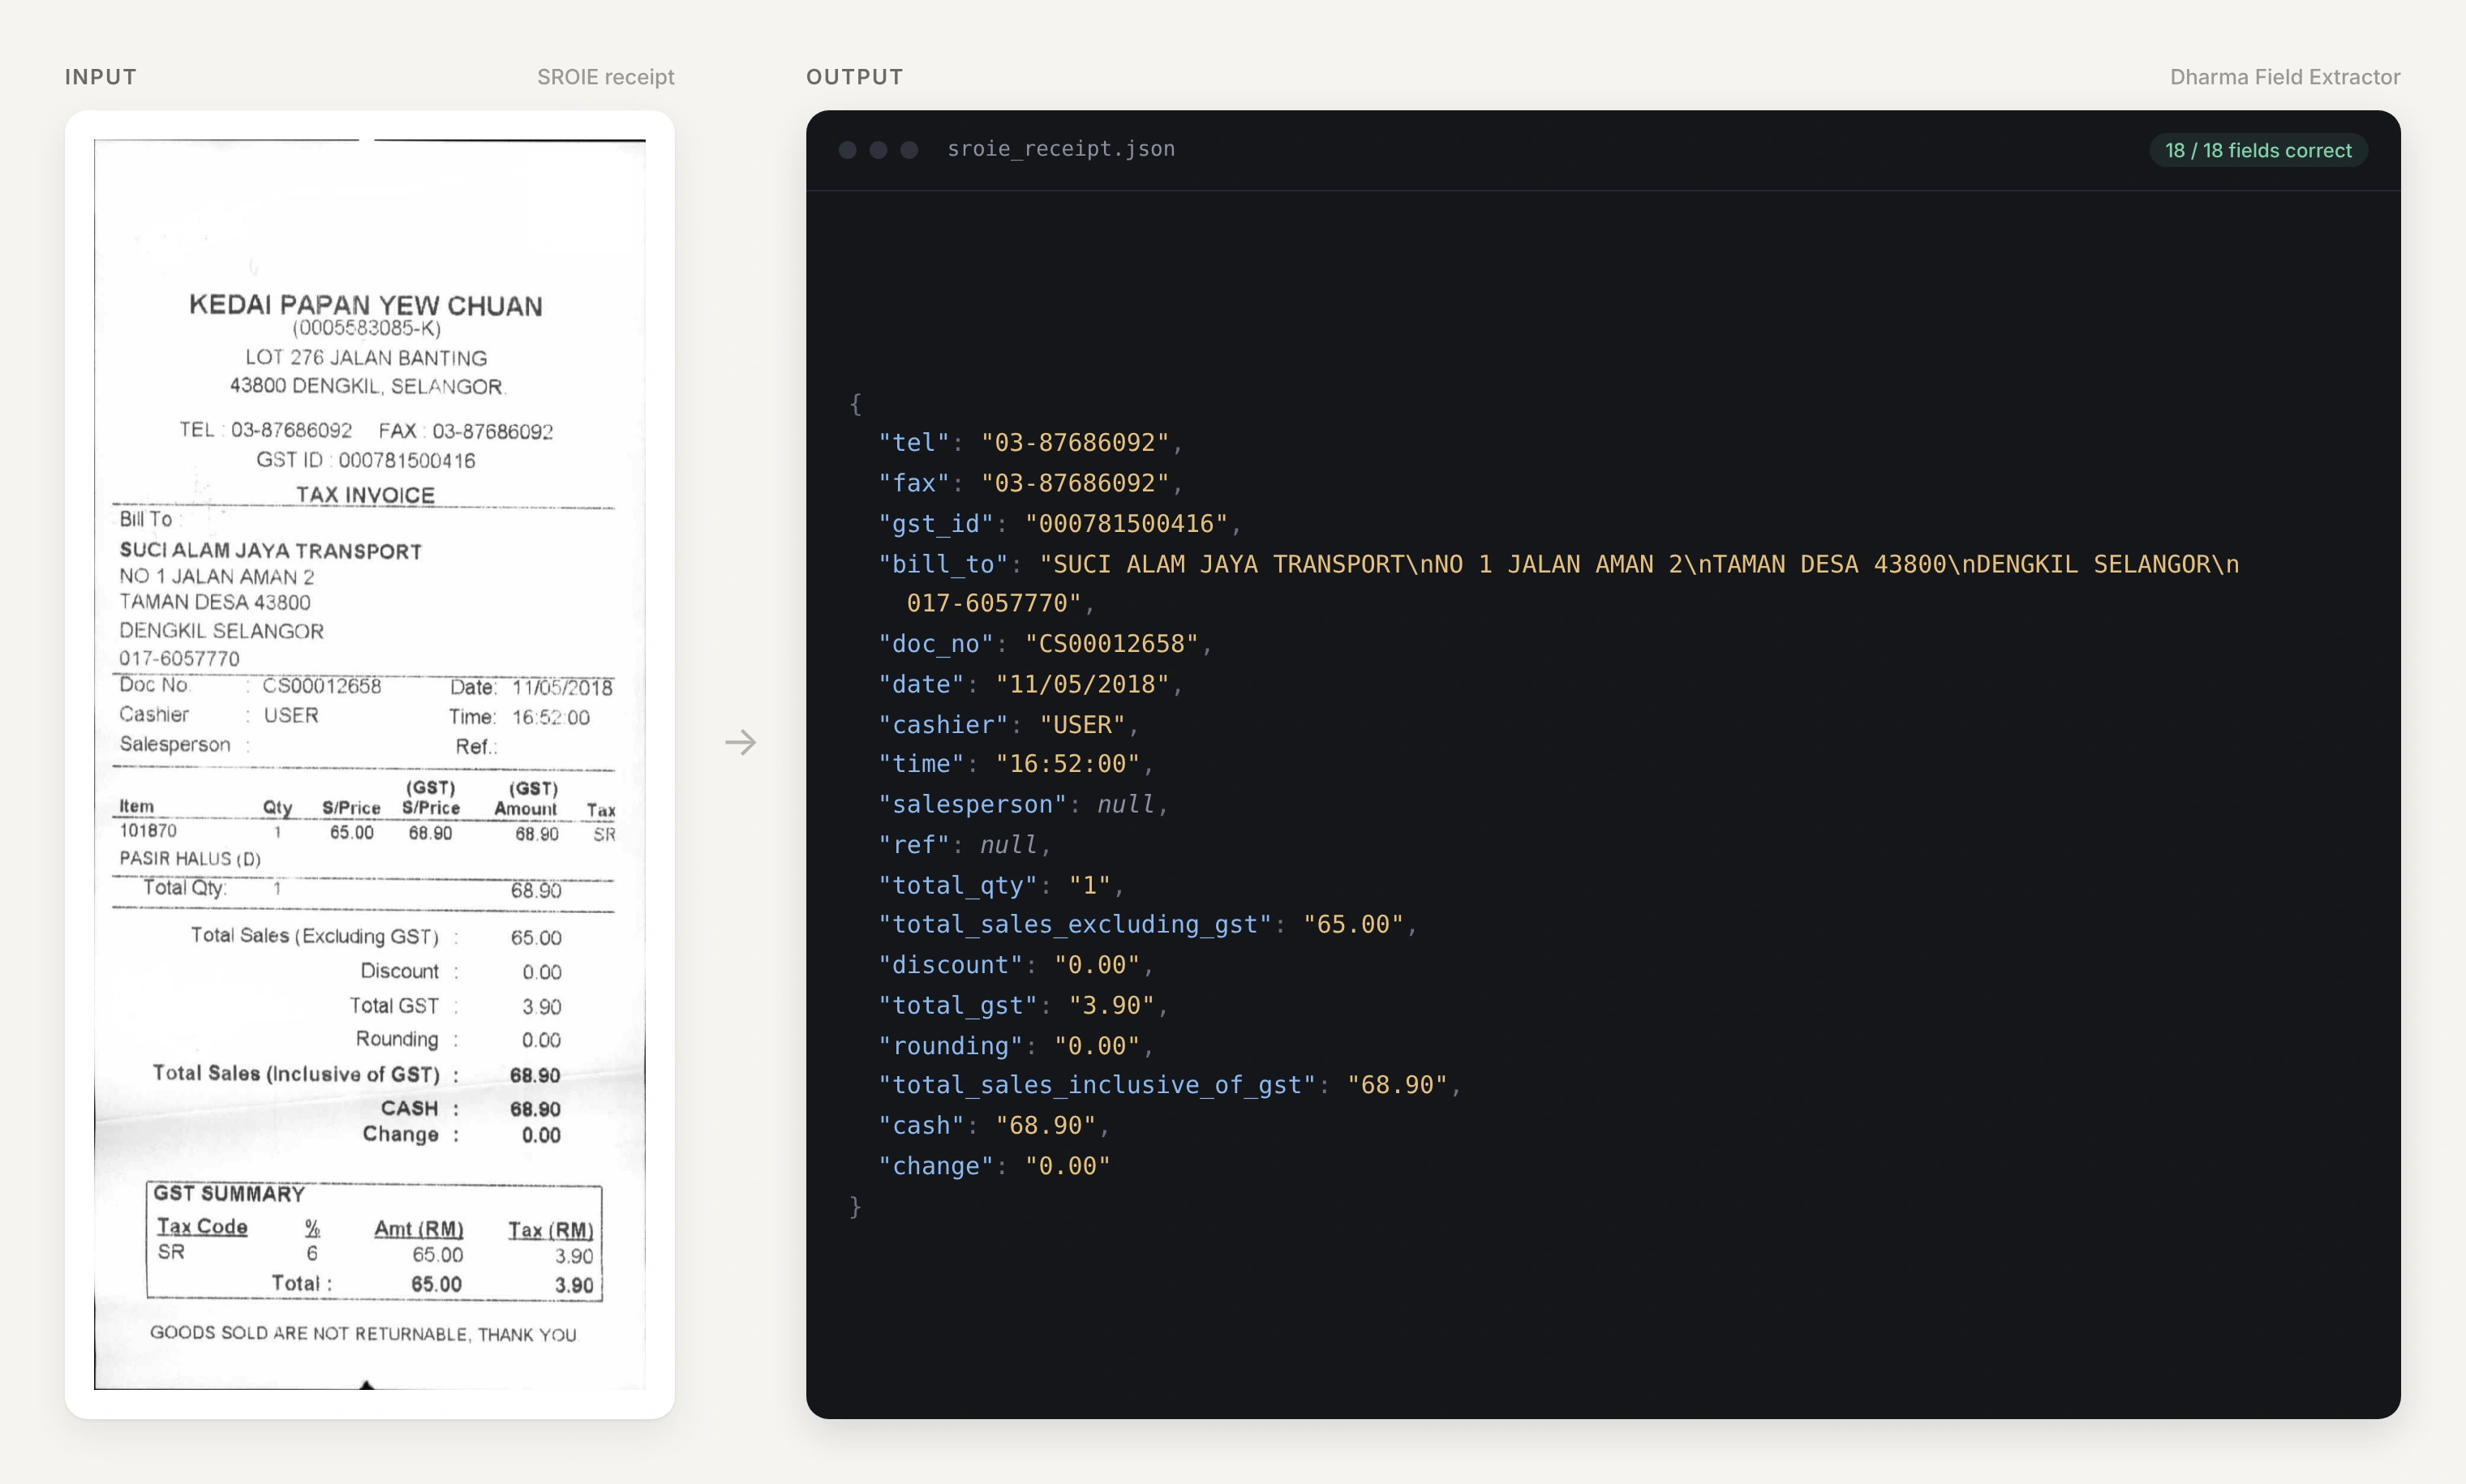
저자는 스키마와 같은 키를 사용하고 불필요한 필드를 추가하지 않는다고 설명한다.[1]
다만 공개 발표만으로 모든 입력에서의 형식 준수나 문법 강제 디코딩 구현까지 확인할 수 있는 것은 아니다.
실제 연결 단계에서는 JSON 파싱, 스키마·타입 검사, 필수값 누락 처리와 업무 규칙 검증을 별도로 두는 편이 안전하다.
OCR에 특화된 기반 위에 필드 추출을 학습한다
발표에서 기반으로 삼은 모델은 DharmaOCR-LITE v1.1의 새 2B 버전이다.[1]
OCR을 위해 SFT와 DPO를 거친 체크포인트 위에 43,384개 예제로 LoRA adapter를 학습했다고 설명한다.[1]
이전 OCR 논문과 새 필드 추출 발표의 모델 크기·평가 과제를 혼동해서는 안 된다.[1][5]
학습 데이터는 영어 다중 도메인 문서, 포르투갈어의 실제 브라질 문서, 그보다 작은 비중의 기타 유럽·아시아 언어 문서라는 세 흐름으로 구성된다.[1]
영수증, 청구서, 양식, 은행 거래내역, 신분증, 합성 문서 등에 필드 수준 주석을 붙이고 두 요청 모드를 함께 학습한다.[1]
같은 체크포인트가 문서 종류마다 별도 미세조정 없이 대응하도록 하는 설계다.[1]
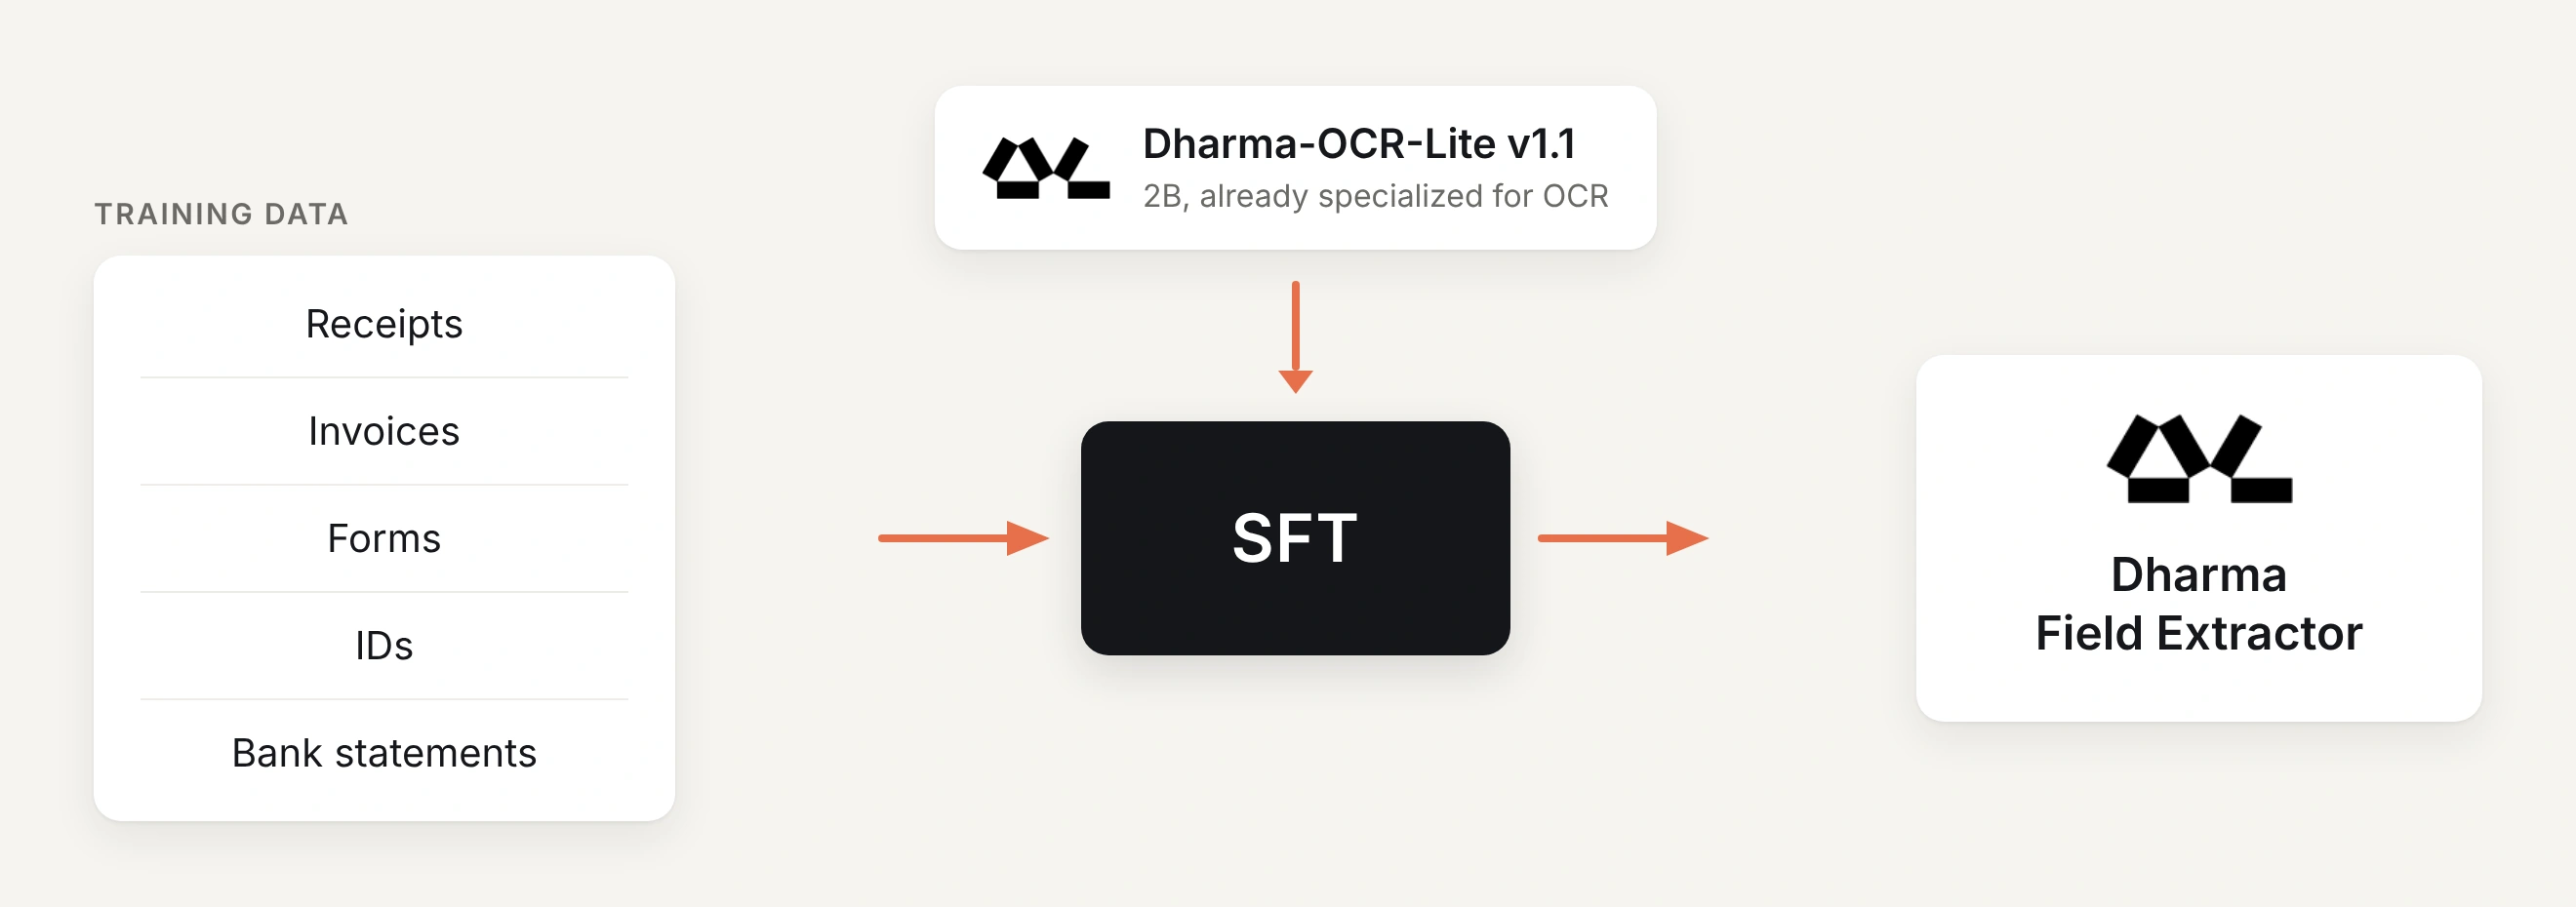
SROIE와 FUNSD는 평가에 포함하되 학습에는 사용하지 않았다고 명시한다.[1]
다만 일부 아시아 언어를 학습했다는 설명만으로 한국어 문서의 성능을 보장할 수는 없다.
한국어 계약서·세금계산서, 복잡한 다중 페이지 표처럼 실제 도입 대상의 별도 검증이 필요하다.
0.834는 문서 정확도가 아니라 복합 점수다
평가는 문서 546개에 세 가지 요청 조건을 적용한 1,638개 사례로 구성된다.[1]
조건은 스키마 없는 전체 추출, 실제 존재하는 필드만 지정한 부분 스키마, 존재하지 않는 필드도 일부러 섞은 스키마다.[1]
따라서 1,638개를 서로 다른 문서 수로 읽으면 안 된다.
점수는 필드 단위 F1 × 일치한 값의 Levenshtein 유사도 × 유효한 JSON 출력 비율이라는 설명이다.[1]
필드는 경로로 맞추며 표 안의 위치도 반영한다.[1]
값이 비슷하더라도 잘못된 키나 행에 배치하는 문제와, 출력 JSON 자체가 깨지는 문제까지 함께 보려는 지표다.
0.834를 ‘문서의 83.4%가 완벽하게 처리됐다’고 바꿔 말할 수는 없다.[1]
아래는 공식 그래프에 제시된 점수와 1,000건 추출당 비용이다.[6][7]
| 모델 | 점수 · 1,000건 비용 |
|---|---|
| Dharma Field Extractor | 0.834 · $0.26 |
| Claude Opus 5 | 0.816 · $28.48 |
| GPT-5.6 Sol | 0.811 · $38.25 |
| Gemini 3.7 Flash | 0.792 · $6.59 |
| GPT-5.6 Luna | 0.741 · $1.55 |
범용 모델은 reasoning을 low로 설정했고, Claude Opus 5는 adaptive effort를 사용했다.[1]
따라서 모든 추론 예산에서의 우위나 모든 최신 모델과의 비교를 뜻하지 않는다.[1]
가장 가까운 Opus 5와의 차이는 100점 환산으로 1.8점이며, 발표 그래프에는 신뢰구간이나 데이터셋별 세부 점수가 제시돼 있지 않다.[1][6]
이 글의 수치는 저자 보고값이며 추론을 재실행해 얻은 결과는 아니다.
6–147배의 비용 차이는 산정 방식부터 읽어야 한다
범용 API 비용은 페이지당 평균 입력·출력 토큰에 제공사의 정가를 적용한 값이며, reasoning 토큰도 포함한다.[1]
Field Extractor 쪽은 L40S 한 대의 시간당 $2.24를 기준으로 계산한 자체 호스팅 GPU 시간 비용이다.[1]
저자도 이 수치는 판매 가격이 아니며, 실제 비용은 하드웨어·처리량·지연 요구에 따라 달라진다고 밝힌다.[1]
이 조건에서 발표는 약 6–147배의 비용 차이를 주장한다.[1][7]
이는 공개 API 요금과 자체 호스팅 연산 비용을 비교한 것이지, 동일한 과금 체계의 두 API 가격표가 아니다.[1]
GPU 유휴 시간, 서비스 운영, 라이선스 계약, 예외 처리와 사람 검수까지 포함한 전체 도입 비용도 아니다.
반복되는 문서 업무를 소형 모델로 처리할 경제적 가능성은 보여 주지만, 표의 금액을 그대로 자사 처리 단가로 가져와서는 안 된다.
공개 OCR 모델과 새 추출기의 배포 범위를 구분한다
확인한 Hugging Face 공개 모델 목록과 파일 정보에서는 기존 Dharma-OCR-LITE를 확인할 수 있다.[3][10]
그 모델 카드는 3B 구조화 OCR 모델을 설명하며, 새 발표의 2B Field Extractor 및 LoRA를 동일한 배포물로 확인한 것은 아니다.[1][2]
기존 공개 가중치를 받으면 새 벤치마크의 필드 추출기를 바로 재현할 수 있다고 안내해서는 안 된다.
이번에 확인한 공식 공개 경로에서는 새 체크포인트·adapter뿐 아니라, 546개 문서의 정확한 선정 목록, 요청별 정답·스키마, 채점 코드와 모델별 원본 출력까지 갖춘 재현 패키지도 찾지 못했다.[1][10][11]
공개 모델 목록에 보이는 OCR과 기존 OCR 벤치마크는 새 필드 추출 평가와 구분해야 한다.[2][11]
공개 DharmaOCR Space의 코드 역시 기존 OCR 모델을 불러와 문서 전체를 전사하고 header, text, footer 등을 처리하는 경로다.[4][9]
새 발표의 체험 링크는 별도 로그인 포털로 이어진다.[1]
모델 다운로드, 기존 OCR 데모, 새 필드 추출 제품 체험은 서로 다른 접근 경로다.
라이선스도 주의해야 한다.
기존 공개 OCR 패키지는 DharmaOCR Lite Noncommercial License 2026을 사용하며, README도 OSI 오픈소스가 아닌 비상업 제한 배포라고 명시한다.[2][8]
기업 내부 업무, 유료 파일럿, 정부기관 이용 등에는 별도 서면 라이선스가 필요하며, 정부기관 정의에는 공공대학·공공병원도 포함한다.[8]
이 조건을 확인하지 않고 ‘공개 모델이니 사내에서 무료로 운영 가능하다’고 해석하면 안 되며, 새 Field Extractor의 배포·상용 조건은 별도로 확인해야 한다.
실무적으로 이 발표의 유용한 질문은 ‘더 큰 모델이 필요한가’보다 우리 문서의 어떤 필드를 어떤 계약으로 받아야 하는가에 가깝다.
키·타입·누락값·표의 행 순서를 먼저 정의하고, 도메인별 오류와 검수 비용을 측정하면 특화 모델의 가치를 판단하기 쉬워진다.
자체 호스팅 가능성은 데이터 통제 측면의 장점이 될 수 있지만, 외부 체험 포털에 민감 문서를 업로드하는 것은 같은 데이터 경계가 아니므로 보관·접근 정책을 별도로 살펴야 한다.