비전 인코더를 없앤다고 해서 이미지에 쓸 전용 연산까지 없앨 필요는 없다.
Unbundling Multimodal Vision Encoding이 구분한 것은 별도 사전학습, 시각 토큰 전용 파라미터, 그리고 언어와 만나기 전에 그 파라미터를 쓰는 배치다.[1][2]
공통 데이터와 연산 예산에서 비교하자, 전용 파라미터를 백본 초반으로 옮긴 in-fusion은 독립 인코더와 비슷한 시각 질의응답(VQA) 점수를 냈다.[2]
Ellis Brown, Chris Hoang 등이 2026년 11월 12일 arXiv에 제출한 연구다.[3]
질문의 초점은 ‘인코더가 있는가’가 아니라 누가 그 파라미터를 쓰는가, 그리고 어디서 쓰는가다.[1]
비교를 공정하게 만드는 연산 장부
| 구성 | 별도 학습 | 시각 전용 | 처리 위치 |
|---|---|---|---|
| 사전학습 인코더 | 있음 | 있음 | 융합 전 |
| 공동학습 인코더 | 없음 | 있음 | 융합 전 |
| 인코더 제거 | 없음 | 없음¹ | 공유 백본 |
| In-fusion | 없음 | 있음 | 백본 초반 |
논문 표 1의 비교 구성을 정리했다. ¹인코더 제거 조건에도 작은 패치 임베딩이 있다.
‘없음’은 인코더에 해당하는 전용 용량을 따로 두지 않는다는 뜻이다.[2]
주 실험은 Qwen3 구조를 따른 1.7B·4B 백본을 무작위 초기화하고, 독립 ViT 또는 in-fusion에 시각 전용 파라미터 약 4억 개를 배정한다.[2]
이미지는 224×224에서 14×14 패치로 나눠 256개 시각 토큰으로 만든다.
멀티모달 학습에서는 텍스트 전용 시퀀스와 이미지–텍스트 시퀀스를 70:30으로 섞는다.[2]
데이터 출처를 맞췄다는 말이 모든 학습 단계에 동일한 입력을 넣었다는 뜻은 아니다.[2]
인코더 사전학습은 같은 이미지의 원래 대체 텍스트를, 공동 멀티모달 학습은 Qwen2.5-VL-32B로 다시 붙인 캡션을 쓴다.[2]
같은 FLOPs에서도 처리 토큰 수는 다를 수 있다.[2]
논문의 ‘토큰 환산량’은 그 연산으로 같은 크기의 텍스트 모델이 처리할 수 있는 토큰 수다.[2]
누적 학습 연산량(lifetime compute)에는 별도 인코더 사전학습, 선행 텍스트 학습, 멀티모달 학습을 넣는다.[2]
계산에 넣는 것은 순·역전파의 행렬곱과 합성곱이다.
평가용 지시 튜닝, 옵티마이저 갱신, 통신, 활성값 재계산은 제외한다.[2]
Avg.
VQA는 Cambrian-7M으로 448×448 지시 튜닝을 한 뒤, 16개 벤치마크를 일반·지식·OCR/차트·시각 중심으로 묶어 네 범주 평균을 다시 평균낸 값이다.[2]
Avg.
Text는 지시 튜닝 전 체크포인트에서 12개 언어 벤치마크를 네 범주로 묶은 평균이다.[2]
사전학습으로 분류 점수가 올라가도 VQA는 다르다
저자들은 같은 ViT를 MetaCLIP 대조학습, WebSSL 자기지도 학습, Cap·CapPa 캡션 학습으로 먼저 훈련하고, 이후 백본과 함께 갱신했다.[2]
고정한 MetaCLIP 변형도 따로 비교했다.[2]
1.7B와 1.04×10²² FLOPs에서 별도 사전학습이 예산의 7.4% 또는 15%일 때 네 목적 모두 공동학습과 비슷했다.[2]
사전학습에 60%를 쓰자 VQA와 언어 평균이 모두 공동학습보다 낮았다.[2]
사전학습 비용을 0으로 간주해도 같은 결론이 나오는지 따로 확인했다.
멀티모달 단계는 약 2.7×10²¹ FLOPs로 고정하고 MetaCLIP 단계만 늘리자, 사전학습 직후 ImageNet 선형 탐침 정확도는 80.4%에서 84.4%로 올랐다.[2]
반면 최종 VQA는 사전학습이 가장 짧은 조건이 43.16, 가장 긴 조건이 41.63, 별도 사전학습이 없는 조건이 43.52였다.[2][5]
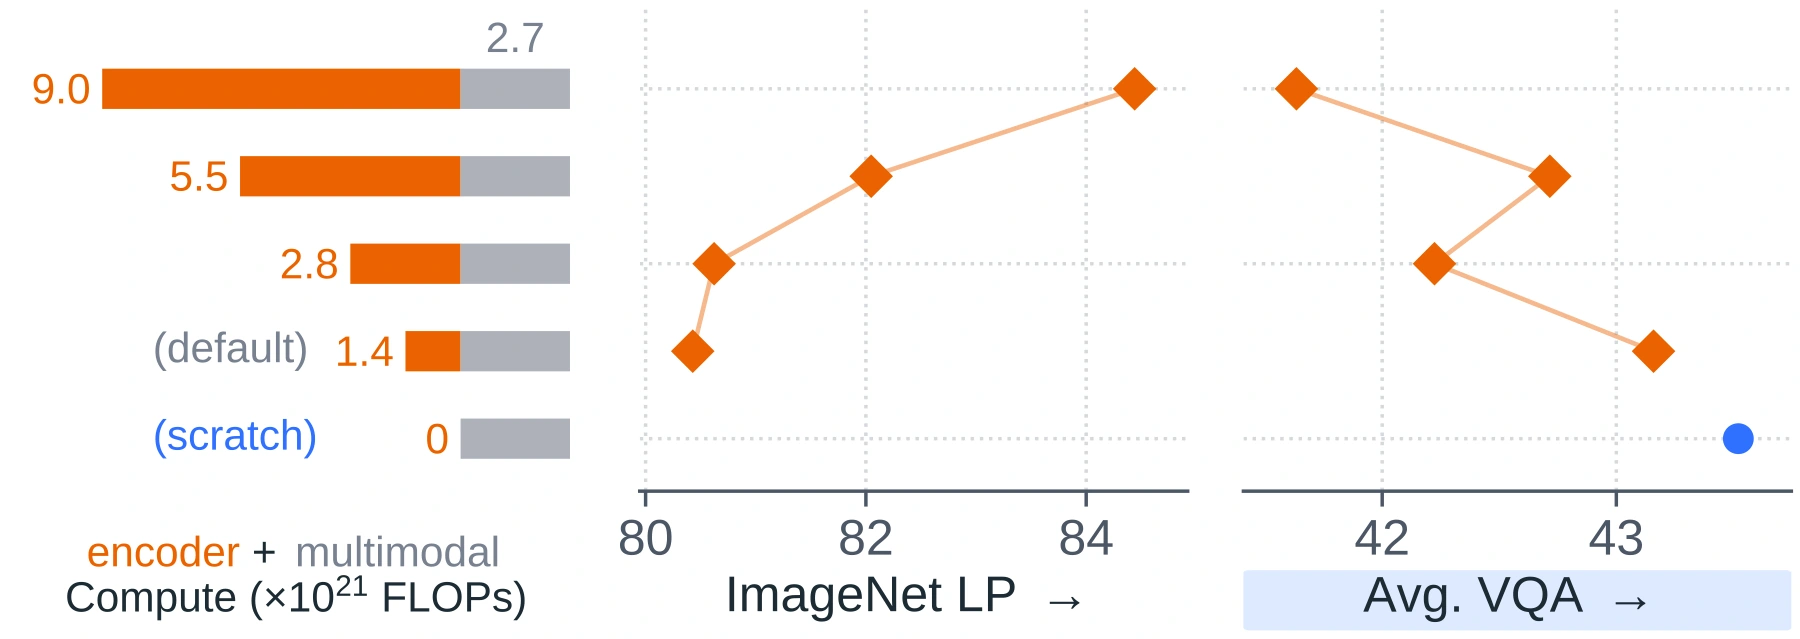
이는 같은 이미지에서 얻은 사전학습 효과에 관한 결과다.
공개 인코더가 훨씬 많은 새 데이터에서 가져오는 이점이나, 공동 사전학습을 처음부터 하기 어려운 팀에서의 초기화 가치는 배제하지 않는다.[1][2]
파라미터 수보다 누가 쓰는지가 중요했다
1.7B 백본에 2.6×10²¹ FLOPs를 쓴 표 2에서 공동학습 인코더의 Avg.
VQA는 44.4, 기본 인코더 제거 모델은 39.0이었다.[2]
OCR/차트에서 차이는 38.2 대 25.2로 더 크게 나타났다.[2]
인코더의 파라미터 4억 개를 공유 백본의 폭이나 깊이로 돌려도 VQA는 38.6~38.8이었다.[2]
반면 언어 평균은 50.7에서 51.2~51.4로 올랐다.[2]
이 차이가 오직 더 적은 토큰을 본 탓인지 확인하려고, 부록 D에서는 토큰 수를 같게 하고 넓힌 백본에 더 많은 FLOPs를 허용했다.[2]
그 조건에서는 폭에 약 8억 개를 더한 모델이 44.4로, 공동학습 인코더의 44.2에 도달했다.[2]
전용 연산 없이 불가능하다는 뜻이 아니라, 같은 예산에서 공유 용량으로 대체하기 어려웠다는 뜻이다.[2]
패치 입력에도 예외가 있다.
224×224를 쓴 주 실험에서 2층 투영은 40.5로 개선에 그쳤다.[2]
부록 D에서는 4,400만 파라미터의 계층 MLP가 640×640을 256토큰으로 압축해 공동학습 인코더와 같은 40.2를 냈다(표 21).[2]
그 비교는 5.2×10²¹ FLOPs, 표 21의 224×224 지시 튜닝 설정으로, 표 2의 44.4와 직접 비교할 수 없다.[2]
해상도와 패치 처리 방식이 함께 바뀌므로 압축 구조만의 효과도 아니다.[2]
융합 전이 아니라 백본의 첫 층에 둔다
In-fusion에서는 텍스트와 시각 토큰이 모두 공유 모듈을 지난다.[2]
시각 토큰에만 전용 Q·K·V·O 투영과 FFN 분기의 출력을 더한다.[2]
그래서 두 모달리티가 함께 어텐션하면서도, 원시 패치에 가까운 시각 토큰은 별도 변환을 받는다.[2]
추가 투영과 FFN의 출력 투영을 0으로 초기화하므로 처음에는 공유 경로와 같은 출력에서 시작한다.[2]
모달리티별 모듈을 공유 모듈 대신 사용하는 MoT와는 다르다.[2]
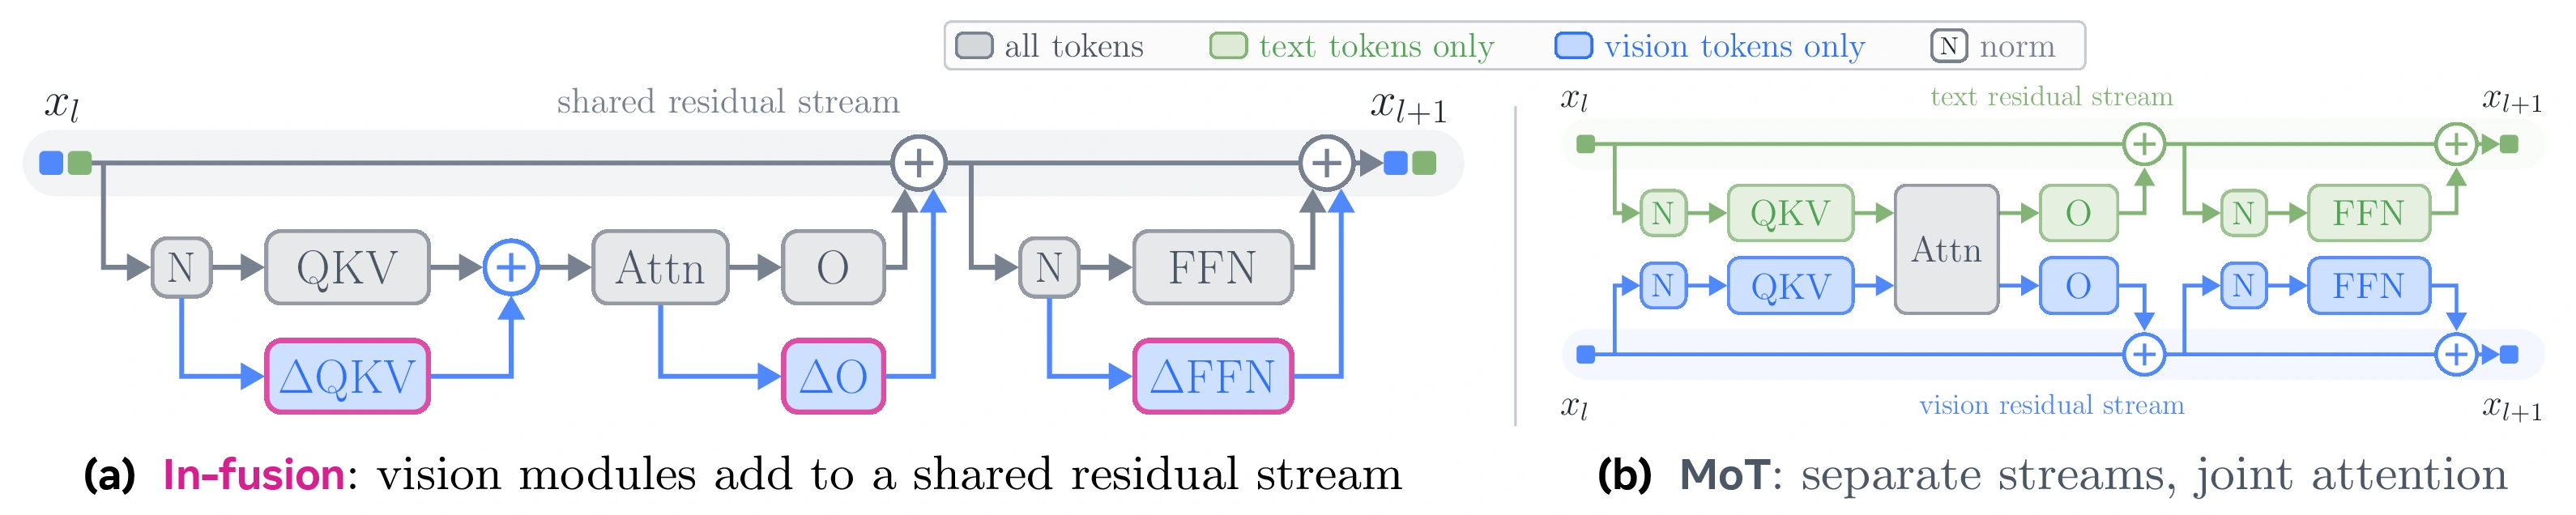
표 3은 FFN만 추가해 28층 중 어디에 4억 개를 쓸지 바꿨다.[2]
18층의 시각 전용 분기는 45.0, 2128층은 35.1, 전체 층에 좁게 분산하면 39.4였다.[2]
같은 초반 8층이라도 분기를 모든 토큰이 쓰게 하면 42.3이었다.[2]
실험에서 유리했던 것은 같은 수의 파라미터를 단순 추가하는 게 아니라, 앞쪽에 집중하고 시각 토큰에만 배정하는 조합이다.[2]
이 45.0은 FFN-only의 배치 실험 결과다.[2]
논문의 기본 in-fusion은 같은 전용 예산을 더 좁은 FFN과 전용 투영에 나눠 쓴다.[2]
가장 긴 주 실험에서 공동학습 인코더 / 인코더 제거 / FFN-only / 기본 in-fusion의 Avg.
VQA는 1.7B에서 48.9 / 44.8 / 48.6 / 49.2, 4B에서 54.5 / 51.7 / 53.4 / 54.3이었다(표 26).[2]
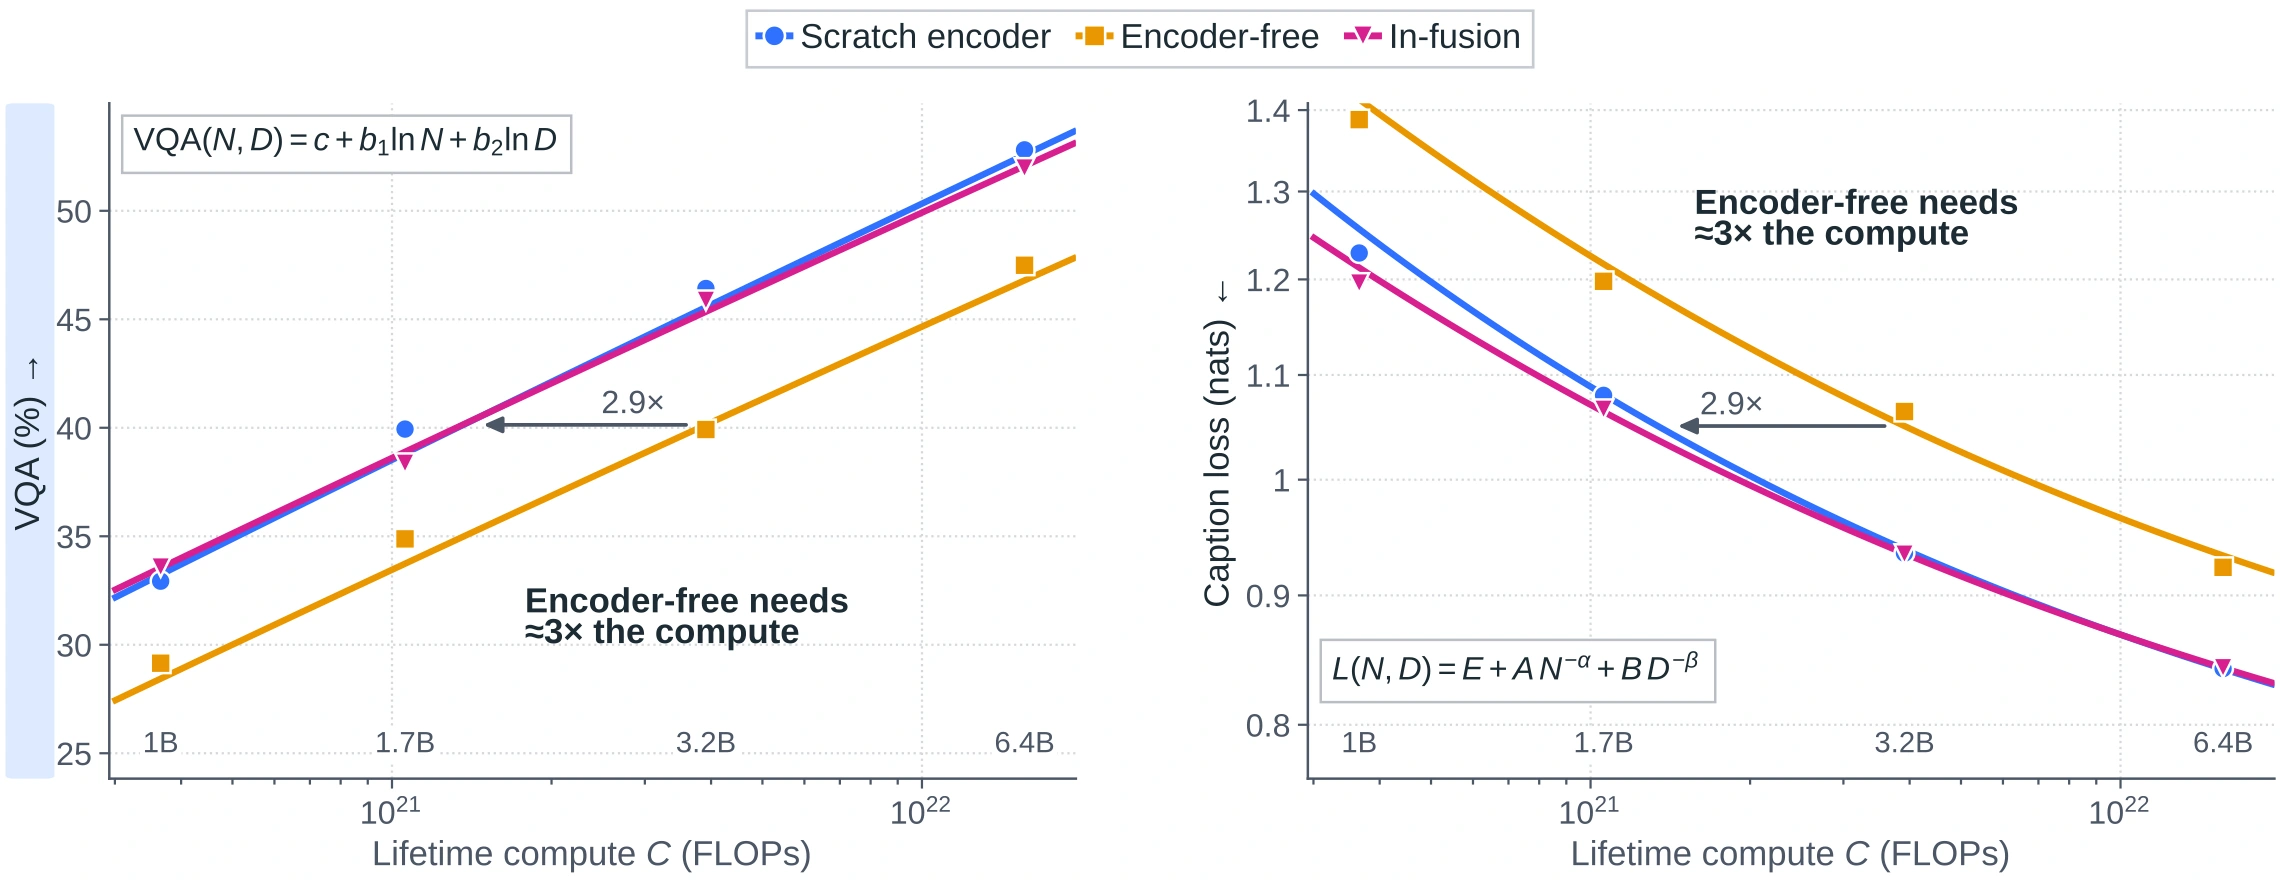
‘약 3배’는 벽시계 시간이 아니라 적합곡선의 연산비
스케일 실험은 0.6B~6.4B 다섯 백본을 사용하고, 전용 용량도 백본에 맞춰 늘렸다.[2]
이 실험에서는 앞 8층을 고정한 것이 아니라 깊이의 약 29%에 배치했다.[2]
64 TPP(비임베딩 백본 파라미터당 토큰 환산량)에서 6.4B의 실측 Avg.
VQA는 공동학습 인코더 52.8 / 인코더 제거 47.5 / in-fusion 52.0이다(표 29).[2]
저자들은 레시피별 17개 학습 종료점에 곡선을 적합하고, 1.7B~6.4B의 64 TPP 기준점에서 같은 VQA에 필요한 연산을 추정했다.[2]
인코더 제거는 2.6~3.1배, in-fusion은 1.0~1.1배였다(표 30).[2]
따라서 ‘약 3배’는 특정 조건에서의 FLOPs 추정치로, 학습 시간이나 추론 가속률이 아니다.[2]
이미 학습한 언어 모델에 붙이면, 그리고 서빙하면
자체 사전학습한 1.7B 텍스트 모델을 1T에서 1.33T 토큰 환산량까지 이어 학습해도, in-fusion 50.1, 새로 초기화한 독립 인코더 48.6, 초반 8층 MoT 48.5가 인코더 제거 39.8보다 높았다.[2]
전 층 MoT는 시각 전용 파라미터가 초반 8층 MoT의 약 3.5배인데도 43.3이었다.[2]
MetaCLIP의 선행 비용을 세지 않은 결과는 43.5였으며, 전용 경로의 학습률을 조정한 비교에서도 최고 46.1이었다(표 33~34).[2]
같은 전용 예산에서 첫 토큰 지연이 줄었다
표 36의 401M 전용 파라미터 조건을 보자.
H200 한 장에서 448px 이미지 1장과 텍스트 256토큰을 담은 요청 16개를 동시에 처리하고, 120토큰을 생성했다.[2]
아래는 저자들의 eager 구현에서 네 차례 실행한 첫 토큰 지연(TTFT) 중앙값이다.[2]
| 백본 | 독립 인코더 | FFN-only | In-fusion |
|---|---|---|---|
| 1.7B | 210 ms | 171 ms | 182 ms |
| 4B | 405 ms | 365 ms | 381 ms |
독립 인코더가 끝날 때까지 기다리는 단계가 사라진다.[2]
저자들은 이 구현에서 FFN-only가 전용 파라미터를 좁은 27층에서 넓은 8층으로 옮긴 점도 지연 감소의 이유로 든다.[2]
이 수치는 첫 토큰까지의 시간이지 120토큰 전체를 생성하는 시간은 아니다.[2]
혼합 요청을 연속 배치하는 운영 환경에서는 시각 분기가 텍스트 전용 요청과 같은 배치에서 돌아가므로, 이미지·텍스트 요청의 지연을 각각 재야 한다.[2]
학습 시간도 별개다.
4B H200 32장 실험에서 같은 FLOPs까지 걸리는 시간을 정상상태 스텝 실측으로 환산하면 독립 인코더가 기본 in-fusion보다 2.6% 길었다.[2]
다만 최적화하지 않은 인코더 기준이며, 별도의 작은 인코더를 컴파일한 비교에서는 FFN-only와 차이가 0.2% 이내였다(부록 H.2).[2]
실무에서 가져갈 설계 기준
이 연구가 지지하는 첫 실험은 전용 예산을 고정한 채 독립 인코더와 초반 분기를 바꿔 보는 것이다.
실무에서는 OCR·차트와 순수 언어 점수를 따로 보고, 목표 서버에서도 첫 토큰 지연을 다시 재는 편이 좋다.
반대로 이미 강한 외부 인코더가 있거나 원본 이미지 해상도가 높은 경우, 기본 선형 패치 입력만 대조군으로 삼으면 설계 공간을 과소평가할 수 있다.[2]
실험은 최대 6.4B의 밀집 백본과 주로 224×224 학습 이미지에 국한된다.[2]
희소 MoE, 여러 이미지가 끼어드는 문서, 동영상이나 이미지 생성까지 같은 결론이 성립하는지는 이 결과만으로 알 수 없다.[2]
공식 사이트와 저장소는 PDF·시각화 코드·차트 데이터를 제공한다.[1][4][5]
이 공개 경로에서는 훈련 코드나 모델 체크포인트는 확인되지 않았다.[4]
그림 4·7·8은 Brown 등, Unbundling Multimodal Vision Encoding (2026)의 논문 그림이다.
원문은 CC BY 4.0이며, 그림 추출·범례 합성·WebP 변환을 했다.[2][3]