KAIST AI 소속 Moonseok Choi·Giung Nam·Juho Lee와 독립 연구자 Taehong Moon이 제안한 HAD 논문은 2026년 10월 2일 arXiv v1로 공개됐다.[2][3]
작은 언어모델 에이전트를 큰 교사로부터 증류할 때, 배포 환경에 이미 하네스가 남아 있다면 학생이 배워야 하는 것은 무엇일까.[1]
하네스는 관측을 보강하고, 상태를 추적하며, 실패나 반복 행동에 대한 피드백을 제공한다.[1]
그런데 일반적인 증류는 교사의 전체 응답을 모방하므로, 그중 어떤 행동이 하네스 때문에 달라졌는지는 명시적으로 가르치지 않는다.[1]
Harness-Aware Distillation (HAD)는 이 간극을 “교사가 하네스에 더해 보태는 능력”의 문제로 다룬다.[1]
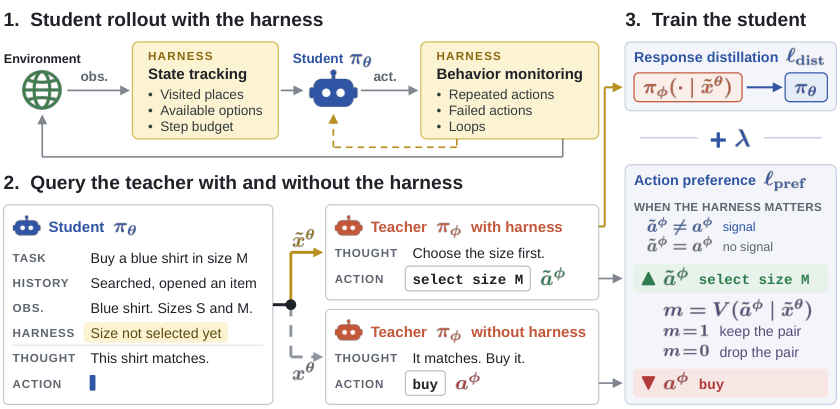
학생이 실제 하네스와 함께 방문한 상태에서 같은 교사에게 하네스가 붙은 기록과 제거된 기록을 각각 보여주고, 두 응답의 행동(action) 차이를 선호 신호로 만든다.[1]
여기에 하네스 기록과 명백히 충돌하는 긍정 행동을 걸러내는 검사를 더한다.[1]
무엇을 해결하려는가
하네스가 현재 가진 물건, 가능한 행동, 방문한 위치, 실패한 행동, 반복 상태를 알려주더라도, 실제로 그 단서를 읽고 다음 행동에 반영하는 일은 모델 몫이다.[1]
응답 전체를 따라 하는 on-policy distillation은 학생이 방문한 상태에서 교사를 조회한다는 장점은 있지만, 하네스 정보가 결정을 바꾼 지점과 그렇지 않은 지점을 구별하지 못한다.[1]
교사가 하네스 기록과 모순되는 행동을 내놓아도 이를 그대로 모방할 수 있다.[1]
저자들이 실험에 사용한 하네스는 ALFWorld·WebShop·ScienceWorld에 공통으로 적용되는 작업 비종속 텍스트 보강 계층이다.[1]
상태 추적은 위치·인벤토리·방문 기록·스텝 예산·가능 행동을 보여주고, 행동 모니터링은 실패 행동과 정체(stall)를 알린다.[1]
이 하네스는 행동을 대신 선택하거나 차단하지 않고 관측에 텍스트만 더한다.[1]
핵심 아이디어와 학습 절차
먼저 학생이 하네스와 상호작용하며 만든 궤적의 각 상태에서 교사에게 하네스를 포함한 전체 응답을 요청한다.[1]
이 응답은 기존 방식처럼 학생의 reasoning과 action을 함께 증류하는 기본 손실이 된다.[1]
이어 같은 상태에서 하네스 정보만 걷어낸 이력으로 교사를 한 번 더 질의한다.[1]
두 교사 응답의 reasoning이 아니라 행동 부분만 비교하고, 두 행동 모두 학생 자신의 reasoning 뒤에서 점수화한다.[1]
하네스가 있을 때의 교사 행동은 선호, 하네스가 없을 때의 행동은 비교 대상으로 삼는다.[1]
따라서 두 행동이 달라지는 상태에서만 선호 신호가 의미를 갖고, 학생의 추론 문맥과 배포 시점의 행동 선택도 맞출 수 있다.[1]
하지만 하네스가 있다는 이유만으로 교사의 선택이 항상 옳은 것은 아니다.[1]
HAD는 선호되는 행동이 하네스가 제공한 환경 기록과 모순되면 그 쌍의 선호 손실만 제외한다.[1]
반면 기본 응답 증류는 유지한다.[1]
이는 잘못된 정답을 모두 찾아내는 검증기가 아니라, 관측 사실과 명백히 충돌하는 교사 행동을 학습 신호에서 제거하는 제한적 필터다.[1]
공개된 실험 결과
논문은 ALFWorld, WebShop, ScienceWorld에서 Qwen3 학생을 평가했다.[1]
ALFWorld에서는 1.7B 학생과 8B 교사를, 나머지 두 환경에서는 0.6B 학생과 30B-A3B 교사를 사용했다.[1]
별도로 Gemma-4-E2B 학생과 Gemma-4-12B 교사를 ALFWorld에서 평가해 모델 계열 간 결과도 확인했다.[1]
모든 증류 방식은 동일한 하네스·학습 루프·task pool·업데이트 수를 공유하며, 교사와 초기 학생은 zero-shot으로 평가했다.[1]
아래는 하네스를 켠 평가 결과다.[1]
ALFWorld는 성공률, WebShop은 성공률과 100점 환산 보상 점수, ScienceWorld는 성공률과 평균 최종 과제 점수를 보고한다.[1]
비교 기준은 해당 지표에서 가장 높은 다른 증류 학생이며, 교사 수치는 별도 참고값이다.[1]
- ALFWorld — 미관측/관측 성공률은 HAD 63.43% / 51.43%, 가장 강한 다른 증류 학생 47.01% (OPD) / 41.43% (SAGE-OPD·SOPD), zero-shot 교사 51.49% / 50.00%다.[1]
- WebShop — 보상 점수는 HAD 47.19, SAGE-OPD 42.21, 교사 49.96이며, 성공률은 19.60%, OPD 19.00%, 교사 18.80%다.[1]
- ScienceWorld — 성공률은 HAD 9.40%, OPD 8.05%, 교사 20.13%다. 평균 최종 과제 점수는 HAD -4.17, SAGE-OPD -0.77, 교사 -20.26이다.[1]
이 결과를 “모든 지표에서 HAD가 이긴다”고 뭉뚱그리면 안 된다.[1]
ALFWorld의 두 성공률과 WebShop 지표, ScienceWorld 성공률에서는 HAD가 다른 증류 학생을 앞섰지만, ScienceWorld 평균 최종 과제 점수에서는 SAGE-OPD의 -0.77보다 낮은 -4.17을 기록했다.[1]
반대로 ALFWorld 미관측 성공률 63.43%는 8B 교사의 51.49%도 웃돈다.[1]
ALFWorld의 실패 회피·회복 분석은 이 방법의 의도를 더 직접적으로 보여준다.[1]
정체가 없었던 에피소드 비율은 HAD 75.9%로 다른 모델 중 최고였던 교사 64.6%보다 높았고, 정체 이후 새로운 상태로 빠져나온 비율도 59.7%로 다음으로 높은 SOPD의 50.0%를 웃돌았다.[1]
저자들은 이를 하네스의 반복·실패 피드백을 학생이 활용하는 결과로 해석한다.[1]
구성요소 제거 실험에서도 각 부분의 역할이 나뉜다.[1]
별도 ALFWorld ablation 표에서 HAD의 성공률 57.4%는 validity 검사를 빼면 50.8%, 하네스가 없는 교사 행동과의 대조를 빼면 52.4%, 선호 손실 전체를 빼면 43.5%로 낮아졌다.[1]
저자들은 행동 대조가 하네스 활용도를 높이고 validity 검사가 성능을 보호한다고 해석한다.[1]
실무 관점과 한계
이 연구의 실용적인 통찰은 공유되는 외부 구성요소가 있는 시스템을 증류할 때, 그 구성요소가 이미 제공하는 정보를 학생의 가중치에 중복해서 넣는 대신 그 정보가 행동을 어떻게 바꾸는지를 교사 비교로 드러내는 데 있다.[1]
보상이나 성공 라벨, 미래 상태 없이 같은 교사의 조건부 응답 차이를 신호로 쓰므로, 테스트 보상 설계가 어려운 에이전트 환경에서 유용할 수 있다.[1]
다만 하네스 조건은 공짜가 아니다.[1]
HAD는 각 학생 방문 상태에서 교사를 하네스 포함·제거 조건으로 두 번 질의한다.[1]
저자들은 추가 질의량을 통제하기 위해 OPD와 SOPD의 교사 질의 예산을 두 배로 늘린 비교도 했고, 그 설정에서 각각 평균 성공률 46.7%, 46.8%를 보고해 HAD의 57.4%보다 낮았다고 설명한다.[1]
하지만 실제 운영에서는 이 두 번째 교사 질의가 학습 비용을 늘리는 요소이며, 추론 단계의 비용 절감이나 총 학습 비용 우위를 입증한 결과로 읽어서는 안 된다.[1]
또 validity check는 하네스 기록과 명백히 충돌하는 선호 행동만 제거한다.[1]
기록과 양립하지만 틀린 행동은 여전히 남을 수 있고, 검증 기준 자체도 환경 관측에 의존한다.[1]
더 넓게는 실험이 텍스트 기반 장기 과제, 사람이 설계한 고정 하네스, 최대 2B 학생·30B 교사 규모에 한정돼 있다.[1]
실제 웹·소프트웨어 에이전트나 자동으로 학습·최적화되는 하네스에서 같은 이득이 나타나는지는 후속 검증이 필요하다고 논문도 한계로 밝힌다.[1]
공개 구현도 아직 재현성의 빈칸이다.[4]
2026년 10월 7일 확인한 저자 프로젝트 페이지는 코드·하네스·학습 스크립트를 “coming soon”으로 안내하고 있어, 현재 공개된 근거는 논문과 프로젝트 설명에 한정된다.[4]
따라서 지금 단계에서는 바로 설치해 검증할 수 있는 프레임워크라기보다, 하네스가 고정된 에이전트 증류에서 무엇을 학습 신호로 삼을지 제안하는 연구로 평가하는 편이 타당하다.[4]