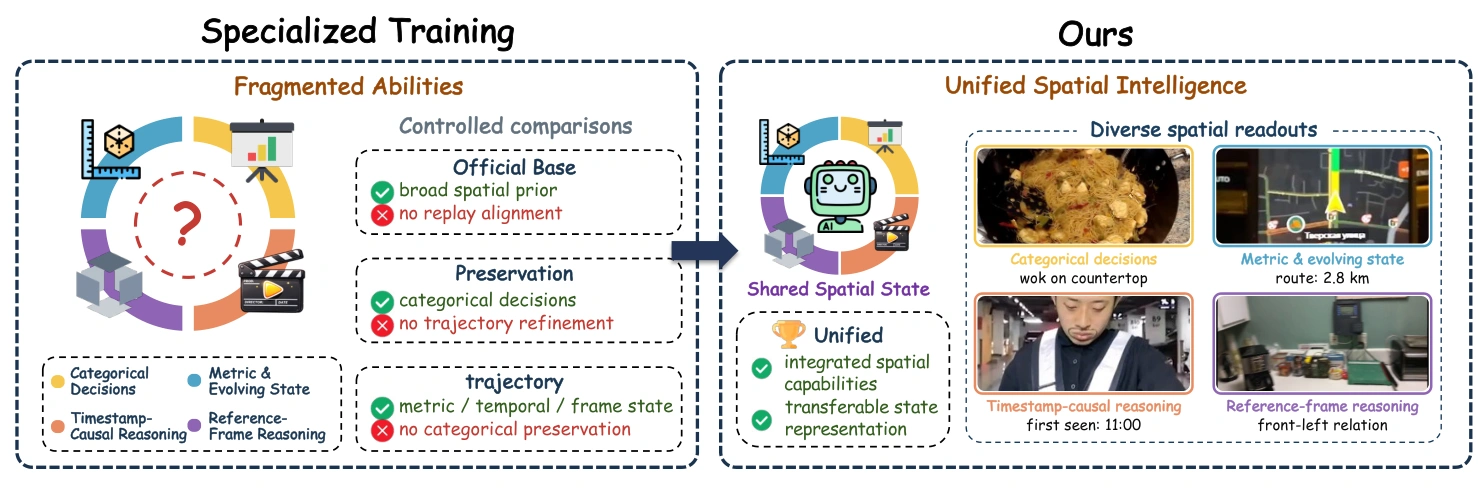
물체의 좌우를 분류하는 데 필요한 정보와 거리·최초 등장 시점을 추정하는 데 필요한 정보는 같지 않다.
ChronoReplay는 이 차이를 공간 VLM의 후학습 문제로 다룬다.
하나의 답 형식에 집중하면 그 형식의 점수는 오르지만 다른 형식으로의 전이는 약해지거나 퇴보할 수 있다는 것이다.[1][2]
해법은 새로운 지도나 메모리 모듈이 아니다.[2]
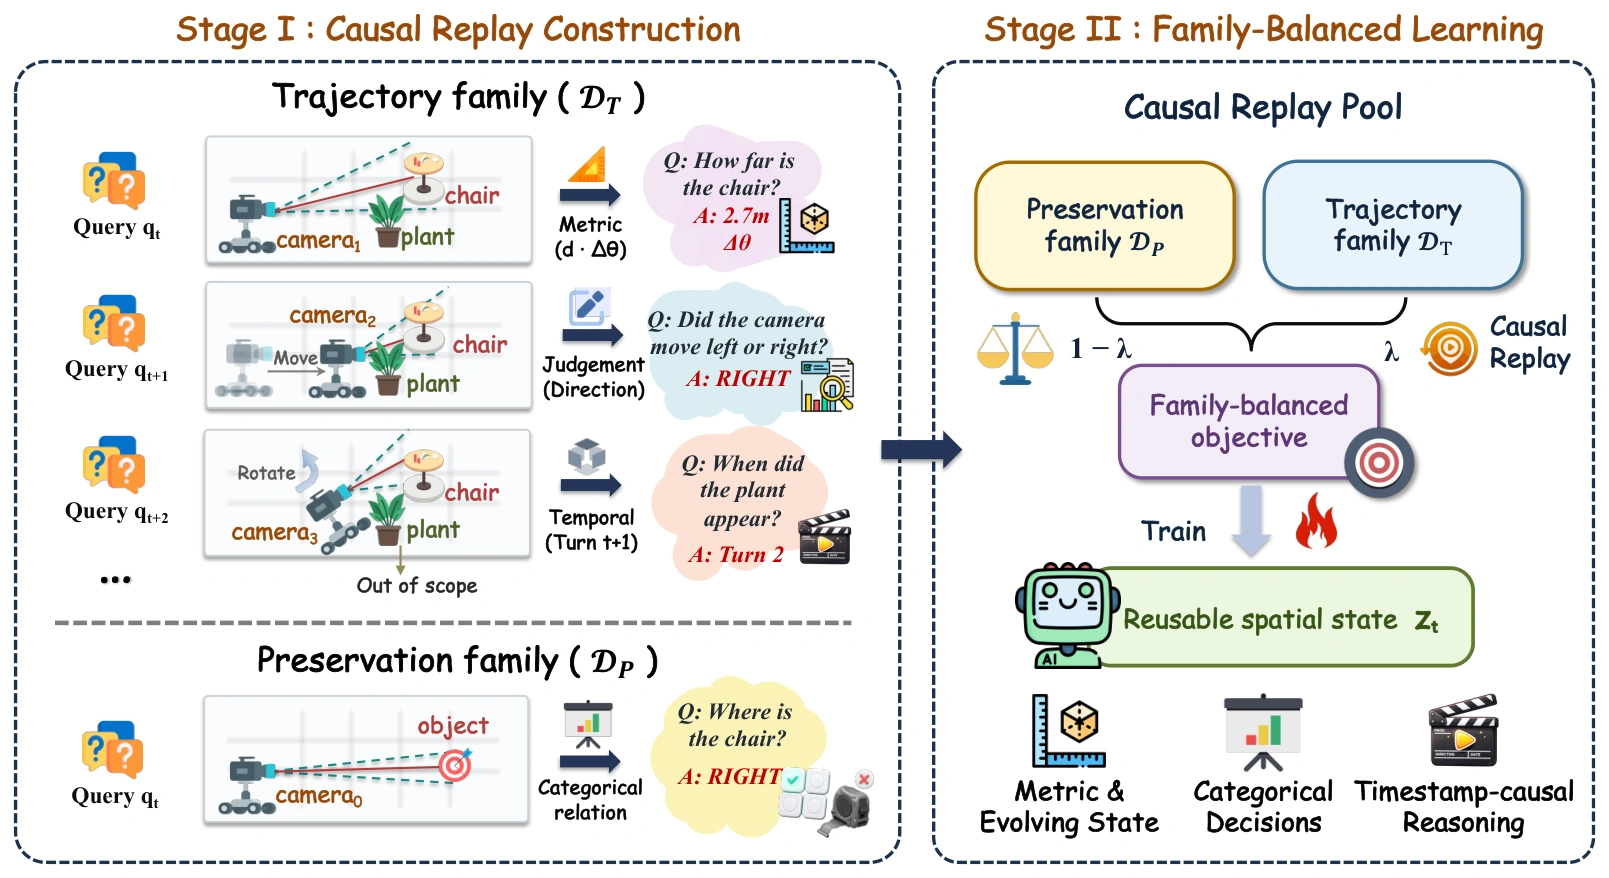
원래 정답의 의미를 유지하고, 그 답이 유효한 시간순 관찰 이력과 함께 학습하며, 서로 다른 데이터군의 손실 비중을 조절한다.[2]
Qwen3-VL-8B-Instruct를 출발점으로 한 단일 체크포인트가 같은 관찰 조건에서 세 공간 벤치마크를 함께 개선했다는 것이 핵심 결과다.[2][5]
한 종류의 질문을 잘하면 공간 지능도 좋아질까
논문은 단일 데이터군 후학습의 불균형을 interface lock-in이라고 부른다.[2]
범주형 감독만 학습한 변형은 OVO-S에서 58.03으로 기본 모델의 48.98보다 높지만, OST는 50.52에서 47.48로 하락한다.[2]
궤적 감독만 학습한 변형의 OST도 51.03으로 개선이 작다.[2]
이는 출력 형식 하나가 모델 내부를 영구적으로 ‘잠갔다’는 증명이 아니다.
비교 데이터군은 출처와 과제 범위도 다르므로, 관찰된 결과는 형식 간 전이가 고르지 않다는 실험적 패턴으로 해석해야 한다.[2][3]
특히 본 학습의 preservation 데이터군은 범주형만이 아니라 수치형 정답도 포함한다.[2]
같은 최근 장면을 봐도 출발할 때 어느 방향을 향했는지에 따라 누적 변위와 과거 물체의 상대 위치는 달라진다.[2]
따라서 질문·정답 쌍을 독립적으로 섞는 것만으로는 부족하다.
정답을 정의하는 과거 맥락까지 학습 단위에 남겨야 한다는 것이 ChronoReplay의 관점이다.[2]
원래 정답, 시간순 이력, 손실 비중
원래 답의 의미를 유지한다
범주형 정답은 선택지의 의미를, 거리·회전 같은 정답은 부호·단위·정밀도를, 시간형 정답은 타임스탬프나 사건 순서를 유지한다.[2]
모든 정답은 기존 VLM의 자기회귀 디코더로 생성한다.[2]
별도 거리 예측 헤드나 명시적 3D 상태 저장소를 추가하는 방식은 아니다.[2]
각 정답을 유효한 과거에 붙인다
궤적 에피소드는 원래 시간순으로 재생한다.[2]
각 턴의 정답은 그 시점까지 볼 수 있는 관찰과 앞선 상호작용에만 연결하며, 뒤의 관찰은 제외한다.[2]
여기서 causal replay는 과거 경험을 다시 학습한다는 뜻이지, 테스트 중 모델을 온라인으로 갱신한다는 뜻이 아니다.
공간 상태는 VLM 내부에 암묵적으로 남는다.[2]
데이터 수가 손실 비중을 정하지 않게 한다
학습 풀은 단일 턴 preservation 33,180개와 궤적 에피소드 6,381개로 구성되며, 후자에는 45,006개의 감독 턴이 있다.[2][8]
답 길이로 손실을 정규화하고, 궤적 안에서는 감독 턴을 기준으로 기여도를 계산한 뒤 데이터군 사이의 총 비중을 명시한다.[2]
기본 설정 alpha=0.5는 궤적이 전체 손실의 절반이라는 뜻이 아니다.[2]
궤적 대 preservation의 상대 비중이므로, 전체에서는 범주형 preservation·수치형 preservation·궤적이 각각 1/3을 받는다.[2][9]
이것은 손실 계수의 균형이지 실제 그래디언트 크기가 동일하다는 보장은 아니다.[2]
같은 관찰 조건에서 세 벤치마크가 함께 좋아진다
핵심 비교는 같은 Qwen3-VL-8B 초기화에서 출발해 관찰 접근과 채점 규칙을 고정한다.[2]
OVO-S는 128프레임 균일 선택, OST는 학습·평가 장면이 겹치지 않는 고정 프로토콜, UCS는 8,114개 질문 전체를 사용한다.[2][3]
| 평가 | 기본 모델 → ChronoReplay |
|---|---|
| OVO-S-Bench | 48.98 → 53.89, +4.91점이다.[2] |
| OST-Bench | 50.52 → 63.93, +13.41점이다.[2] |
| UCS-Bench | 45.33 → 52.77, +7.44점이다.[2] |
OVO-S의 Overall은 전체 문항을 합친 정확도가 아니라 12개 과제군 정확도의 비가중 평균이다.[2]
OST는 총 8,351턴 중 공식 평가기가 지정한 7,814턴을 채점한다.[2][3]
원 논문에서 인용한 외부 모델 점수는 각자의 평가 조건을 따르므로, 다른 크기의 모델보다 보편적으로 우수하다는 인과적 비교로 확대할 수는 없다.[2]
학습은 시각 인코더를 고정하고 언어 모델과 visual merger를 갱신하는 SFT다.[2][7]
주요 설정은 1 epoch, 전역 배치 32, 학습률 2e-6, BF16, 최대 길이 32,768토큰이며, 대표 체크포인트는 GPU 8개로 학습했다.[3][7]
새로운 아키텍처의 성과라기보다 데이터 구성과 학습 목적의 성과로 읽는 편이 맞다.
13.41점 전체 향상과 시간순서만의 효과는 다르다
단순히 여러 데이터를 섞어서 얻는 효과도 있다.
같은 결합 데이터에서 일반 token SFT의 OVO-S/OST/UCS는 51.8 / 60.7 / 49.8, 답 길이와 턴 가중치를 반영한 natural turn weighting은 52.9 / 62.3 / 51.5다.[2]
전체 ChronoReplay는 이들보다 세 지표가 모두 높다. natural turn weighting 대비 이득은 세 쌍의 학습 seed에서 반복됐고, 평균 차이는 각각 +0.92 / +1.43 / +1.17점이었다.[2][3]
시간순서 대조군은 턴의 관찰·질문·정답·가중치는 유지하고 에피소드의 턴 블록을 순환 이동한다.[2]
시간순 재생은 두 seed 쌍에서 OST가 2.42점과 2.41점 높았다.[2][3]
따라서 13.41점은 전체 레시피의 개선, 약 2.41점은 순서 대조 실험의 평균 차이다.
후자를 ‘모델 내부의 출발점 표현만 분리해 검증했다’고 해석하면 안 된다.
순환 이동은 출발점뿐 아니라 각 정답 앞의 맥락도 바꾼다.[2]
원래 답 형식도 항상 이기지는 않는다.
원래 답 전체를 JSON의 value 문자열에 넣는 정보 손실 없는 직렬화 변경과 비교하면, native는 UCS가 2.92점 높지만 OST는 1.48점 낮다.[2][3]
이는 정답의 의미를 버렸기 때문이 아니라, 유한한 모델에서 직렬화와 학습이 전이를 배분하는 방식도 달라질 수 있음을 보여 준다.[2]
‘JSON보다 자연어가 언제나 낫다’는 결론은 아니다.
프레임 선택의 이득은 추론 단계로 분리한다
추가적인 adaptive access는 모델을 다시 학습하지 않는다.[2]
질문의 시간 범위에 맞춰 현재 상태는 최근 관찰, 움직임·순서는 다중 시간 해상도, 과거 기준점·배치는 전체 이력을 선택하는 고정 정책이다.[2]
논문 설정은 현재 상태에 최대 8프레임, 나머지 두 경로에 최대 128프레임을 사용한다.[2]
선택에는 질문 텍스트만 쓰며 정답·선택지·벤치마크 분류·모델 점수는 쓰지 않는다고 명시한다.[2][3]
같은 ChronoReplay 체크포인트의 OVO-S는 53.89에서 57.98로 올라가고, 평균 프레임 수는 128에서 80.50으로 줄어든다.[2]
즉 학습 효과 +4.91점과 관찰 선택 효과 +4.09점을 분리해야 한다.[2]
비슷한 프레임 예산의 Uniform-81은 52.40이므로, 이 실험에서는 단순히 프레임을 줄이는 것보다 어느 시점의 증거를 남기는가가 중요했다.[2][3]
프레임 수 감소가 곧 같은 비율의 전체 지연·메모리·비용 감소를 뜻하는 것은 아니다.
논문이 여기서 측정한 것은 관찰 프레임과 평가 점수의 관계다.[2]
공개 자료로 어디까지 재현할 수 있나
논문이 연결한 HF 컬렉션에는 ChronoReplay-8B와 ChronoReplay-Train이 있다.[6]
모델 카드와 파일 목록에는 대표 seed-42 체크포인트의 전체 safetensors 가중치 4개 shard, 토크나이저·프로세서가 확인된다.[7]
데이터 카드에는 39,561개 학습 레코드와 원래 질문·정답·순서·손실 가중치·감독 마스크가 포함된다고 명시한다.[8]
하지만 이미지·영상 원본은 포함되지 않는다.[8]
상대 미디어 경로를 실제 원본과 연결하고 검증해야 하며, 변환 시 현재 미디어의 픽셀 동일성을 다시 확인한 것은 아니라고 카드가 밝힌다.[8]
최적화 상태·학습 로그·저장된 평가 예측도 모델 패키지에 포함되지 않는다.[7]
가중치를 로드하는 것만으로 논문의 관찰 선택과 채점 프로토콜이 자동으로 적용되지는 않는다.[7]
더구나 공식 평가 문서는 논문용 OVO-S 1,695문항 주석 스냅숏과 정확한 OST 장면 manifest가 코드 묶음에 없다고 명시한다.[11]
현재 upstream 데이터나 새로 구성한 장면 목록으로 바꾸면 같은 평가집합을 재현한 것이 아니다.[11]
공개 실행 설정에도 차이가 있다.
평가 wrapper는 adaptive 경로에 --semantic-recent-nframes 16을 넘기지만, 논문의 지역 관찰 예산은 8프레임이다.[2][10]
따라서 공개 기본 명령을 57.98점·평균 80.50프레임을 낸 조건과 동일하다고 단정할 수 없다.[2][10]
이 차이가 점수에 미치는 영향은 재평가하지 않았으며, 차이 자체가 논문 결과의 오류를 입증하는 것은 아니다.
문서 사이의 시차도 주의할 부분이다.
GitHub README와 프로젝트 페이지에는 미세조정 가중치가 배포물에 없다는 설명이 남아 있지만, 논문과 HF 컬렉션은 별도 모델·변환 주석 배포를 안내한다.[2][4][5]
따라서 코드 저장소의 구성과 현재 HF 배포를 따로 확인하는 편이 정확하다.[6][7][8]
라이선스도 하나로 단순화할 수 없다.
GitHub는 아직 프로젝트 전체 오픈소스 라이선스를 부여하지 않았다고 명시한다.[4]
데이터는 원천별 조건을 유지하며, OST 구성요소의 CC-BY-NC-4.0 표기를 전체 혼합 데이터의 통일 라이선스로 확대하면 안 된다.[8]
공개 열람·다운로드와 제품 재배포 권한은 별도 확인 사항이다.
공간 상태를 무엇으로 검증할 것인가
ChronoReplay의 강점은 큰 점수 하나보다 학습 데이터, 시간순서, 답 직렬화, 추론 관찰을 나눠 비교한 설계에 있다.
그러나 대표 점수는 단일 seed이고, 순서와 목적함수 실험만 각각 추가 seed로 검토했다.[3]
평가는 실내 장면 중심이며, 전역 배치 추론인 OVO-S L4는 여전히 가장 어려운 수준이다.[2]
부록에는 같은 관찰을 받은 기본 모델은 맞히고 ChronoReplay는 틀린 배치 문항도 제시한다.[3]
이 결과가 실제 로봇의 안전한 이동이나 조작 성공을 보장하지는 않는다.
저자도 자율 주행·감시·안전 필수 배포의 적합성을 주장하지 않는다.[3]
실무적으로 남는 원칙은 간단하다.
공간 VLM을 평가할 때는 좌우 선택지만 보지 말고, 거리·시간·과거 기준 좌표계를 함께 검증해야 한다.
이 글의 수치는 논문 보고값이며, 모델 학습과 벤치마크를 별도로 재실행한 결과는 아니다.