작은 모델의 경쟁력은 범용 모델의 점수를 얼마나 따라잡느냐만으로 결정되지 않는다.
업무에 필요한 입력을 받고, 정해진 형식으로 답하며, 실제 기기의 메모리와 지연시간 안에 들어오는지도 중요하다.
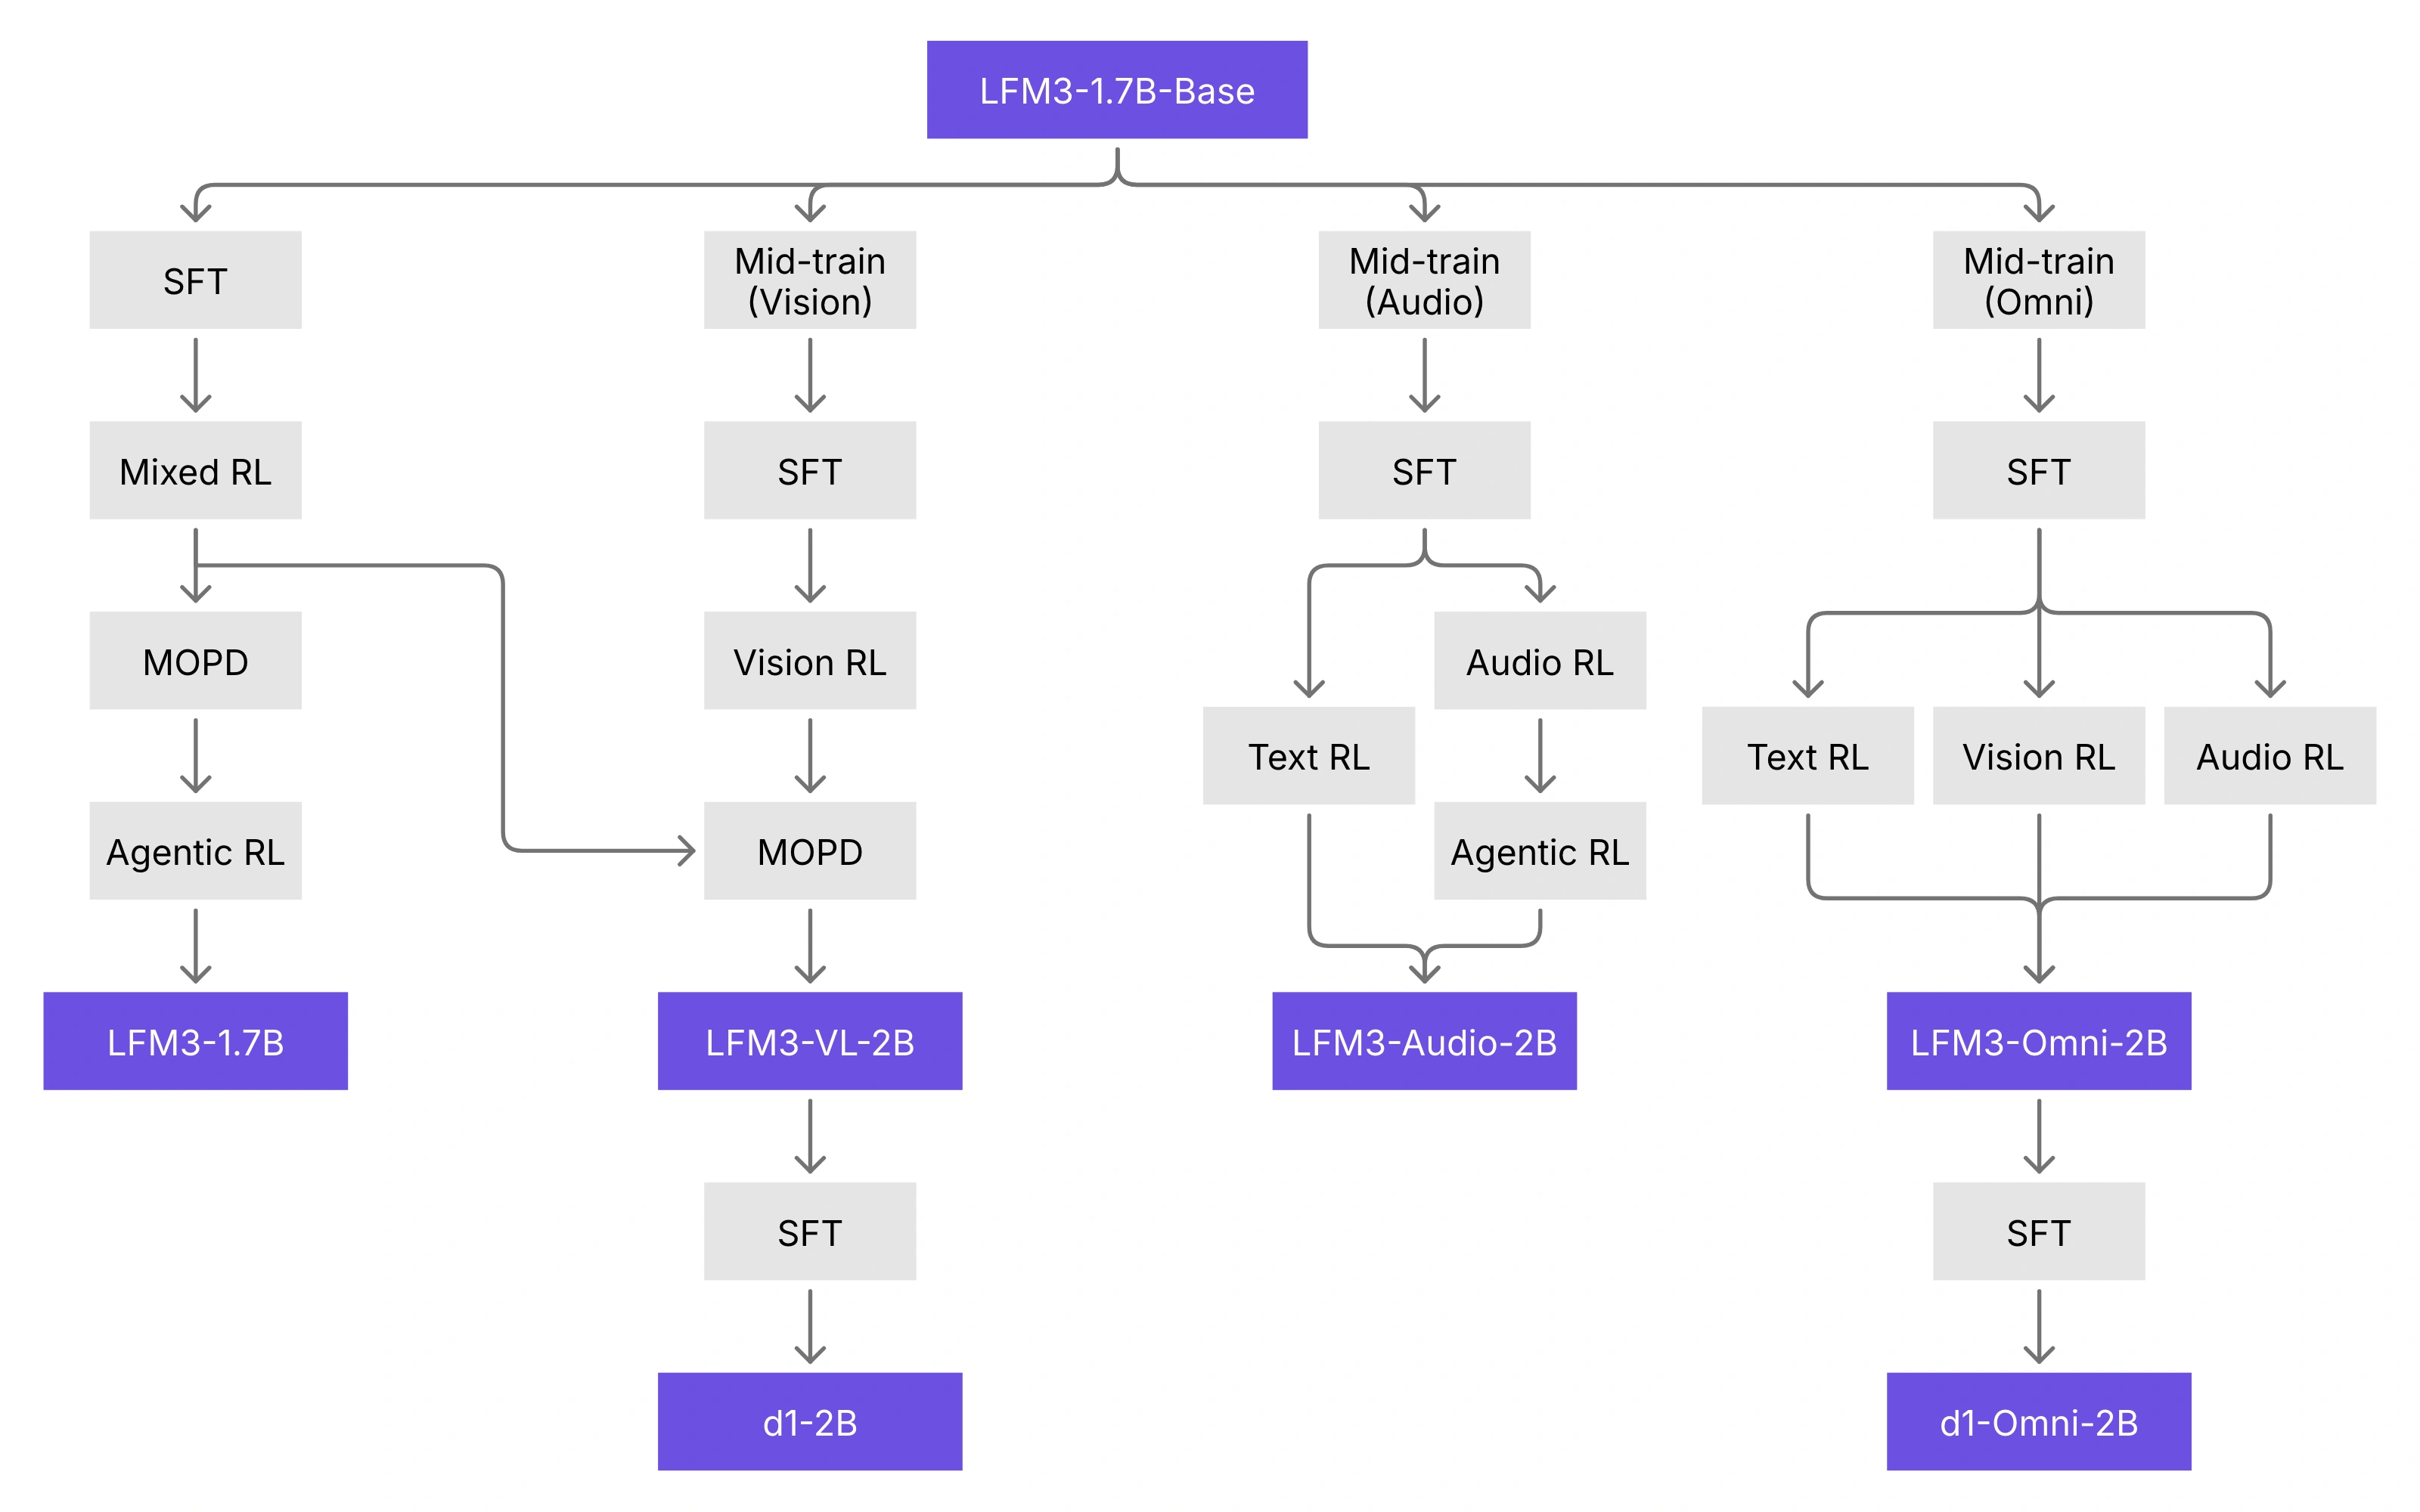
Liquid AI가 공개한 LFM3는 공통 백본에서 모달리티와 출력 방식이 다른 모델을 파생하고, 이를 업무별로 미세조정하는 방향을 택했다.[1][2]
출발점은 LFM3-1.7B-Base, 그 위에는 텍스트·시각·음성·Omni 모델과 두 종류의 d1 결정 모델이 있다.[1]
‘하나의 2B 모델이 모든 기능을 같은 조건으로 제공한다’기보다, 공통 기반을 공유하되 배포할 모델은 목적에 맞게 고르는 제품군이다.
컨텍스트 길이, 추론 모드, 음성 지원 범위도 모델마다 다르다.[3][4][5]
공통 백본은 세 가지 연산을 섞는다
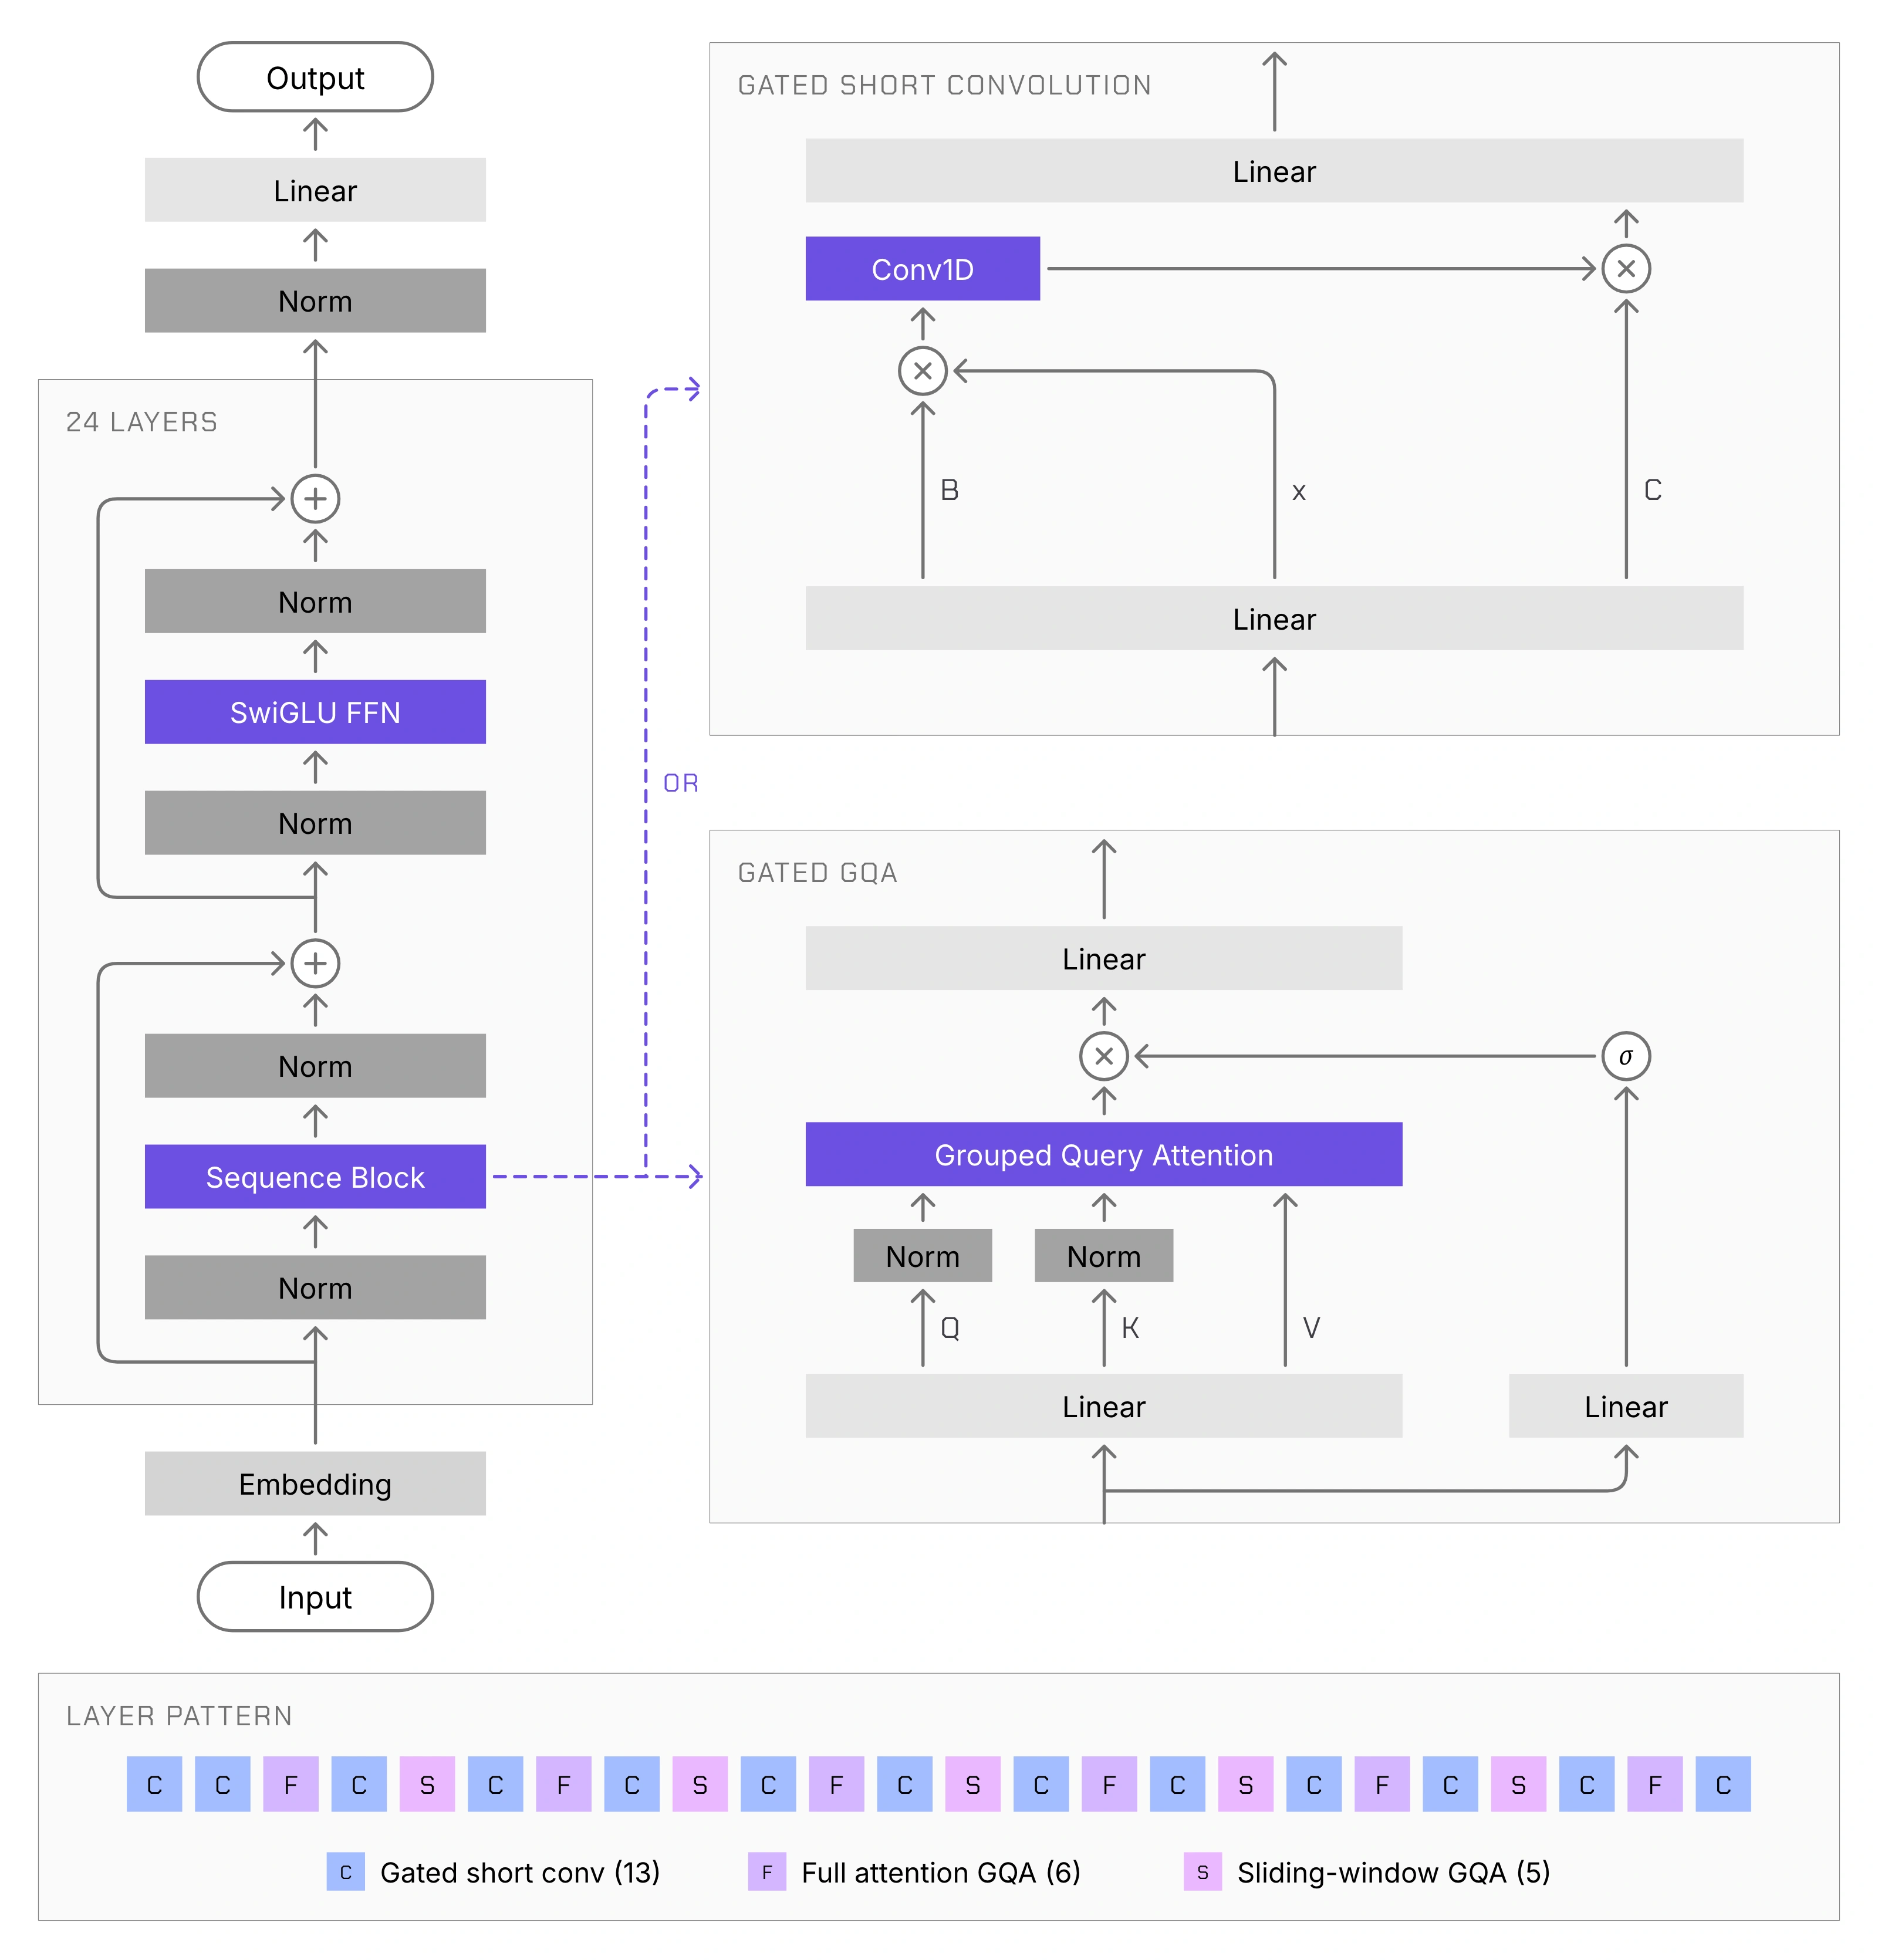
LFM3의 tri-hybrid는 모달리티 세 개를 뜻하는 말이 아니라, 시퀀스를 처리하는 연산 세 가지를 섞었다는 뜻이다.[1][2]
총 24개 층 중 13개는 게이트가 있는 짧은 합성곱, 5개는 슬라이딩 윈도 어텐션, 6개는 전역 어텐션이다.[1][2]
슬라이딩 윈도는 256토큰, 합성곱 커널은 7이며, 긴 문맥 비용과 표현력의 균형을 위해 하드웨어를 포함한 아키텍처 탐색으로 이 조합을 골랐다고 설명한다.[2]
어텐션에는 헤드별 sigmoid 출력 게이트를 두고, 전역 어텐션에는 일부 차원만 회전시키는 Partial RoPE를 쓴다.[1][2]
슬라이딩 윈도 어텐션은 전체 RoPE를 유지하며, 블록의 입력과 출력에는 정규화를 적용한다.[1][2]
모두를 전역 어텐션으로 채우지 않으면서 필요한 정보 혼합을 확보하려는 구조다.
Base는 22T 토큰으로 학습했으며, 마지막 3.5T 토큰은 에이전트 실행 기록과 도구 호출 비중을 높인 중간 학습에 사용됐다.[2]
텍스트 모델의 후학습은 SFT, 혼합 RL, 여러 전문 RL 교사의 지식을 학생 모델에 모으는 MOPD, 실제 에이전트 하네스 안의 RL로 이어진다.[3]
작은 파라미터 수만큼이나 어떤 업무 행동을 학습했는가가 이번 릴리스의 핵심이다.
여섯 파생 모델의 입출력은 같지 않다
텍스트 모델은 약 1.73B, VL은 시각 인코더와 프로젝터를 포함해 약 1.92B, Omni는 전체 약 2.17B다.[3][4][6]
‘2B급’이라는 묶음과 각 모델의 정확한 전체 크기를 구분해야 한다.
| 모델 | 입출력과 컨텍스트 |
|---|---|
| LFM3-1.7B | 텍스트 입력·출력. 256K다.[3] |
| LFM3-VL-2B | 텍스트·이미지·영상 입력, 텍스트 출력. 128K다.[4] |
| LFM3-Audio-2B | 텍스트·음성 입력, 텍스트·음성 출력. 32K다.[5] |
| LFM3-Omni-2B | 텍스트·이미지·영상·음성 입력, 텍스트·음성 출력. 32K다.[6] |
| d1-2B | 텍스트·이미지·영상에서 구조화된 판단을 읽는다. 128K다.[7] |
| d1-Omni-2B | 음성까지 포함해 구조화된 판단을 읽는다. 128K다.[8] |
공유 백본이 256K를 지원한다고 모든 파생 모델도 같은 길이를 지원하는 것은 아니다.[3][4][5]
Omni는 non-reasoning 모델로 enable_thinking=True를 지원하지 않는다.[6]
반면 VL은 답변 전 추론을 사용하는 모델이다.[4]
모달리티 통합과 추론 기능의 통합도 같은 말이 아니다.
시각 인코더는 합성곱과 어텐션을 결합한 164M 규모다.[1][2]
Qwen3.5-2B의 시각 인코더와 비교한 효율 실험은 동일한 LFM2.5-230M 언어 백본을 사용해, 비슷한 정확도를 더 적은 FLOPs로 얻었다는 결과다.[1][2]
이를 LFM3 전체 시스템이 모든 작업에서 2.2배 빠르다는 주장으로 바꾸면 안 된다.
강점은 도구와 웹 작업, 약점은 여전히 별도로 본다
텍스트 모델의 대표적인 개선은 WebArena-Verified의 38.42다.[3]
전작 LFM2.5-2.6B의 3.02보다 높고, 같은 공식 표의 Qwen3.5-9B 28.94도 넘는다.[3]
다만 이것이 더 큰 모델의 모든 능력을 대체한다는 뜻은 아니다.
공개 표에서 일부 코딩·지식·장문 이해 지표는 Qwen3.5-9B가 높다.[3]
| 공식 평가 | LFM3-1.7B / Qwen3.5-9B |
|---|---|
| WebArena-Verified | 38.42 / 28.94[3] |
| BFCL V4 | 71.39 / 62.83[3] |
| SWE-bench Verified | 43.40 / 51.20. OpenCode 하네스다.[3] |
| GPQA Diamond | 63.37 / 80.40[3] |
| RULER 128K | 65.56 / 87.11[3] |
모델 카드는 BF16의 vLLM 서빙, 모델별 전체 컨텍스트, 작업별 출력·단계 제한을 명시한다.[3]
예를 들어 WebArena는 최대 40단계, SWE-bench는 OpenCode에서 최대 250턴이다.[3]
이 수치는 저자 측 평가이며, 양자화한 로컬 모델을 다른 하네스에 연결했을 때의 성공률과 동일하지 않다.
공식 카드도 텍스트 모델을 복잡한 다단계 추론이나 에이전트 코딩에 권장하지 않는다.[3]
좋아진 벤치마크 점수와 적합한 업무 범위에 대한 제한을 함께 읽는 편이 맞다.
VL은 전작 대비 62개 시각 평가의 평균이 57.6에서 71.4로 상승했다고 보고한다.[1]
이 평균은 각 벤치마크를 0–100으로 정규화한 뒤 비가중 평균한 값이며, 카테고리 평균을 다시 단순 평균한 값은 아니다.[4]
문서·차트·공간·영상 이해를 묶은 요약 지표이지, 개별 업무의 보장된 정확도는 아니다.
음성·Omni·d1은 서로 다른 제품 부품이다
Audio의 인코더는 인과적 구조라 말하는 동안 입력을 처리하고, LiquidCodec은 생성된 오디오 토큰을 스트리밍 음성으로 바꾼다.[5]
공식 자료의 최저 50ms 첫 토큰 지연과 Apple M4 Max의 CPU 한 스레드에서 약 87배 실시간 코덱 디코딩은 각각의 조건과 처리 구간에 붙은 수치다.[5]
전체 음성 대화가 언제나 50ms에 끝나거나, 모든 처리가 실시간의 87배라는 뜻은 아니다.
또한 18개 언어의 음성 인식·합성·번역 지원을 모든 실시간 기능의 언어 범위로 확대하면 안 된다.[5]
Audio 카드는 음성 대화와 LiveASR를 현재 영어 전용으로 안내한다.[5]
한국어 음성 서비스를 만들려면 기능별 지원과 실제 발화·소음 조건을 따로 검증해야 한다.
Omni는 영상과 그 음성을 함께 받아 텍스트나 음성으로 답하는 통합 경로다.[6]
반면 d1은 긴 답변을 생성하는 챗봇이 아니라 한 번의 순전파에서 여러 질문의 타입별 답과 확률을 읽는 결정 모델이다.[7][8]
라우팅·분류·추출·검사처럼 설명문보다 판단 결과가 필요한 단계에 어울린다.
다만 d1-2B의 컨텍스트 명세가 128K여도, 카드는 누적 state가 약 64K 토큰을 넘으면 답의 신뢰도가 낮아진다고 경고한다.[7]
입력 가능한 최대 길이와 안정적으로 판단하는 범위는 구분해야 한다.
d1-Omni는 음성을 추가하지만 전사문이나 음성을 출력하지 않는다.[8]
카드에는 긴 음성에서 정확도가 떨어지며, 음성이 필요 없다면 텍스트·단일 박스와 보정 성능이 더 나은 d1-2B를 권한다고 적혀 있다.[8]
‘Omni’라는 이름만 보고 항상 더 적합한 대체재라고 고를 수는 없다.
로컬 배포에서는 1GB보다 전체 경로를 봐야 한다
약 1GB라는 소개는 텍스트 모델의 4비트 정밀도 조건이다.[1][3]
긴 문맥의 KV 캐시, 실행 버퍼, 시각·음성 구성요소까지 포함한 전체 앱 메모리로 해석하면 안 된다.
공식 발표도 텍스트 모델의 128K KV 캐시에 1.6GB가 필요하다고 별도로 설명한다.[2]
엣지 속도 비교 역시 조건이 있다.
텍스트 모델의 공식 실험은 Q4_0 GGUF, 32,768토큰 컨텍스트, 배치 1, 100토큰 출력, GPU 오프로딩을 사용했다.[3]
LFM3 지원 빌드와 비교 모델의 llama.cpp b11744가 쓰였으므로, 결과를 임의의 최신 런타임·양자화·문맥 길이로 옮기면 안 된다.[3]
서버 GPU의 고동시성 처리량도 개인 노트북의 단일 대화 지연과 별개다.
런타임 지원은 모델별로 확인해야 한다.
발표는 넓은 생태계 지원을 내세우지만, 확인 시점의 VL 모델 카드에는 SGLang 지원 PR이 검토 중이고 vLLM 지원은 진행 중이라고 적혀 있다.[4]
연결된 SGLang PR도 미병합 상태였다.[11]
저자가 사용한 지원 빌드, 배포된 체크포인트 형식, 정식 릴리스에서 즉시 실행 가능한 기능을 구분해야 한다.
Omni 카드 역시 SGLang 경로를 텍스트 출력으로 안내한다.[6]
모델 자체의 음성 생성 능력이 모든 서빙 경로에서 제공되는 것은 아니다.
Transformers 예제는 trust_remote_code=True를 사용한다.[1][4][6]
이는 모델 저장소의 코드를 실행하는 경로이므로, 제품 적용 시 코드를 검토하고 리비전을 고정하는 편이 안전하다.
로컬 모델을 쓴다고 웹 검색·도구 호출까지 자동으로 오프라인이 되는 것도 아니다.
전문화의 출발점이지, 모든 앱의 완성본은 아니다
공식 튜토리얼은 문서 JSON 추출, 음성 명령의 함수 호출, 영상·음성 결합 질의 등 구체적인 미세조정 과제를 제공한다.[1]
다만 ‘단일 GPU 가능’은 GPU 종류나 학습 범위가 무관하다는 뜻이 아니다.
예를 들어 Omni의 의료 영상·음성 질의 튜토리얼은 A100을 권장하고, 시각·음성 인코더를 고정한 채 언어 모델에 LoRA를 적용한다.[10]
전체 모델의 장문·고해상도 학습 비용과는 다른 조건이다.
로보틱스는 별도 적응의 예시다.
공식 발표는 VL에서 오케스트레이션·내비게이션·조작 모델을 각각 학습하고, 조작 VLA에는 행동 쿼리의 은닉 상태를 연속 행동으로 바꾸는 MLP를 추가했다고 설명한다.[2]
보고된 LIBERO 평균 96.2%와 RoboCasa-GR1 45.7%는 그 적응된 VLA의 결과이며, 공개 VL 체크포인트를 바로 로봇에 연결했을 때의 성공률은 아니다.[2]
공식 글에 연결된 로보틱스 시연이다.[1]
공통 VL 백본을 별도 학습·제어 구성으로 전문화하는 사례로 보는 편이 맞다.[1][2]
마지막으로 open-weight와 무제한 상업 이용은 다르다.[9]
모델의 실제 조건은 LFM Open License v1.0이며, 연매출 1,000만 달러 기준의 상업적 사용 제한과 재배포 시 라이선스·변경 표시·출처 고지 의무를 포함한다.[9]
기업 제품에 넣을 때 Apache-2.0 같은 라이선스로 간주해서는 안 된다.
LFM3의 가장 실용적인 메시지는 ‘모든 것을 작은 모델 하나로 대체하자’가 아니다.
업무에 필요한 모달리티와 출력 방식을 고르고, 실제 데이터로 전문화한 뒤, 그 조건의 품질·지연·메모리를 검증하자는 것이다.
공개된 가중치와 튜토리얼은 출발점을 낮추지만, 이 글의 성능 수치는 저자 보고값이며 로컬 추론이나 학습을 재실행한 결과는 아니다.