같은 오픈 웨이트 모델을 쓰는데 공식 서비스보다 에이전트가 자주 실패한다면, 가중치보다 먼저 살펴볼 것이 있다.
핵심은 서빙 엔진이 도구 호출 형식을 실제로 강제하는지 여부다.
Ubicloud는 Kimi K2.6을 vLLM 0.28로 서빙할 때 도구 호출 스키마 정확도가 92%였고, 제약 디코딩을 적용한 뒤 100%를 확인했다고 보고했다.[1]
2026년 10월 20일 Jesse Donkervliet와 Junhao Li가 공개한 이 글은 새 모델이나 학습 기법이 아니라 추론 런타임의 설정 회귀를 추적한 운영 사례다.[1]
핵심은 “제약 디코딩을 지원하는 버전인가”와 “이 요청에 그 제약이 활성화됐는가”가 서로 다른 질문이라는 점이다.[4][5]
단, 여기서 100%는 해당 평가의 스키마 준수율이다.[2]
올바른 도구 선택, 인자 값의 의미, 외부 도구 실행 성공이나 최종 과제 해결률까지 100%라는 뜻은 아니다.[3]
무엇이 실패했는가: 자연어가 아니라 호출 계약
도구를 사용하는 모델은 함수 이름, 인자 타입, 필수 필드 등이 담긴 스키마를 입력받는다.[1]
모델 출력에는 모델별 구분 토큰과 인자 JSON이 섞이며, 서빙 엔진의 파서가 이를 클라이언트가 소비하는 tool_calls로 바꾼다.[1]
따라서 도구 사용은 모델의 생성 능력뿐 아니라 템플릿 → 출력 형식 → 파서 → 인자 검증이 맞아야 성립한다.
Ubicloud가 든 예처럼 사용 가능한 도구가 web_search인데 search_web을 생성하거나, 스키마가 location을 요구하는데 다른 필드를 내보내면 호출 계약이 깨진다.[1]
이런 오류를 재시도로 수습하면 비용이 늘고, 오류 메시지가 다음 턴의 컨텍스트에도 남는다는 것이 원문의 문제의식이다.[1]
다만 “JSON을 파싱할 수 있다”와 “스키마를 만족한다”도 구분해야 한다.
공개 K2VV 검증 코드는 함수 이름에 대응하는 스키마를 찾고, 인자 문자열을 JSON으로 읽은 뒤 jsonschema.validate로 검사한다.[3]
JSON 문법이 맞아도 필수 필드나 타입이 틀리면 이 검증을 통과하지 못한다.[3]
제약 디코딩: 완성된 답을 고치는 대신 후보 토큰을 제한한다
제약 디코딩은 생성 후 잘못된 JSON을 수정하는 방식이 아니다.[9]
각 디코딩 단계에서 현재 문법 상태와 양립하지 않는 토큰을 마스킹하고, 남은 후보 중에서 다음 토큰을 선택하게 한다.[9]
출력이 허용된 구조 안에 머물도록 생성 경로를 제한하되, 그 안에서 어떤 토큰을 선택할지는 여전히 모델의 확률에 따른다.[1]
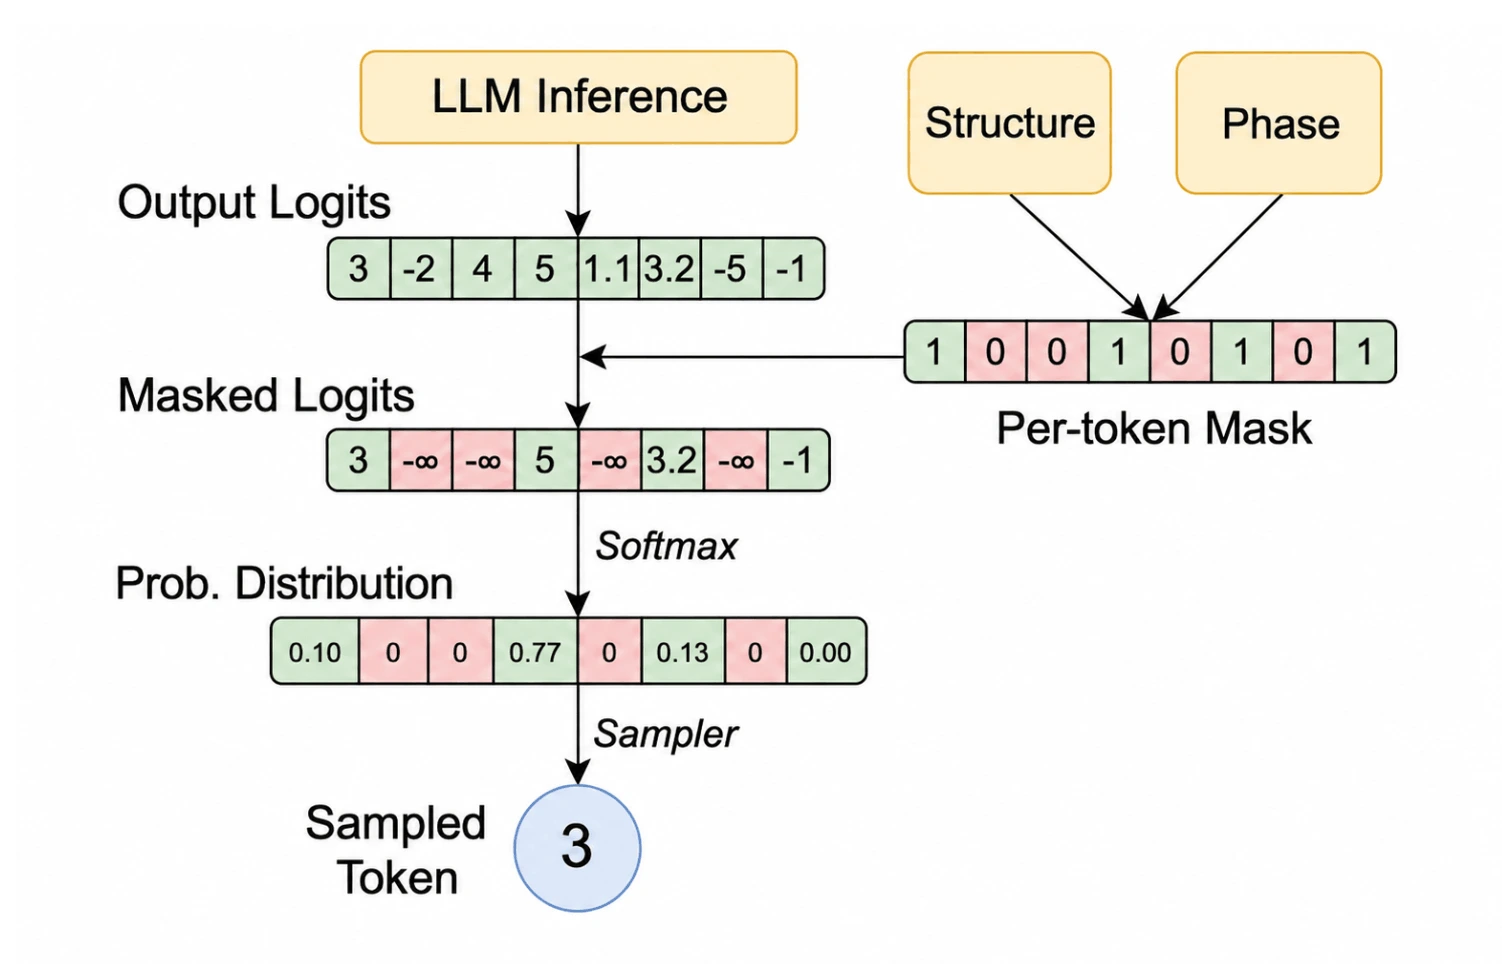
도구 호출은 JSON 하나로 끝나지 않으므로 XGrammar는 structural tag로 모델별 구분자와 구조화된 영역을 함께 표현한다.[7]
원문이 연결한 Kimi 형식 구현은 함수 이름이 포함된 시작 구분자, 숫자 인덱스, 인자 시작 구분자, 스키마 기반 JSON, 종료 구분자를 순서대로 조합한다.[8]
도구 호출이 시작되면 문법을 적용하되, tool_choice="auto"에서 일반 텍스트 응답까지 금지하거나 반드시 도구를 호출하게 만드는 것은 아니다.[4][7]
형식 강제와 호출 의무는 별개다.
지원 기능이 왜 꺼졌는가
Ubicloud는 자체 vLLM 포크에서 제약 디코딩을 사용하다가 v0.25의 업스트림 기능으로 전환했지만, 이후 스키마 정확도가 91%로 다시 떨어진 것을 발견했다고 설명한다.[1]
이 91%는 글 앞부분의 v0.28 기준 92%와 별도로 서술된 관찰값이지, 동일 실험의 정밀한 시계열 표는 아니다.[1]
관련 변경인 PR #45600은 tool_choice="auto"에서 명시적으로 strict: true를 설정한 도구가 없으면 structural tag를 붙이지 않도록 했다.[5]
제약 디코딩 구현이 사라진 것이 아니라 기본 활성화 조건이 달라진 것이다.[5]
원문은 다양한 모델의 출력 성향, 스키마를 문법으로 옮기는 버그, speculative decoding 등 다른 기능과의 상호작용을 배경으로 든다.[1]
여러 모델을 지원하는 엔진의 보수적인 기본값과, 특정 Kimi·DeepSeek 배포에서 원하는 품질 정책이 다를 수 있다는 설명이다.[1]
이 간극을 운영자가 조정하도록 PR #56268에서 서버 옵션을 추가했다.[6] v0.31 문서의 강제 수준은 다음과 같다.[4]
| 서버 수준 | 강제 범위 |
|---|---|
auto |
요청의 호출 모드와 도구별 strict를 따름 |
function |
호출 구분자와 함수 이름을 제한 |
parameter |
모든 도구의 인자 스키마까지 강제 |
function만 설정하면 모든 인자 스키마가 강제되는 것은 아니다.[4]
structural-tag 경로에서 개별 도구의 인자 스키마는 그 도구의 strict: true 또는 서버의 parameter 수준에 의해 고정된다.[4]
한 요청의 도구 하나가 strict라고 해서 나머지 도구까지 같은 인자 제약을 받는 것도 아니다.[4]
또한 VLLM_ENFORCE_STRICT_TOOL_CALLING=false는 structural tag를 비활성화하고 서버 수준 설정보다 우선한다.[4]
플래그 하나만 확인할 것이 아니라 환경 변수, 선택한 파서의 지원 범위, 요청의 tool_choice와 도구별 strict를 같이 봐야 한다.[4]
92%에서 100%: 지표의 분모부터 확인한다
Ubicloud가 보고한 개선은 스키마 정확도 8%포인트 상승이다.[1]
하지만 그 숫자는 벤치마크에서 어떤 도구 호출이 검증 대상으로 집계됐는지와 함께 읽어야 한다.[2][3]
| 지표 | 확인하는 것 |
|---|---|
| 호출 트리거 유사도 | 공식 API와 도구 호출 여부가 얼마나 비슷한가 |
| 스키마 정확도 | 호출을 반환한 응답의 인자 구조가 유효한가 |
K2VV의 트리거 유사도는 공식 Moonshot API의 호출 여부와 비교하는 F1 지표이며, 스키마 정확도는 구조 검증을 통과한 도구 호출 응답의 비율로 설명된다.[2]
공개 코드도 finish_reason == "tool_calls"인 응답을 따로 집계하고, 한 응답에 여러 호출이 있으면 모두 검증을 통과해야 유효하다고 처리한다.[3]
공개 코드의 분모는 finish_reason == "tool_calls"인 응답 수다.[3]
호출을 내보내지 않은 응답이나 HTTP 실패까지 합친 서비스 성공률과는 다른 지표다.[3]
검증기는 도구를 실제 실행해 업무 결과가 맞는지 확인하는 것이 아니라, 선언된 이름과 JSON Schema를 검사한다.[3]
Ubicloud 글은 2,000개 요청의 workload를 설명하지만, 현재 K2VV README는 전체 4,000개와 공개 샘플 50%를 안내한다.[1][2]
README의 공개 결과 표도 2025년 11월 측정 스냅샷이므로, 이를 그대로 2026년 Ubicloud의 K2.6 실험 결과와 합치면 안 된다.[2]
원문은 Kimi와 DeepSeek의 서빙 모델 버전들에서 재검증 후 운영에 반영했다고 보고하지만, 그 글만으로 모델별 전체 실행 설정·성공 건수·지연 시간 분포를 복원할 수는 없다.[1]
업체가 보고한 결과와 코드에서 확인한 메커니즘은 구분해야 하며, 여기서 독립적인 GPU 재현 실험을 수행한 것은 아니다.
실무에서는 어디까지 적용할 것인가
스키마 강제가 목표라면 다음은 서버 정책을 표현하는 설정 예시다.MODEL과 PARSER는 실제 배포 모델과 지원 파서에 맞춰 지정해야 하며, Ubicloud의 전체 운영 명령을 복원한 예시는 아니다.[4]
vllm serve "$MODEL" \
  --host 127.0.0.1 \
  --enable-auto-tool-choice \
  --tool-call-parser "$PARSER" \
  --tool-strict-level parameter
공식 문서는 strict 스키마 호환성을 위해 각 객체에 additionalProperties: false를 두고, 속성을 required에 포함하며, 선택적 값은 null을 허용하는 방식으로 표현하라고 권한다.[4]
기존 도구 정의에 strict 옵션만 붙이기 전에, 스키마 자체와 클라이언트가 기대하는 인자 표현을 점검해야 한다.
다만 문법 엔진이 지원하는 스키마 범위도 보장의 조건이다.
원문이 인용한 issue #58930은 structural tag 내부 JSON Schema의 미지원 기능 검사가 누락되어, 예를 들어 multipleOf 제약이 무시될 수 있다고 보고한다.[10]
이 이슈의 특정 버전·재현 조건을 모든 최신 배포의 확정적 결함으로 일반화할 수는 없지만, “strict를 켰으니 모든 JSON Schema 키워드가 완벽히 보장된다”는 해석은 피해야 한다.[10]
성능도 같은 원칙으로 봐야 한다.
XGrammar 논문은 사전 검사·캐시와 CPU/GPU 작업 중첩으로 구조화 생성 오버헤드를 줄이는 설계를 제시하지만, 그 결과가 임의의 도구 스키마·하드웨어·동시성에서 비용이 0이라는 뜻은 아니다.[9]
Ubicloud 글에도 별도의 상세 지연 시간 비교표는 제시되지 않는다.[1]
배포 검증은 스키마 준수율뿐 아니라 호출 트리거, 실제 과제 성공, 재시도 수, 지연 시간과 요청 실패율을 함께 보는 편을 권한다.
특히 도구 이름과 타입을 맞추는 것만으로는 URL 접근 권한, 인자의 업무상 타당성이나 실행 부작용이 검증되지 않는다.
호출 실행기의 권한 검사와 입력 검증은 여전히 별도의 책임이다.
이 사례의 가장 실용적인 결론은 모델 평가의 단위를 넓히는 것이다.
가중치만이 아니라 서빙 버전·채팅 템플릿·파서·문법·기본값까지 하나의 품질 계약으로 관리해야 한다.
제약 디코딩은 에이전트의 모든 판단을 고치는 기술이 아니라, 그중 형식 오류라는 한 계층을 줄이는 장치다.