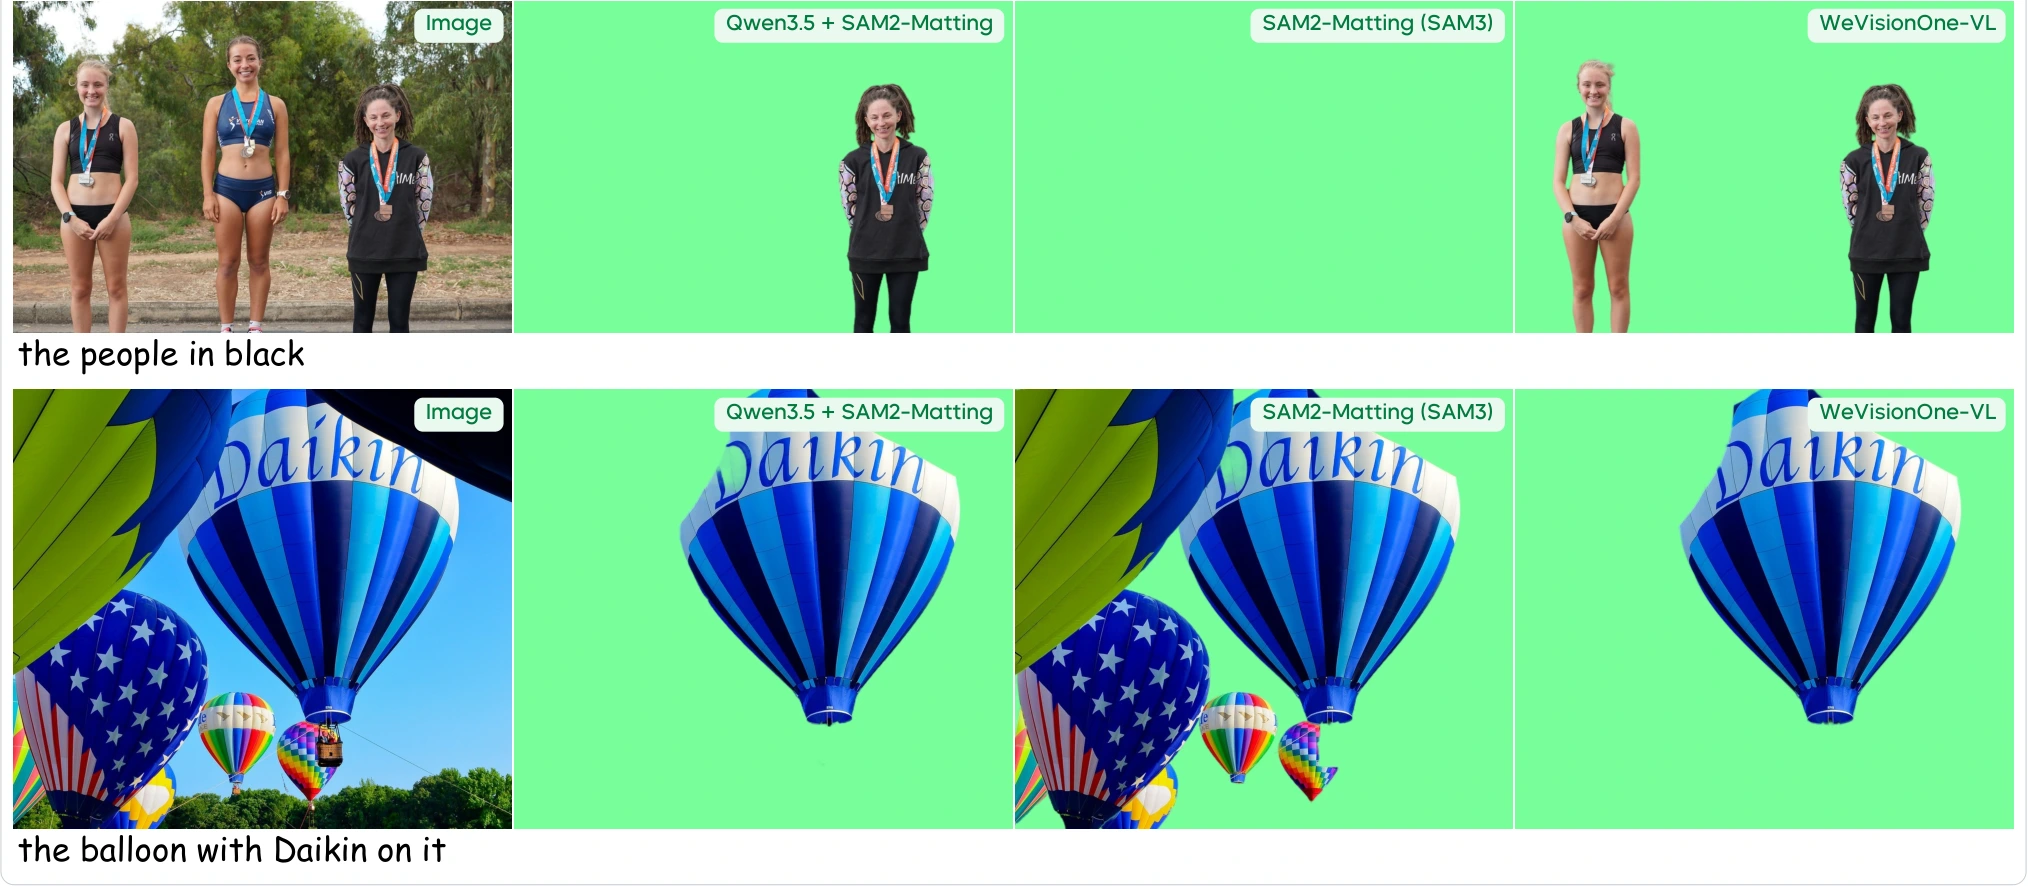
사진에서 “검은 옷을 입은 사람들”을 찾는 것과, 그 사람들의 머리카락까지 자연스럽게 오려내는 것은 다른 문제다.
전자는 언어와 위치를 연결해야 하고, 후자는 경계의 미세한 구조와 부분적인 투명도까지 복원해야 한다.
WeVisOne-VL은 이 두 수준의 지각을 하나의 VLM과 작은 픽셀 디코더로 연결한다.[2]
텐센트 WeChat Vision 팀이 2026년 10월 22일 공개한 WeVisOne-VL: Unified Visual Perception from Objects to Pixels는 Qwen3-VL 기반의 2B·4B 모델을 제안한다.[1][2]
탐지·지칭 대상 찾기·개수 세기·점 지정·OCR에서 이진 마스크 분할과 알파 매팅까지, 같은 자연어 인터페이스로 다룬다.[3]
핵심은 픽셀을 전부 긴 토큰열로 생성하는 것이 아니다.[2]
물체의 위치와 표현은 VLM이 만들고, 조밀한 픽셀 출력은 약 9.6M 파라미터의 전용 디코더가 맡는다.[2]
여기서 9.6M은 전체 모델 크기가 아니라 추가 픽셀 디코더의 규모다.[5]
좌표 토큰과 인스턴스 토큰의 역할을 나눈다
모델은 정규화된 좌표를 <0>부터 <1000>까지 1,001개 전용 토큰으로 표현한다.[2]
박스는 좌표 토큰 네 개, 점은 두 개로 나타내며, 질의에 맞는 대상이 없으면 None을 출력하도록 학습한다.[2]
분할이나 매팅에서는 박스 뒤에 <OBJ> 토큰을 추가한다.[2]
이 토큰의 hidden state가 해당 인스턴스의 표현이 되고, 예측 박스와 Qwen3-VL 시각 인코더의 여러 층 특징을 함께 픽셀 디코더로 전달한다.[2]
따라서 <OBJ>는 그 자체가 마스크 문자열이 아니라, 언어·좌표 예측과 픽셀 예측을 잇는 연결점이다.[5]
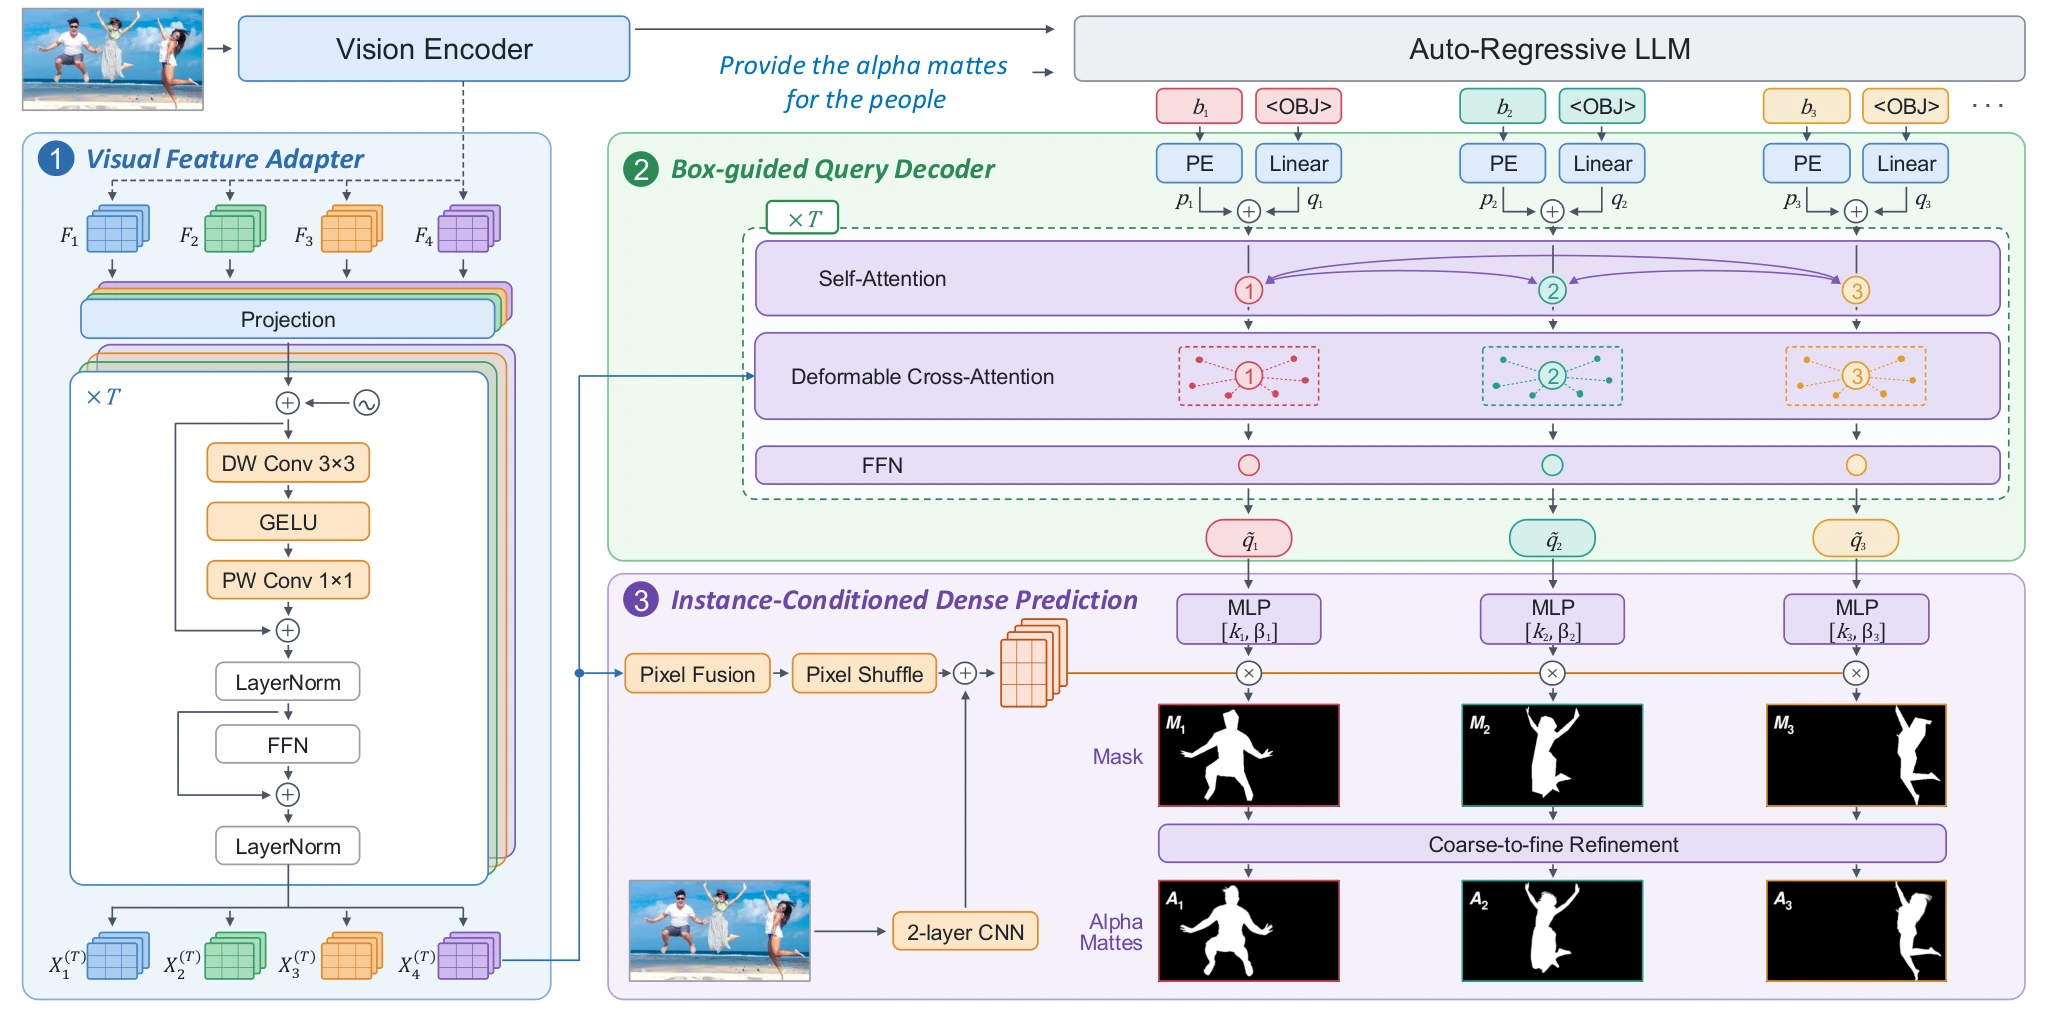
디코더는 공유 시각 특징을 정리하는 어댑터, 여섯 개 deformable 블록으로 인스턴스 질의를 갱신하는 부분, 동적 마스크 헤드와 coarse-to-fine 정제 부분으로 구성된다.[2]
분할은 물체와 배경을 나누는 이진 마스크를, 매팅은 머리카락·털·반투명 경계에 필요한 연속 알파 값을 예측한다.[2]
추론에 별도 SAM 백본을 붙이지 않는다는 것과, SAM을 전혀 쓰지 않았다는 것은 다르다.
데이터 엔진은 SAM3와 다른 위치 추정 전문가, Qwen3-VL 검증, SAM2 마스크 생성 등을 활용해 감독 데이터를 만든다.[2]
공유 시각 특징을 재사용하는 설계의 이점은 추론 단계에서 대형 분할 모델을 다시 호출하지 않는 데 있다.[3]
학습은 형식 정렬에서 픽셀 감독으로 확장한다
WeVisOne-VL Data Engine은 범주와 지칭 표현을 지식 그래프로 정리하고, 여러 전문가가 제안한 영역을 의미적으로 검증한 뒤 박스·마스크·알파 감독으로 확장한다.[2]
논문은 주석 인벤토리가 1억 장 이상의 이미지와 약 36억 개의 박스로 구성된다고 설명한다.[2]
이 이미지 수를 각 학습 단계에서 사용한 샘플 수와 같은 숫자로 읽어서는 안 된다.
SFT는 세 단계다.[2]
첫 단계는 새로운 토큰과 출력 규약을 익히고, 두 번째는 해상도와 밀집도를 높이며, 세 번째는 토큰 예측과 픽셀 감독을 연결한다.[2]
처음부터 수백 개 박스가 담긴 응답으로 학습하면 반복 출력으로 무너질 수 있어, 초기에는 범주당 최대 50개 박스·점 위주로 시작한 뒤 두 번째 단계에서 최대 500개로 확장한다.[2]
디코더 warm-up 뒤에는 학습된 디코더와 <OBJ> 임베딩만 가져와 원래 두 번째 단계 VLM에 연결하고, 다음 토큰 예측과 분할 학습을 1:1로 교대한다.[2]
이후 VLM을 고정하고 매팅용 디코더를 추가 학습한다.[2]
단순히 하나의 손실로 모든 모듈을 끝까지 동시에 학습하는 방식은 아니다.
SFT 다음에는 178K개 예시를 사용한 혼합 과제 GRPO가 이어진다.[2]
일부 응답은 성공하고 일부는 실패하는 불확실한 샘플을 우선 선택하고, 박스의 일대일 매칭과 IoU 기반 보상으로 누락·중복·위치 오류를 줄이려 한다.[2]
중요한 제한은 분할·매팅 과제의 RL도 박스 기반 보상만 사용한다는 점이다.[2]
마스크나 알파 매트를 직접 평가하는 보상이 아니므로, 픽셀 품질의 개선을 전부 RL 덕분으로 해석하면 안 된다.[2]
결과는 높지만, 지표와 프롬프트 조건을 먼저 봐야 한다
논문은 30개 이상의 벤치마크를 보고하며, 추론에는 temperature 0의 greedy decoding과 이미지당 최대 1,960개 시각 토큰을 사용한다.[2]
다음은 논문 비교표에서 발췌한 일부 4B 결과다.[2]
| 평가·지표 | 비교값 → 4B |
|---|---|
| Dense200 / 탐지 F1 Mean | 58.7 → 71.3 |
| TotalText / OCR F1 Mean | 43.3 → 52.0 |
| ReasonSeg val / gIoU | 65.0 → 71.2 |
| P3M-500-NP / 매팅 MAD ↓ | 15.4 → 7.3 |
Dense200과 TotalText의 비교값은 LocateAnything-3B, ReasonSeg는 fine-tuning된 LISA-13B, P3M-500-NP는 SAM2-Matting의 SAM3 변형이다.[2]
마지막 행의 MAD는 논문 표처럼 원래 값에 1,000을 곱한 수치이며, 작을수록 좋다.[2]
과제마다 지표가 다르므로 이 값을 한 종류의 정확도나 평균 점수로 합쳐서는 안 된다.
탐지의 F1 Mean은 COCO mAP가 아니다.
논문은 confidence calibration을 요구하는 AP 대신 IoU 0.5~0.95의 여러 임계값에서 F1을 평균한다.[2]
OCR도 문자열만 읽는 시험이 아니라, 전사 문자열의 정확한 일치와 박스 IoU를 함께 요구하는 text grounding 평가다.[2]
따라서 TotalText의 52.0을 문자 인식률 52%나 일반 OCR 제품 정확도로 옮겨 읽으면 안 된다.
P3M-500-NP·AM-2K·PPM-100의 박스 프롬프트 실험은 모든 방법에 같은 정답 박스를 제공한다.[2]
좋은 알파 복원 결과이지만, 사용자의 자연어 질의에서 대상을 찾아내는 과정까지 포함한 end-to-end 성능은 아니다.[2]
사내 평가 WeRef-Bench에서 4B는 대상 부재 질의 거절률 96.4%를 보고하지만, 공개 PR-Bench에서는 52.6%, RefCOCOg-Rej에서는 67.4%다.[2]
대상이 없을 때 잘 거절한다는 주장은 벤치마크별 범위가 다르다.
한 데이터셋의 96.4%가 모든 현장 질의에 적용되는 보장은 아니다.
P3M-500-NP의 MAD는 2B가 6.6, 4B가 7.3이고, Ref-ZOM의 cIoU도 2B 73.4와 4B 72.2로 일부 지표에서는 2B가 앞선다.[2]
통합 모델의 장점은 여러 작업을 한 인터페이스로 연결하는 데 있으며, 모든 작업에서 큰 모델이 절대 우위라는 뜻은 아니다.
공개 가중치만이 아니라 픽셀 디코더까지 필요하다
현재 공식 저장소에는 2B·4B 가중치, 추론 패키지, 작업별 노트북과 평가 파이프라인이 안내되어 있다.[4]
4B 모델 카드가 명시한 mask_decoder.pt는 선택적 예제가 아니라 핵심 구성 요소다.[5]
실제 로더도 이 파일을 찾고, 디코더 설정과 가중치, <OBJ> 토큰 ID의 일치 여부를 검사한다.[8]
이 때문에 일반 채팅 API에서 텍스트와 박스만 받아서는 같은 픽셀 출력을 얻을 수 없다.[5]
인스턴스 hidden state와 ViT 중간 특징을 함께 추출하는 공식 추론 경로가 필요하다.[8]
패키지는 Python 3.10 이상을 요구하고 Transformers·PyTorch 및 선택적 vLLM 의존성을 지정한다.[7]
디코더가 작다는 이유만으로 전체 시스템의 메모리 사용량이나 실시간 속도를 단정할 수는 없다.
README의 fine-tuning 코드는 아직 TODO이며, 평가 문서는 저작권 때문에 데이터를 직접 제공하지 않고 원본에서 내려받아 구성하도록 안내한다.[4][6]
특히 텍스트 매팅용 WeRefMat은 아직 공개되지 않았다고 명시되어 있으므로, 평가 코드 공개와 모든 논문 결과의 즉시 재현을 구분해야 한다.[6]
코드와 공개 모델은 Apache-2.0으로 안내되지만, 제3자 구성 요소의 원래 조건과 저작권 표시는 유지된다.[9][10]
모델 LICENSE에는 기반인 Qwen3-VL-4B-Instruct와 그 라이선스도 별도로 기재되어 있다.[9]
배포 시에는 모델 카드의 태그뿐 아니라 이 파일과 사용하는 의존성의 조건까지 확인하는 편이 안전하다.
실무적 의미와 남은 한계
WeVisOne-VL은 탐지기·OCR·분할·매팅을 각각 연결하던 파이프라인을 자연어와 인스턴스 표현 중심으로 묶는 후보가 될 수 있다.
특히 콘텐츠 편집에서 무엇을 오릴지 고르는 능력과 어떻게 경계를 복원할지를 연결한다는 점이 흥미롭다.
그러나 논문은 범용 학습 데이터가 적어 기반 모델보다 일반 능력이 저하될 수 있고, 명시적 CoT 없이 구조화 출력을 직접 생성하며, 현재 단일 턴 예측에 한정된다고 적는다.[2]
모델 카드도 복잡한 투명도·가림·해상도와 질의 표현에 따른 민감성을 명시한다.[5]
따라서 범용 대화 모델이나 다중 턴 편집 에이전트의 완성품보다, 객체 수준의 선택을 픽셀 수준 결과로 이어 주는 지각 기반 모델로 보는 편이 정확하다.