고객 문의를 어느 부서로 보낼지, 문장이 정책 조건을 만족하는지처럼 필요한 답이 이미 정해진 작업이 있다.
이런 경우 긴 설명과 JSON을 생성한 뒤 다시 파싱하는 대신, 허용된 선택지의 확률을 바로 받는 인터페이스가 유용하다.
Bespoke Nimble은 텍스트와 질문 schema를 받아 이런 결정을 만드는 모델·데이터·학습 레시피 프로젝트다.[1]
핵심은 일반 대화 모델을 더 잘 말하게 만드는 것이 아니라, 제한된 후보 사이에서 직접 판단하게 학습하고 서빙하는 것이다.[1][2]
다만 “Nimble”이라는 이름에는 원래 공개 모델, 교체된 최신 checkpoint, v2·v3 adapter와 v4 API가 함께 등장한다.[1]
성능·확률 보정·라이선스를 읽을 때 이들을 같은 배포물로 취급하면 안 된다.[1][2][6]
생성 대신 후보 logits를 읽는다
Nimble의 로컬 모델은 각 enum·boolean 선택지를 단일 토큰 코드에 대응시키고, 그 코드들의 logits에 softmax를 적용한다.[1]
최종 typed output은 Python 코드가 조립하므로 모델이 생성한 JSON을 파싱할 필요가 없다.[1]
“한 단계 판단”은 질문별 답변 토큰을 직접 평가한다는 의미이지, 모델 전체 연산이나 긴 입력의 prefill이 사라진다는 뜻은 아니다.[1][3]
로컬 schema는 flat enum·boolean 중심이고, 이미지 입력·자유 서술·중첩 JSON·본문 구간 추출은 현재 공개 scorer의 범위가 아니다.[1]
질문별 판단도 서로 독립적이므로, 필드 간 모순은 응용 코드가 확인해야 한다.[1][3]
어느 선택지도 맞지 않는 입력이 가능하다면 no_match 같은 후보와 별도 검토 경로를 마련하는 편이 낫다.[1]
호스티드 API의 세 질문형은 다음처럼 읽는다.
이는 로컬 Python schema와 이름·반환 형태가 완전히 같다는 뜻은 아니다.[1][10]
| 질문형 | 의미 |
|---|---|
| Noul | 명제가 참일 확률 |
| Choice | 선택된 후보와 모든 후보의 확률 |
| Score | 순서가 있는 등급의 확률 가중 기대값 |
API의 confidence는 분포가 얼마나 한쪽에 몰리는지를 요약하는 값이지, 정답일 확률이 아니다.[10]
Score 역시 가장 확률이 높은 등급과 기대값이 다를 수 있으므로, 순위화·임계값·정확한 등급 일치 중 무엇이 필요한지 먼저 정해야 한다.[10]
로컬 MLX와 CUDA는 같은 서빙 경로가 아니다
Mac의 ParallelScorer는 공통 context·schema prefix를 한 번 처리하고, 질문별 suffix를 분기해 평가한다.[3]
이는 여러 모델 프로세스를 동시에 띄우는 것이 아니라 GPU batch 연산이며, attention KV뿐 아니라 Qwen 계열의 recurrent state도 분리해 다룬다.[3]
반면 현재 CUDA scorer는 질문마다 전체 prompt를 다시 처리한다고 README가 명시한다.[1]
공개 병렬화 벤치마크의 최대 7.25배 수치는 M5 Pro 64GB에서 미세조정 Nimble이 아닌 Qwen3.5-4B 기반, 8개 필드·긴 공통 문맥을 사용한 합성 조건의 측정이다.[3]
모델 로딩·토큰화는 제외하며, 공통 prefix를 재계산하는 independent 경로와 비교한다.[3]
한 필드에서는 오히려 independent가 빨랐으므로, 이 수치를 9B 모델이나 CUDA·API의 보편적인 가속률로 옮길 수 없다.[3]
대조 데이터: 사실 하나가 바뀌면 답도 바뀌어야 한다
원래 공개 레시피는 질문과 정책을 유지한 채 중요한 사실 하나를 바꿔 label이 뒤집히는 쌍을 만든다.[1]
예를 들어 환불 승인 권한이 Mira에게만 있다는 규칙에서, 실제 서명자를 Mira에서 Noah로 바꾸면 승인 여부가 달라진다.[1]
표면 문체보다 판단을 바꿔야 하는 근거에 민감해지도록 데이터를 구성하는 방식이다.[1]
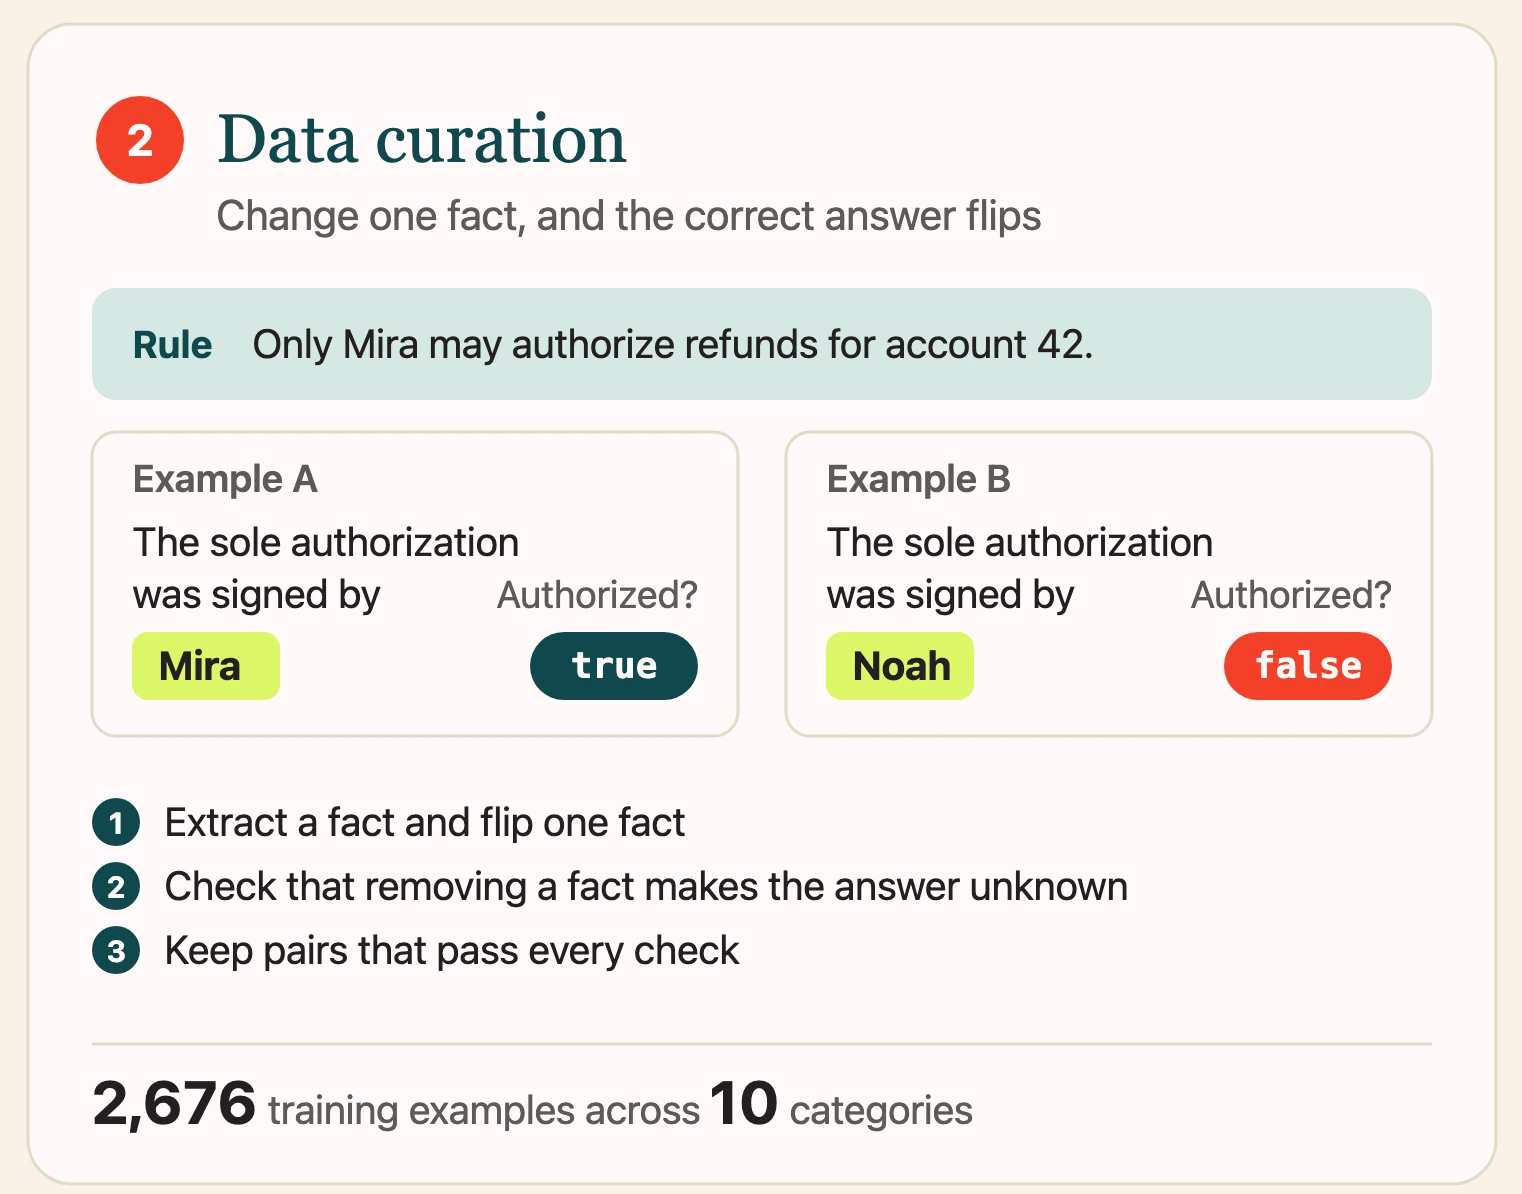
공식 인포그래픽에서 대조 데이터 부분을 발췌했다.
2,676개·10개 범주 표시는 원래 공개 데이터 레시피에 관한 수치이며, 최신 checkpoint 전체 학습량을 뜻하지 않는다.
원본 영문 표기는 유지했다.
모바일에서는 눌러 확대할 수 있다.[1][14]
큐레이션은 규칙의 결정 가능성을 점검하고, 두 근거가 모두 필요한 예제를 만든 뒤, 각 근거를 제거해도 답이 노출되지 않는지 검사한다.[1]
근거 제거 예제는 검사용이지 “근거가 없으니 거짓”이라는 추가 학습 label로 사용하지 않는다.[1]
같은 source family와 대조 쌍은 split을 함께 묶어, 가까운 변형이 train과 holdout에 나뉘는 것을 막는다.[1][14]
원래 레시피는 Qwen3.5-9B에 LoRA rank 16, 학습률 5e-5, effective batch 8로 한 epoch 학습하며, 허용 후보의 logits에 대한 cross-entropy를 사용한다.[1]
Jev에서 증류한 모델이라고 설명하지 않고, Jev에서 유래하지 않은 hard reference label을 썼다고 구분한다.[1]
그러나 label은 합성·모델 검사 결과이며 사람이 검수한 정답은 아니다.[1][14]
성능은 서로 다른 평가 묶음으로 나눠 읽어야 한다
[모델 카드·저장소 자기보고] 원본의 324개 합성 holdout에서 Nimble은 292개, 90.12%의 reference label과 일치했다.[1]
같은 비교에서 Qwen3.5-9B는 66.36%, Jev 1.13.0은 93.21%였다.[1]
이는 162개 대조 쌍·6개 source family의 좁은 평가이며, 일반적인 업무 정확도나 최신 v4 성능을 뜻하지 않는다.[1]
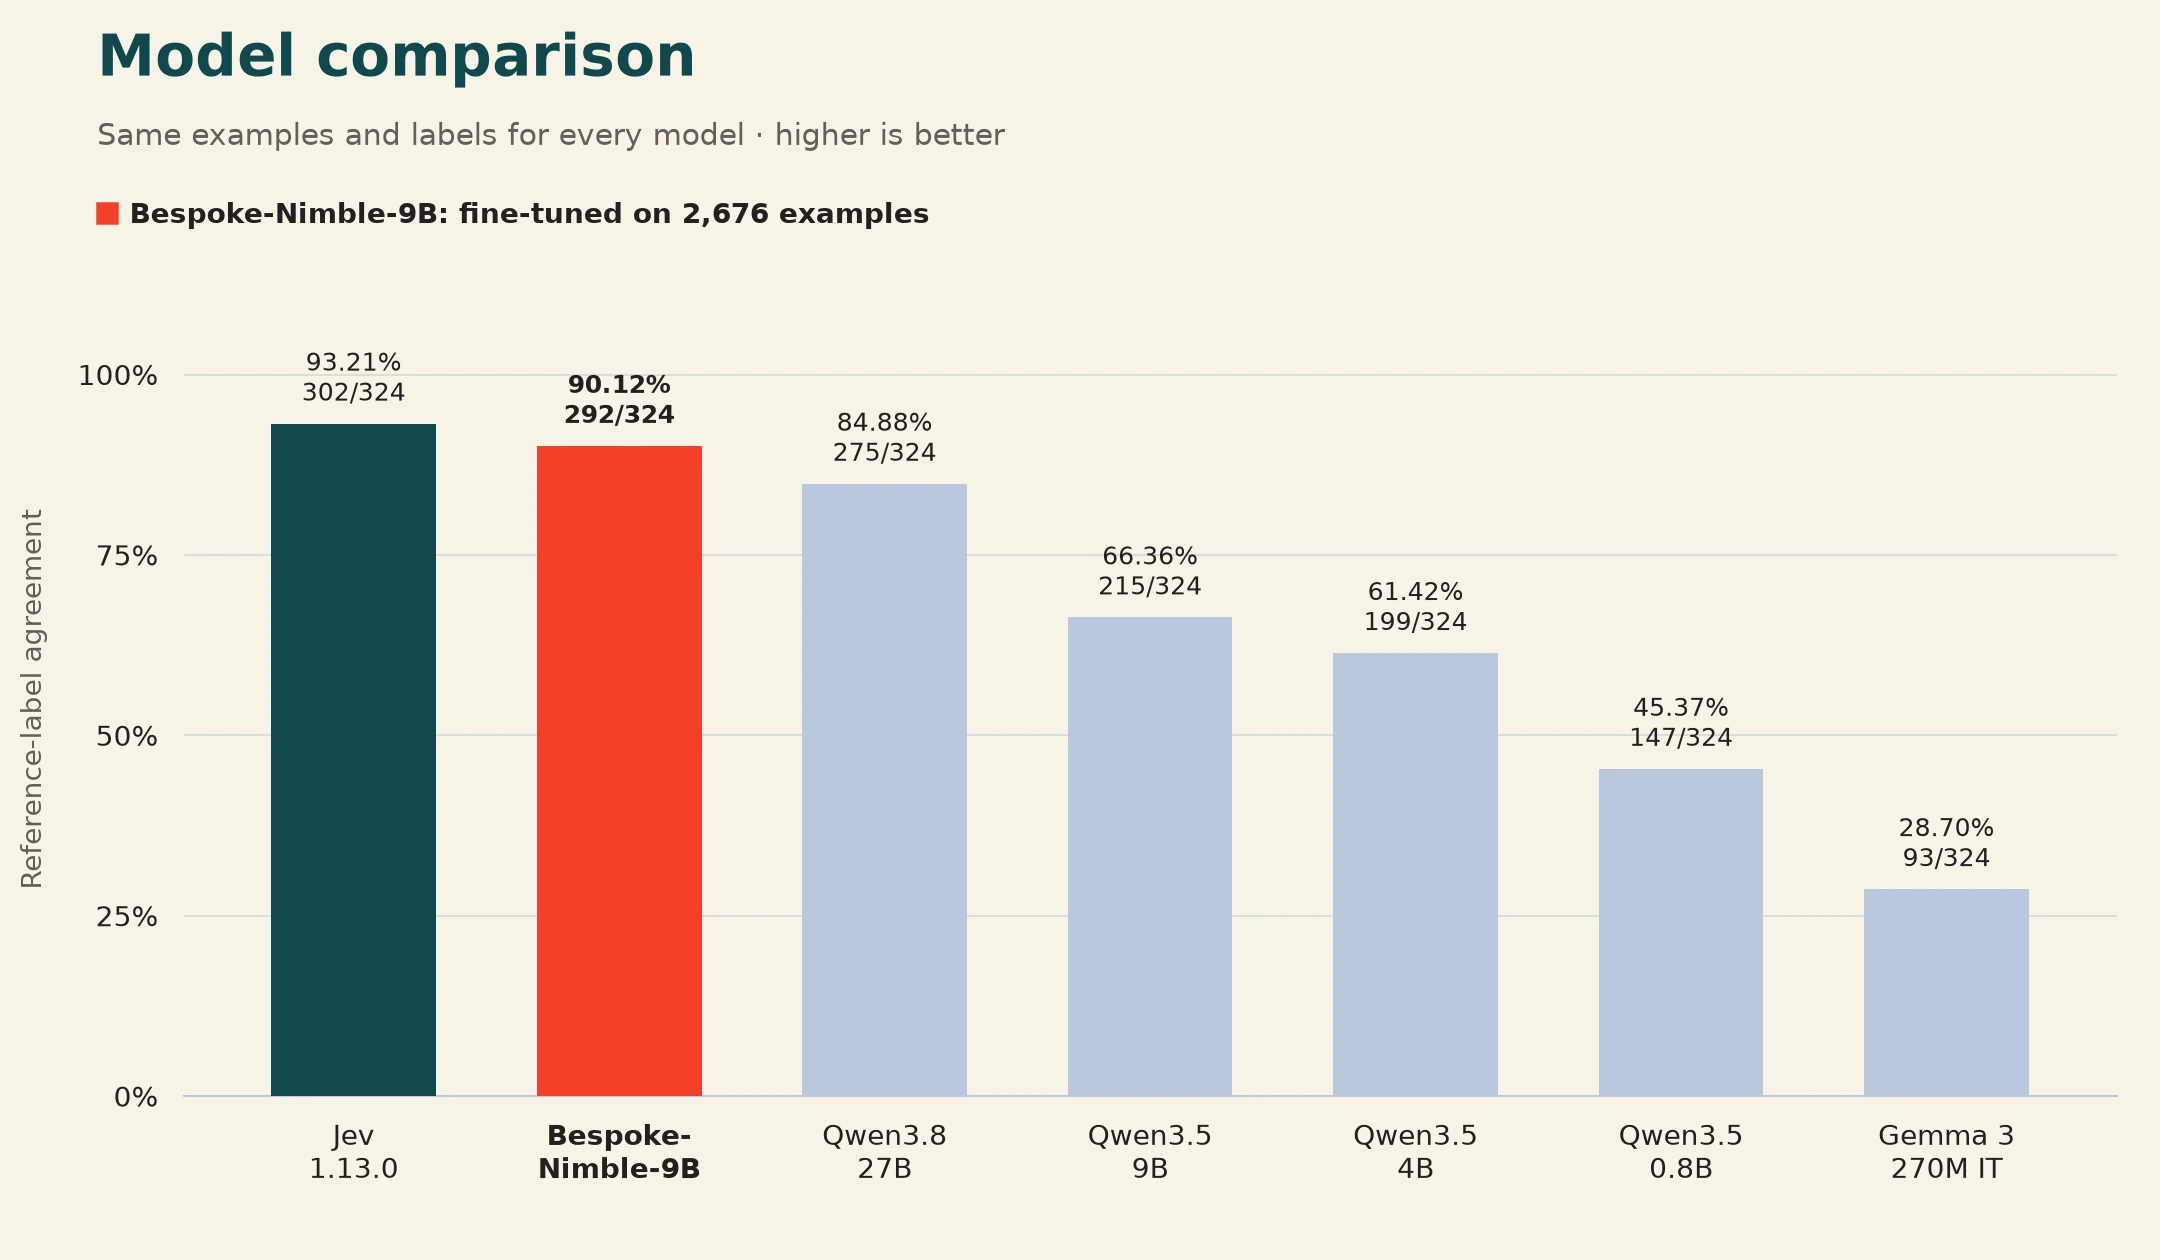
원래 레시피의 평가 그림.
최신으로 바뀐 모델 저장소를 다운로드해 같은 수치가 재현된다고 가정하면 안 된다.
모바일에서는 눌러 확대할 수 있다.[1][2]
[공식 자료] 저장소의 별도 public benchmark는 사람의 주석이 있는 13개 subset, 총 3,880개 record를 비교한다.[4]
보고된 macro 일치율은 Nimble 74.8%, Jev 76.0%이며, Nimble이 모든 작업에서 우세한 결과는 아니다.[4]
예를 들어 civil_comments는 70.3% 대 81.0%, summeval-relevance는 49.2% 대 35.0%로 강점이 갈린다.[4]
이 public suite 역시 저자 측 실행·변환 규약에 따른 결과다.[4]
확률 비교는 raw T=1.0 조건이고, 일부 subset은 독립 family가 적으며, 기반 모델의 학습 오염 가능성과 오래된 checkpoint 조건을 고려해야 한다.[4]
Jev의 반올림된 확률 때문에 NLL을 직접 비교하지 말라는 주의도 있어, 확률 품질을 한 숫자로 단정하기 어렵다.[4]
[제3자 자료] 외부 JevBench는 공개·sealed 결정, calibration, latency·cost와 그 버전별 산식을 따로 사용한다.[11][12]
Capability와 Composite도 서로 다른 지표이므로, 그 점수를 위의 label 일치율이나 README의 Decision Index 자기측정과 직접 비교하면 안 된다.[12]
README의 v4 “1위”는 2026년 10월 12일 저자 자체 실행으로, 해당 당시 dashboard 미등재라고 명시된 주장이다.
이를 독립 검증된 최신 순위로 인용하지 않는다.[1]
원본 데이터와 최신 checkpoint가 다르다
Hugging Face의 Bespoke-Nimble-9B는 전체 9B 가중치가 아니라 Qwen3.5-9B용 LoRA adapter와 tokenizer·prompt 규약·추론 helper를 담는다.[2]
현재 모델 카드는 8,192토큰·필드당 최대 255개 후보를 설명하고, 이전 checkpoint는 original-2676 revision으로 보존한다고 명시한다.[2]
현재 schema_config.json의 학습 감사 기록은 12,026개 training row인 반면, GitHub의 canonical data/train.jsonl은 원래의 2,676개를 유지한다.[13][14]
따라서 “데이터 2,676개로 학습한 원본의 평가”와 “같은 모델 이름에서 현재 받는 adapter”를 연결할 때는 정확한 revision을 고정해야 한다.[1][2]
기술 근거도 새 아키텍처 논문보다는 이 저장소의 레시피·model card·scorer 문서에 있으며, 문서의 오래된 26개 선택지·4B 예제를 최신 모델 계약과 혼동하지 않는 것이 중요하다.[1][2][3]
로컬 MLX 예제의 ParallelScorer() 기본값은 Nimble이 아니라 Qwen3.5-4B baseline이다.[1]
9B를 쓰려면 준비한 모델 경로와 ID·revision을 명시해야 하며, MLX는 LoRA adapter 폴더를 바로 읽지 못해 merge가 필요하다.[1]
현재 MLX runner는 양자화 가중치를 지원하지 않으며, 원래 CUDA adapter 평가를 merge 후 Mac의 품질·확률 보정 검증으로 대신할 수도 없다.[1]
확률 보정과 API 문서의 버전 경계
현재 9B checkpoint는 별도 temperature fit 없이 T=1.0을 사용한다.[2]
원래 release의 T=2.179는 그 checkpoint에서 맞춘 값이며, v2 기본값은 이를 이전한 것으로 독립 보정 결과가 아니다.[1][3]
temperature는 후보의 순서를 유지하더라도 Noul 확률과 Score 기대값을 바꾸므로, 모델·revision·runtime을 바꿀 때 임계값도 다시 검증해야 한다.[1][10]
호스티드 v4 API와 로컬 모델도 분리해야 한다.[1][2]
특히 2026년 10월 19일 확인한 공식 문서에서 overview는 nimble-latest가 nimble-v4를 가리킨다고 설명하지만, pricing은 nimble-v4가 deprecated되어 nimble-v4-max로 연결되며 latest도 max라고 표기한다.[8][9]
요금표는 max에 입력 100만 토큰당 0.04달러를 제시하지만, 문서 간 alias 설명이 불일치하므로 실제 제공 모델·청구 조건을 통합 전에 재확인해야 한다.[9]
이 불일치는 “모델 이름만 고정하면 확률과 임계값이 영구히 같다”는 가정을 피해야 할 이유이기도 하다.
로컬 추론은 입력을 외부 모델 API에 보낼 필요가 없지만, hosted API나 별도 데이터 생성 경로를 선택하면 전송 범위와 비용을 따로 검토해야 한다.[1]
라이선스는 모델·코드·버전별로 확인한다
공개 기본 9B adapter의 model card와 동봉 LICENSE는 Apache-2.0이다.[2][5]
그러나 GitHub 코드 저장소에는 확인 시점 루트 LICENSE가 없고, 이를 묻는 공개 issue #14도 답변 없이 열려 있었다.[7]
모델의 라이선스 태그를 코드·데이터 저장소 전체의 사용 허가로 확대하면 안 된다.[5][7]
v3 adapter는 별도 model card에서 CC BY-NC 4.0, 상업적 사용 불가를 명시한다.[6]
기본 모델의 Apache-2.0이나 원래 Nimble adapter 조건이 v3에도 자동 적용되는 것은 아니다.[6]
서비스에 넣을 때는 필요한 checkpoint와 코드·데이터의 권리 범위를 각각 확인하는 것이 먼저다.
실무 관점에서의 해석
Nimble은 고객 요청 라우팅, 근거 기반 boolean 검사, 제한된 rubric 평가처럼 결정 공간을 명시할 수 있는 작업에 잘 맞는 설계다.[1]
자유로운 설명·계획·복잡한 필드 간 의존성이 필요하다면 일반 생성 모델이나 별도 orchestration이 여전히 필요하다.[1]
확률이 높다는 이유만으로 결제를 취소하거나 정책 위반을 확정하기보다는, 자체 label 데이터에서 검토 임계값과 실패 처리 경로를 먼저 정하는 편이 안전하다.
[로컬 검증] 모델 가중치 추론과 hosted API 호출은 미수행이다.
공개 평가 수치는 해당 출처의 실행 조건으로 읽어야 하며, 이 글이 현재 checkpoint나 운영 환경의 성능을 독립 재현한 결과는 아니다.