에이전트가 파일을 제대로 저장하지 못한다고 모든 작업에 저장 검사를 추가하면, 파일을 만들 필요가 없는 작업까지 절차가 복잡해질 수 있다.
OO-Harness는 이런 문제를 하나의 만능 하네스를 계속 고치는 대신, 공통 코드를 물려받는 특화 하네스들을 만들고 상황에 맞게 고르는 문제로 바꾼다.[2]
Object-Oriented Harness: Evolving Agent Harnesses through Object-Oriented Design는 2026년 10월 20일 arXiv에 제출됐다.[1]
Gaotang Li와 Hanghang Tong은 University of Illinois Urbana-Champaign, 나머지 저자들은 Google Cloud AI Research 소속으로 표기돼 있다.[2]
DAIR.AI Academy도 이 연구를 작업별 하네스 선택과 객체지향 설계의 결합으로 소개한다.[3]
핵심은 모델 가중치를 바꾸는 학습이 아니다.[2]
하네스를 실행 가능한 클래스 계층으로 표현하고, 실행 근거를 보고 어떤 클래스를 쓸지 결정하는 구조다.[2]
탐색용 과제에서 코드를 진화시킨 뒤, 별도 평가 과제에서는 코드 계층과 교훈을 고정한다.[2]
하나의 전역 하네스와 독립적인 전문가들 사이
하네스는 모델 주변의 프롬프트·도구·컨텍스트 관리·실행 제어를 구현하는 코드다.[2]
논문은 이를 조직하는 세 방식을 대비한다.[2]
| 구성 | 코드와 실행 방식 |
|---|---|
| 전역 하네스 | 모든 작업에 하나의 구현을 적용 |
| 독립 특화 하네스 | 별도 구현들을 만들고 작업별로 선택 |
| OO-Harness | 공통 동작을 상속하고 필요한 부분만 특화해 선택 |
OO-Harness의 자식 클래스는 부모의 메서드를 그대로 쓰거나, 일부를 재정의하거나, 새 메서드를 추가할 수 있다.[2]
재정의할 때 super()를 호출하면 기존 검사와 새 검사를 함께 유지할 수 있다.[2]
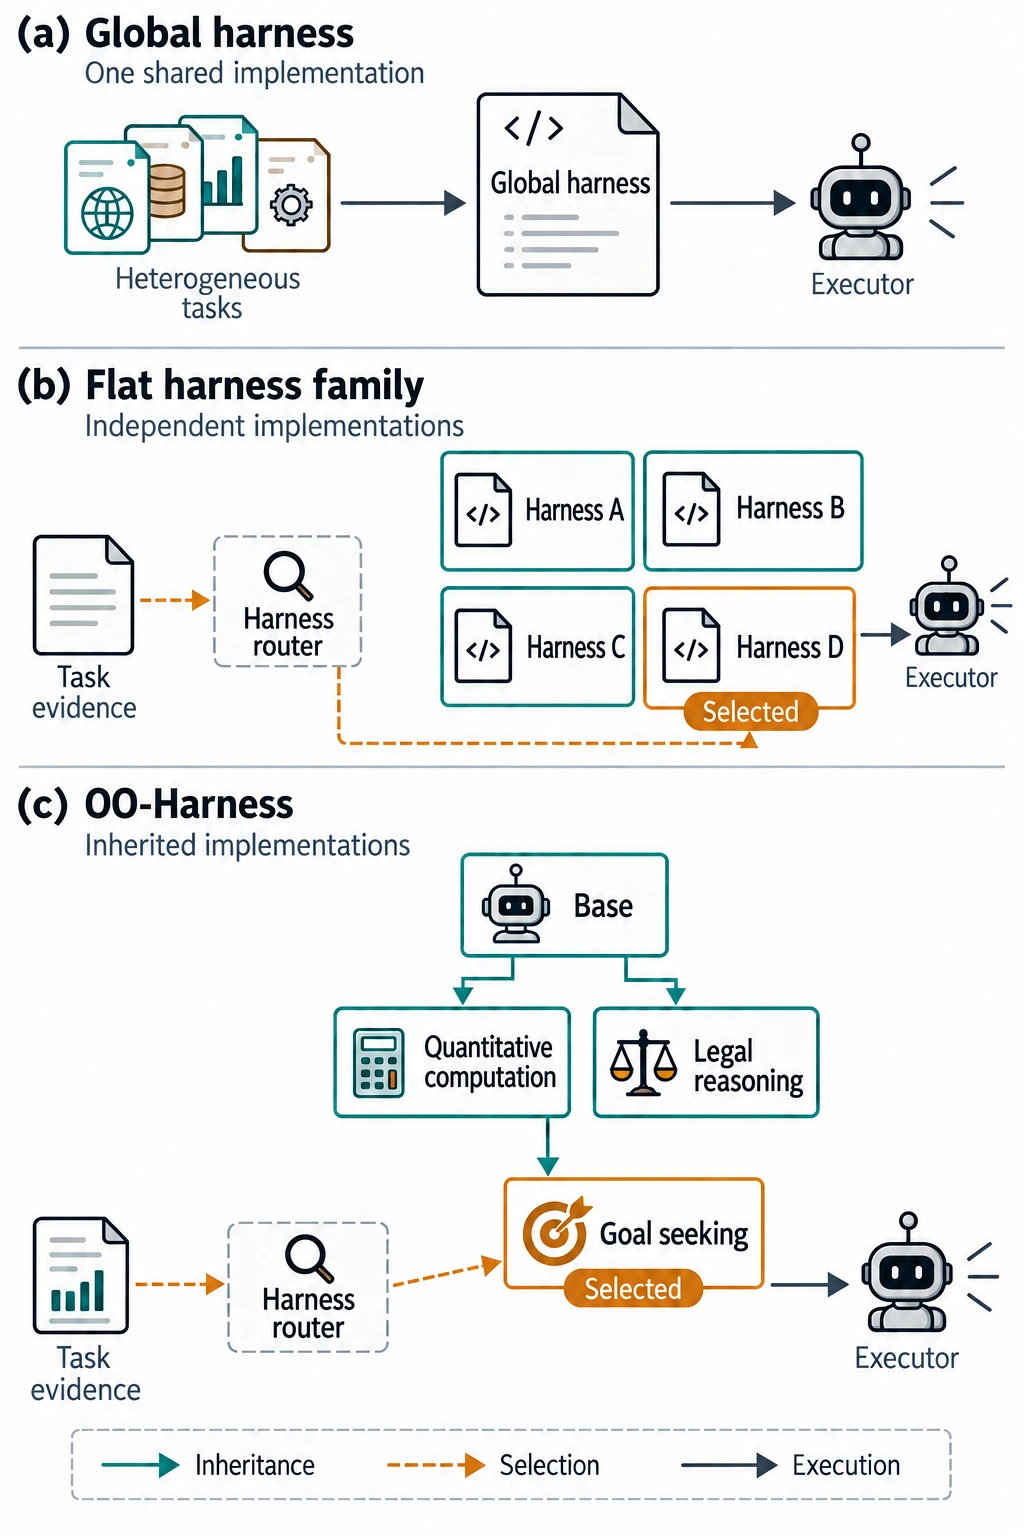
논문 그림 1(CC BY 4.0).
PDF에 포함된 고해상도 원본을 추출했다.
아래쪽 계층의 화살표는 코드 상속이며, 부모와 자식 에이전트를 차례로 실행한다는 뜻이 아니다.
원본 영문 표기는 유지했다.[4]
여기서 특히 중요한 것은 선택된 클래스 하나가 한 인스턴스로 실행된다는 점이다.[2]
조상 클래스마다 별도 에이전트를 호출하거나 계층 전체를 앙상블하는 방식이 아니다.[2]
공통 인터페이스는 실행을 통일하고, 상속은 코드 재사용을 담당한다.[2]
어떻게 진화시키는가: 작업 묶음과 코드 계층은 다르다
학습 단계의 첫 입력은 기본 하네스로 탐색용 과제를 수행한 궤적과 평가 피드백이다.[2]
비슷한 실행 요구나 실패를 공유하는 과제를 묶고, 각 묶음에 도움이 될 변경을 탐색한다.[2]
작업 클러스터는 근거를 조직하고, 클래스 계층은 재사용할 코드를 조직한다.
둘을 같은 트리로 볼 필요는 없다.[2]
한 번의 진화는 다음 순서로 진행된다.[2]
- 진화 에이전트가 실행 기록·기존 코드·이전 반성을 읽고 대상 클러스터와 부모 하네스를 고른다.[2]
- 공통 실패를 해결할 자식 클래스를 작성하고, 도구·검사·컨텍스트 관리 등 허용된 인터페이스를 수정한다.[2]
- 후보를 해당 클러스터의 탐색 과제에서 실행해 현재 배정된 하네스와 비교한다.[2]
- 클러스터 점수가 개선되고 벤치마크별 수용 조건도 통과하면 후보를 보존한다.[2] 실패한 제안의 기록도 다음 탐색에 남긴다.[2]
후보의 부모가 반드시 그 클러스터의 현재 하네스일 필요는 없다.[2]
또한 후보마다 전체 탐색 집합을 다시 돌리지 않고 대상 클러스터에서 평가한다.[2]
이 구조는 탐색 비용을 줄일 여지를 주지만, 채택 조건이 모든 작업에 대한 무퇴행 보장을 뜻하지는 않는다.[2]
교훈도 용도가 나뉜다.
설계 교훈은 어떤 코드 변경이 도움이 됐거나 실패했는지 안내하고, 라우팅 교훈은 어떤 관찰 상황에서 특정 하네스가 적합한지 안내한다.[2]
교훈 저장소의 사용 범위는 벤치마크별 구현에 따라 다르다.[2]
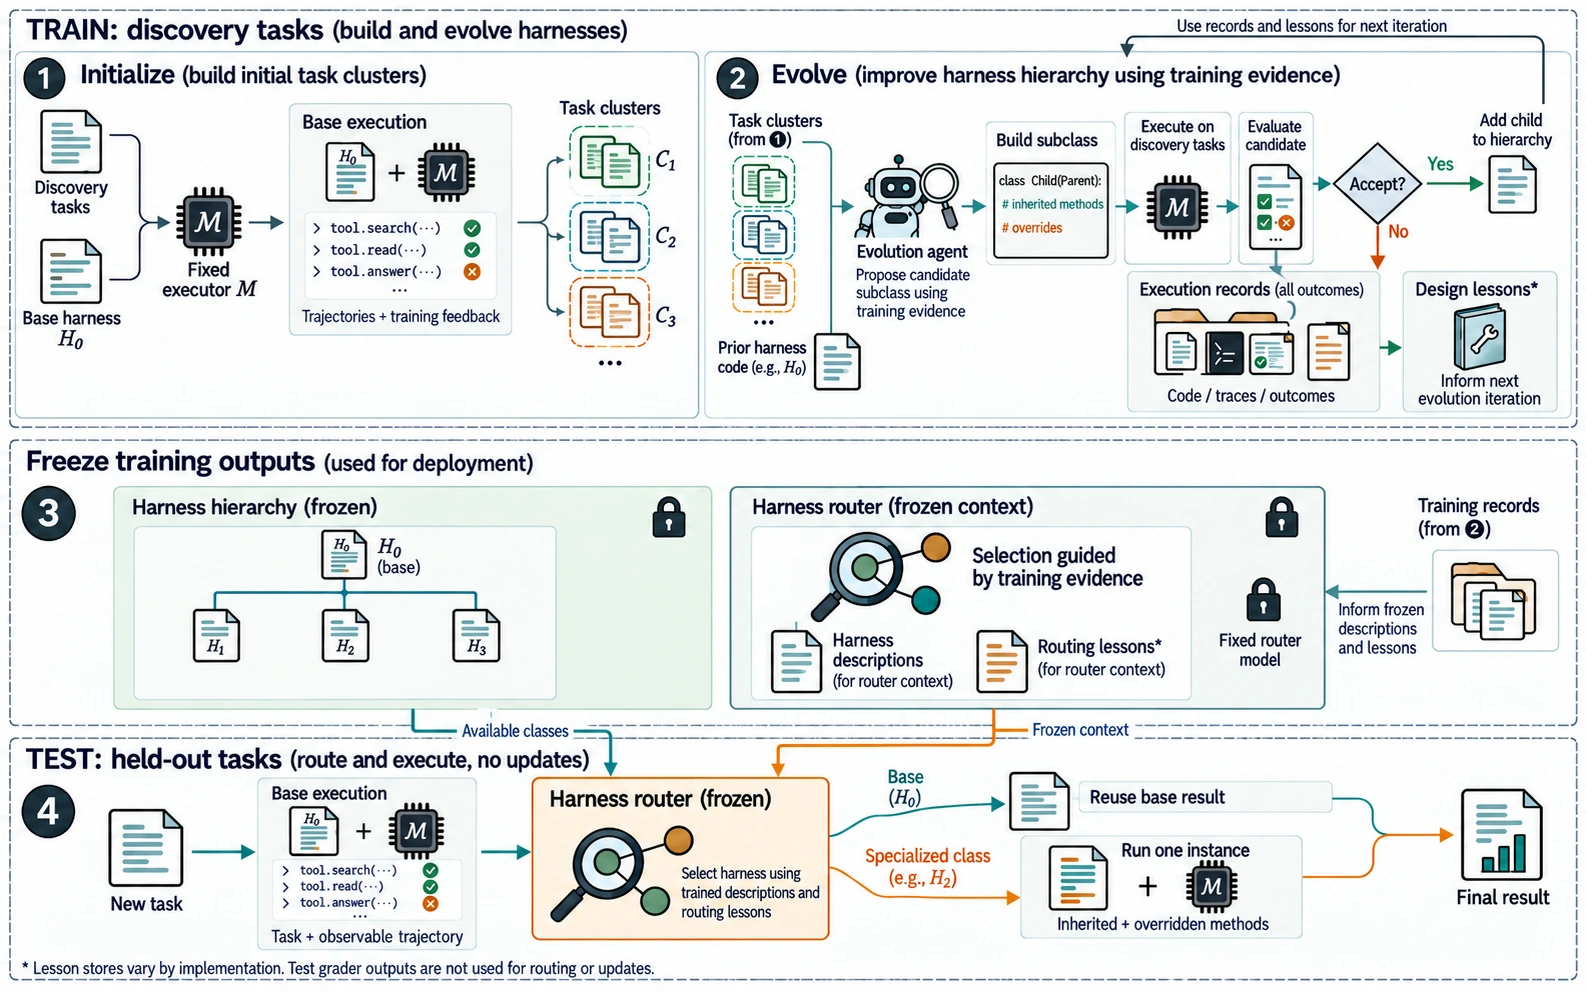
논문 그림 3의 PDF 내장 원본(CC BY 4.0).
위는 코드 진화, 가운데는 결과 고정, 아래는 평가 시 선택과 실행이다.
모바일에서는 그림을 눌러 확대할 수 있다.[4]
평가 시에는 먼저 기본 실행을 본다
새 과제가 들어오면 기본 하네스로 먼저 수행한다.[2]
라우터는 과제 설명, 관찰 가능한 기본 실행의 요약, 고정된 하네스 설명과 라우팅 교훈을 보고 기본 결과를 유지할지 특화 클래스를 실행할지 결정한다.[2]
기본 하네스가 선택되면 이미 얻은 결과를 재사용한다.[2]
특화 하네스가 선택되면 해당 클래스의 인스턴스로 과제를 수행한다.[2]
평가 과제의 정답·채점 점수·판정은 라우터나 executor에 제공하지 않으며, 평가 중에는 계층과 저장된 근거도 갱신하지 않는다.[2]
따라서 이것은 탐색 단계의 채점 피드백으로 코드를 개선하는 방법이지, 테스트 중 정답 없이 계속 하네스를 진화시키는 방법이 아니다.
“평가 시 정답을 안 본다”와 “전체 개발 과정에서 평가 피드백이 없다”는 다른 주장이다.[2]
무엇을 비교했고, 얼마나 개선됐는가
주요 비교에서 executor는 모든 방법에 동일한 gemini-3.5-flash를 사용한다.[2]
하네스 진화는 Claude Opus 4.8로 최대 40회 수행하며, 주요 비교의 OO-Harness 라우터는 Claude Sonnet 5다.[2]
아래 결과는 방법·벤치마크별 세 번의 executor 실행 평균과 표준편차다.[2]
벤치마크별 탐색·평가 분할과 주지표는 서로 다르다.[2]
- AutomationBench: 탐색 300개·평가 300개. 업무 API 작업의 부분 점수 평균인 Mean이 주지표다.[2]
- Workspace-Bench: 탐색 288개·평가 100개인 Lite-100. 문서·스프레드시트 등 산출물의 개별 rubric 통과를 micro-average한 Mean이 주지표다.[2]
- Toolathlon-GYM: 탐색 251개·평가 252개. 여러 도구를 쓰는 과제의 엄격한 성공률인 PASS가 주지표다.[2]
논문 표 1에서 기본 하네스와 OO-Harness의 주지표를 비교하면 다음과 같다.[2]
모두 백분율 단위이며, 차이는 상대 향상률이 아닌 퍼센트포인트다.[2]
- AutomationBench Mean:
61.62 ± 0.15 → 77.41 ± 1.37, 15.79퍼센트포인트 상승.[2] - Workspace-Bench Mean:
25.45 ± 2.98 → 39.48 ± 3.21, 14.03퍼센트포인트 상승.[2] - Toolathlon-GYM PASS:
31.15 ± 0.28 → 37.45 ± 0.98, 6.30퍼센트포인트 상승.[2]
OO-Harness는 비교한 방법 중 세 주지표의 평균이 가장 높다.[2]
다만 Workspace-Bench에서 AAH의 38.62 ± 2.98과 OO-Harness의 39.48 ± 3.21 차이는 작다.[2]
이 표만으로 모든 비교에서 통계적으로 유의한 우위를 입증했다고 읽어서는 안 된다.
또한 Workspace의 Mean은 전체 과제 성공률이 아니다.[2]
OO-Harness가 모든 rubric을 만족한 과제의 비율인 PASS는 8.33 ± 2.52이므로, Mean 39.48을 “약 40%의 과제를 완수했다”로 바꾸면 의미가 달라진다.[2]
제거 실험: 실행 근거와 상속은 각각 무엇을 더하는가
라우팅 제거 실험은 같은 고정 하네스 목록에서 입력 근거를 바꾼다.[2]
과제 설명만 쓰는 라우터보다 기본 실행 궤적도 보는 라우터가 AutomationBench Mean에서 12.64점, Toolathlon-GYM PASS에서 4.37점 높았다.[2]
Workspace-Bench Mean의 차이는 0.53점에 그쳤다.[2]
문서 형식처럼 요청 자체에서 드러나는 요구는 설명만으로도 고르기 쉽다.
반면 필요한 API 쓰기를 하지 않았는지, 오류를 반복했는지는 실행 후에야 드러날 수 있다는 것이 논문의 해석이다.
이 제거 실험은 단일 실행이며, 앞의 세 번 반복한 주요 표와 구별해야 한다.[2]
상속 실험은 Workspace-Bench에서 세 가지 탐색을 각각 수행한 뒤 한 번씩 평가한다.[2]
| 코드 재사용 방식 | rubric 통과율 |
|---|---|
| Base-reset: 이전 변경을 이월하지 않음 | 29.39% |
| Flat: 이전 코드를 복사해 재사용 | 35.60% |
| OO: 이전 클래스를 상속 | 40.56% |
Flat도 코드를 재사용하므로, 결과를 단순히 “재사용이 있어서 좋아졌다”로만 설명하기는 어렵다.
반대로 동일한 완성 코드에서 상속 문법만 바꾼 실험도 아니다.
서로 다른 탐색이 만들어낸 하네스들의 비교라는 범위를 유지해야 한다.[2]
낯선 작업에서는 특화하지 않는 것도 선택이다
별도 OOD 실험은 앱 계열이 겹치지 않는 Toolathlon-GYM 탐색 254개와 Toolathlon 평가 49개를 사용한다.[2]
OO-Harness는 이 평가 과제들에서 전부 기본 하네스를 선택했고, 기본 성능을 보존했다.[2]
학습한 전역 하네스를 적용한 Meta-Harness는 그보다 낮은 PASS를 보였다.[2]
이는 낯선 환경에서 특화 하네스가 새 능력을 발휘했다는 결과가 아니다.
학습한 변경을 강제로 적용하지 않고 기본 동작으로 돌아가는 선택지가 퇴행을 피했다는 결과다.
익숙한 업무에서 배운 최적화가 모든 외부 서비스에도 통할 것이라는 가정과는 거리가 있다.[2]
실무에서 가져올 부분과 남은 경계
논문의 사례는 추상적인 객체지향 비유에 머물지 않는다.
Word 문서 특화 backend는 텍스트를 .docx 확장자로 저장하는 대신 실제 바이너리 문서로 렌더링한다.
또 다른 계보는 쓰기 작업 누락 검사에 종료 예산 근처의 알림과 도구 오류 지침을 차례로 추가한다.
파일 형식이 유효하다는 것과 내용이 과제를 만족한다는 것은 별도로 평가한다.[2]
다만 특화 규칙에는 적용 조건이 필요하다.
스프레드시트 사례의 비율 검사는 과제가 0.2가 아니라 20 같은 퍼센트포인트 값을 기대한다는 가정에 의존한다.[2]
실무에서는 표시 형식과 저장 단위가 다를 수 있으므로, 이런 변환을 범용 교정 규칙으로 적용하기보다 현재 파일의 계약부터 확인해야 한다.
비용 지표도 분리해서 봐야 한다.
논문의 Steps는 최종 선택된 궤적의 평균 길이로, 다른 rollout과 선택 호출을 제외한다.
특화 실행 전의 기본 실행, 라우터, 학습 중 후보 평가까지 포함한 전체 비용이 아니다.
상속이 조상별 실행을 요구하지 않는다는 사실도 전체 파이프라인이 한 번만 추론한다는 뜻은 아니다.[2]
재현성 역시 아직 제한적이다.
2026년 10월 22일 확인한 공식 arXiv 초록·본문에는 OO-Harness 자체의 공개 코드나 전용 프로젝트 링크가 없었고, 본문의 GitHub 링크는 비교 방법·벤치마크 등의 자료를 가리킨다.
따라서 이 글의 결과는 논문 보고치를 검토한 것이며, 공개 패키지로 독립 재현한 결과가 아니다.[1][2]
논문은 서비스 장애·rate limit·인터페이스 변화와 인증·권한 설정을 운영상의 한계로 든다.[2]
실무적으로는 관찰 가능한 실패에 맞는 작은 하네스 변경을 만들고, 변경 이력·적용 조건·기본 동작으로의 복귀 경로를 함께 보존하는 설계가 유용하다.
상속은 코드 정리 수단이지, 잘못된 검사나 외부 API 부작용을 자동으로 안전하게 만드는 장치는 아니다.