에이전트가 파일을 만들고도 다시 열어보지 않거나, 여러 자료의 숫자를 연결하지 못했다면 모델 지식보다 실행 절차가 문제일 수 있다.
Harness²는 이런 실패를 모델 가중치가 아니라 프롬프트·스킬·스크립트·도구 사용법 같은 하네스의 변경으로 개선하는 프레임워크다.[2]
2026년 10월 9일 공개된 Harness^2: Recursive Agent Harnessing for an Open World는 Ruiyao Xu와 Yanfei Chen 등 연구진의 논문이다.[1]
공식 프로젝트 페이지는 Ruiyao Xu를 Northwestern University, 나머지 저자들을 Google Cloud AI Research 소속으로 표시한다.[3]
핵심은 한 작업의 하네스를 고치는 데서 그치지 않고, 그 하네스를 어떻게 고쳤는지에 관한 경험을 다음 개선에도 쓰는 두 수준의 재귀다.[2]
두 재귀는 서로 다른 것을 바꾼다
작업 수준 재귀는 현재 과제를 수행하는 실행 하네스를 수정한다.[2]
하네싱 수준 재귀는 작업이 끝난 뒤 채택된 하네스와 경험을 라이브러리에 저장해, 이후 작업의 개선 과정을 안내한다.[2]
모델 가중치는 고정되며, 작업 중에는 개선 하네스도 고정된 상태다.[2]
여기서 “개선 절차도 진화한다”는 말은 editor의 모든 알고리즘이나 프롬프트를 계속 다시 쓴다는 뜻은 아니다.[2]
논문에서는 단계별 지시와 결정 규칙은 유지하고, 실행 가능한 하네스와 EXPERIENCE.md가 쌓이는 라이브러리를 갱신한다.[2]
또한 다음 작업은 이전 작업의 최종 하네스를 통째로 물려받지 않고 공통 초기 하네스에서 다시 시작하며, 과거의 관련 구성요소를 선택적으로 재사용한다.[2]
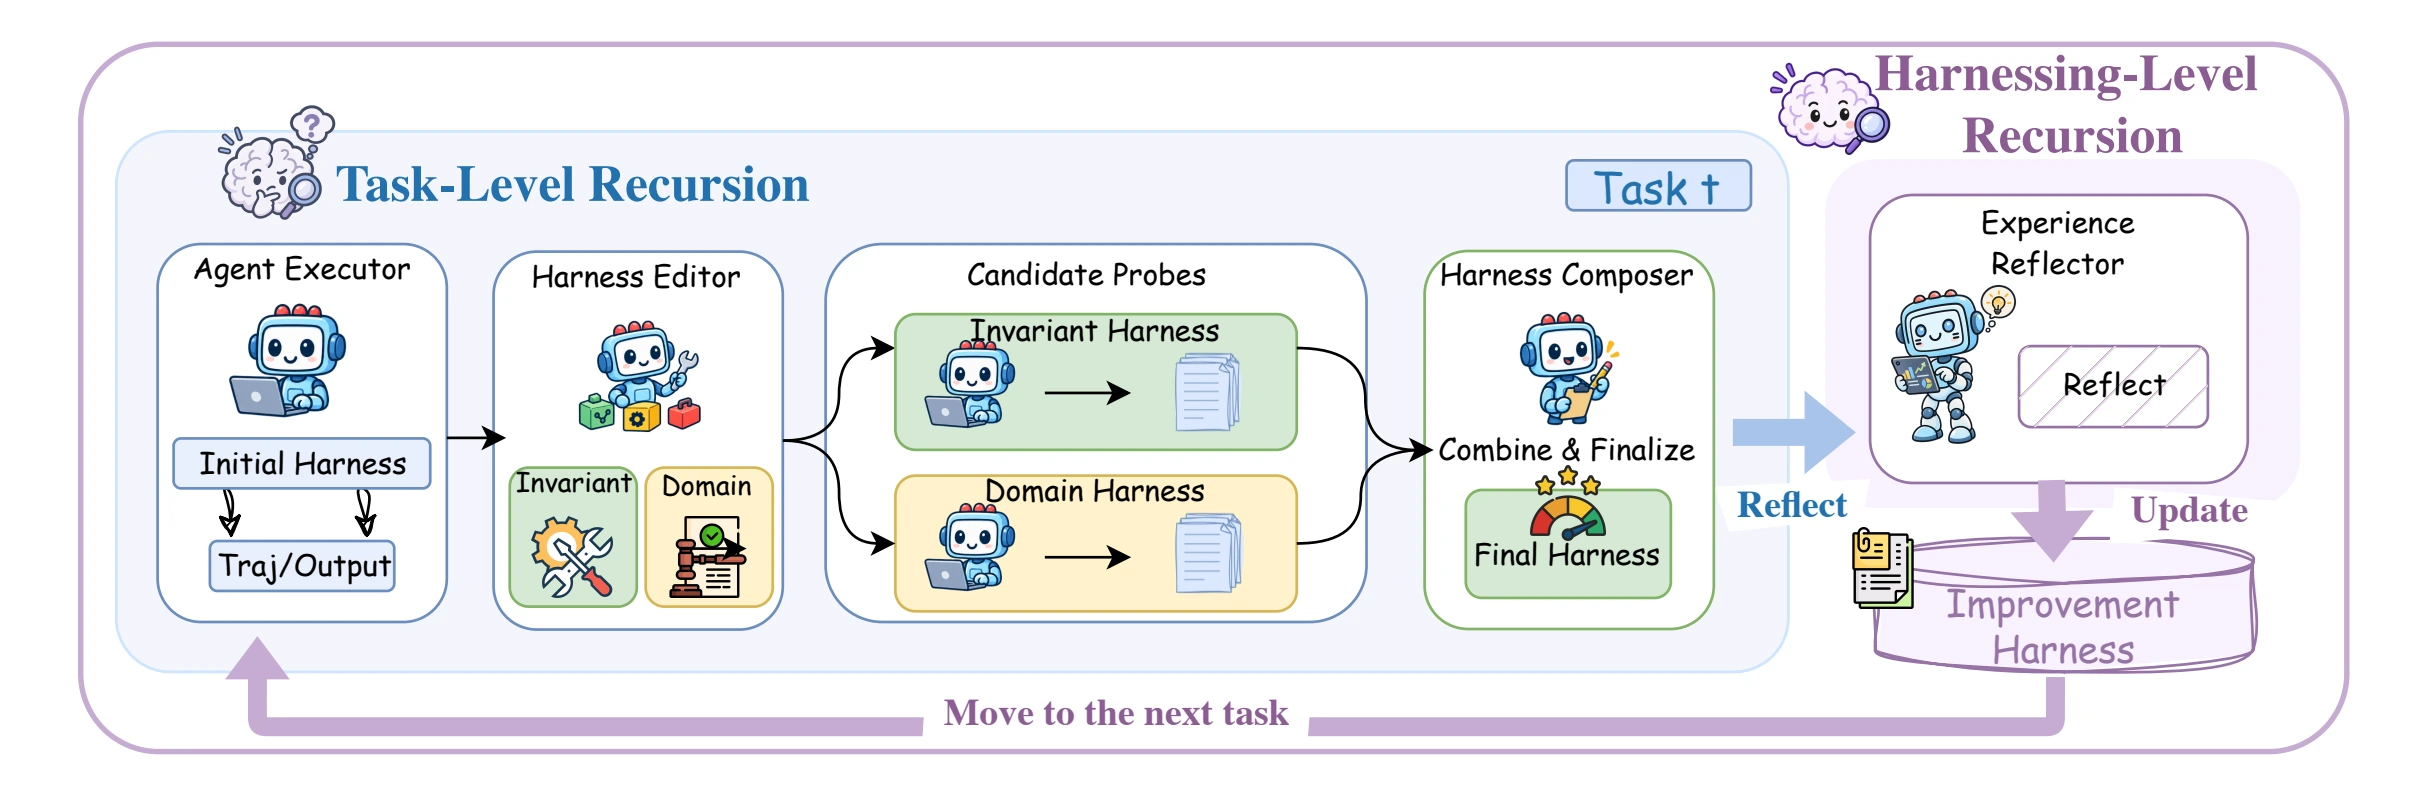
논문 그림 3에 대응하는 공식 고해상도 이미지.
왼쪽은 현재 작업의 개선, 오른쪽은 다음 개선을 위한 경험 축적이다.
원본 영문 표기는 유지했다.
모바일에서는 좌우로 밀거나 눌러 확대할 수 있다.[2][4]
정답 없이 무엇을 비교하는가: Propose–Probe–Compose
일반적인 하네스 탐색은 정답·테스트·검증 점수를 보고 후보를 고르기 쉽다.
하지만 새로운 실무 과제에서는 그런 신호가 없을 수 있다.
Harness²는 같은 과제에서 실행을 대조해, 변경이 관찰된 약점을 실제로 줄였는지 살펴본다.[2]
- Propose: 초기 실행의 궤적과 산출물을 읽고 두 방향의 후보를 만든다. invariant 후보는 계획·도구·검증 같은 일반 절차를, domain 후보는 현재 분야의 지식·관행·제약을 겨냥한다.[2]
- Probe: 같은 모델·환경 설정에서 각 후보 하네스로 과제를 다시 수행한다. 초기 실행과 비교해 목표한 행동이 달라졌는지, 그대로인지, 새로운 문제가 생겼는지 확인한다.[2]
- Compose: 후보 파일과 diff, 실행 근거를 보고 후속 하네스를 만든다. 단순 병합뿐 아니라 충돌 수정·후보 하나 채택·기존 하네스 유지가 가능하며, 합성된 하네스도 다시 실행한다.[2]
중요한 한계는 행동의 대조가 정답 검증을 대신하지는 않는다는 점이다.[2]
여러 실행이 같은 오류를 반복하거나 editor가 잘못 판단할 수 있으며, 채택된 결과도 검증된 최적해라는 의미는 아니다.[2]
k > 1의 최종 selector는 출처 하네스를 가린 산출물 중 하나를 고를 뿐 새 답을 합성하지 않고, k = 1에서는 이 선택 단계를 건너뛴다.[2]
무엇을 편집하고, 재귀를 어떻게 늘리는가
편집 대상은 시스템 프롬프트, guardrails, memory, tool guidance, subagents, skills, scripts, plugins의 여덟 구성요소다.[2]
상시 문구를 늘리는 것과 필요할 때만 읽는 스킬을 추가하는 것, 도구 루프에 plugin을 넣는 것은 적용 시점과 비용이 다르다.[2]
따라서 단순히 “더 주의하라”는 프롬프트를 길게 쓰기보다 관찰된 문제에 맞는 변경 위치를 고르는 것이 설계의 일부다.[2]
예산 k에는 두 사용 방식이 있다.[2]
병렬 재귀는 범용·분야별 후보를 각각 k개 만들고 공유된 실행 근거에서 k개의 합성안을 구성한다.
현재 구현에서는 깊이를 늘리는 것이 아니라 한 번의 population update의 폭을 늘린다.[2]
순차 재귀는 수정된 하네스와 누적 근거를 다음 Propose–Probe–Compose 단계로 전달해 k번 이어간다.[2]
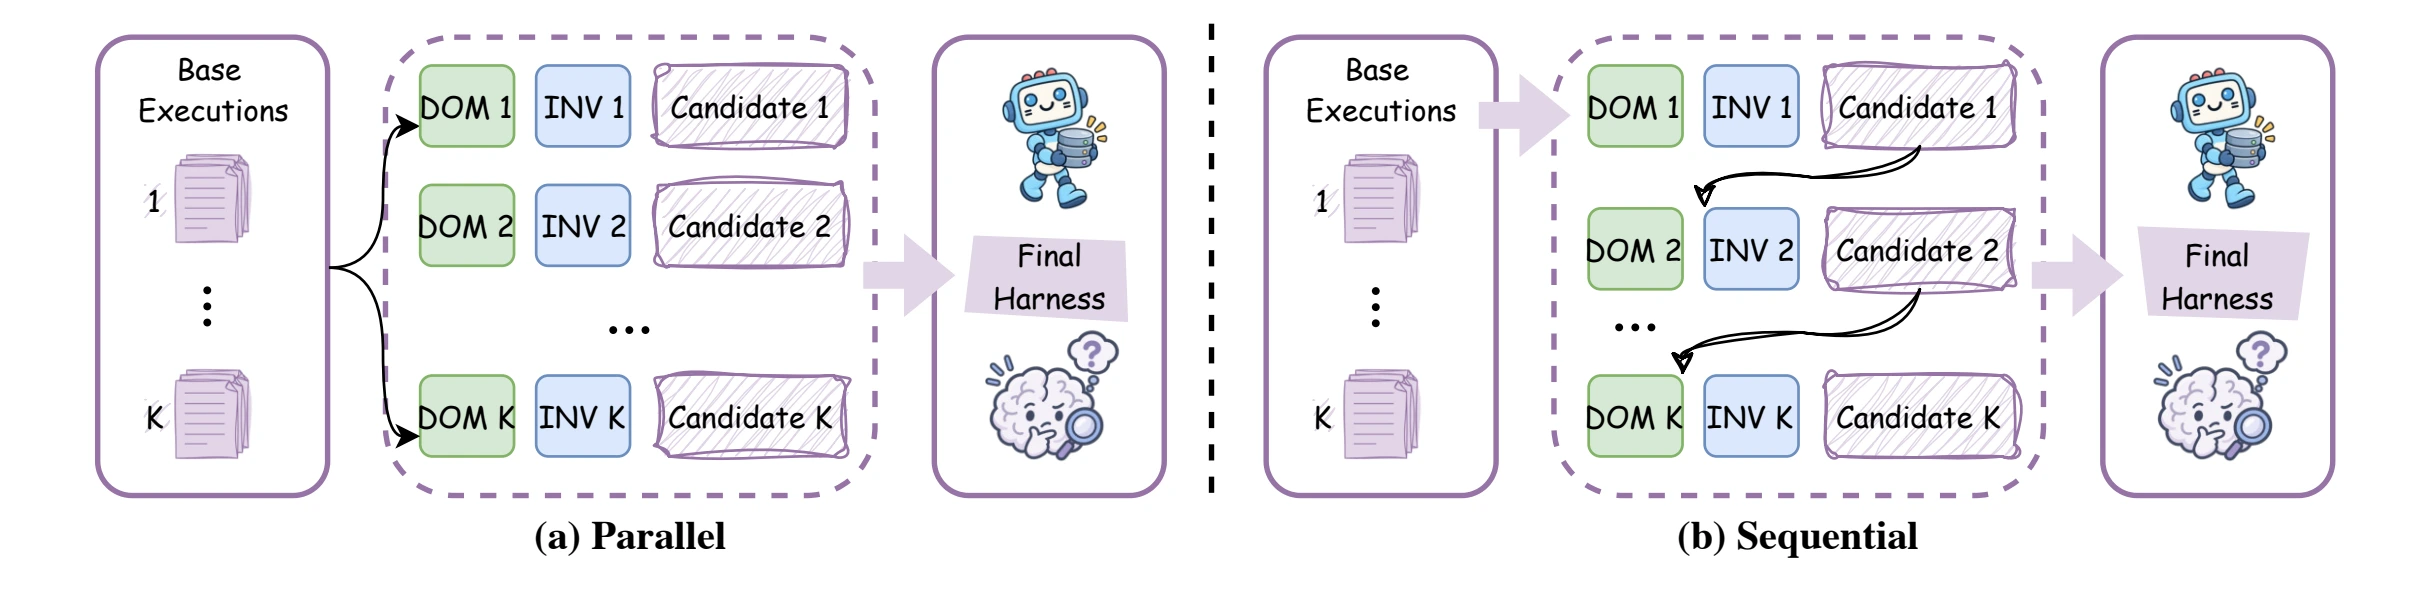
논문 그림 4에 대응하는 공식 이미지. k는 두 모드에서 다른 구조를 제어하므로, 단순히 같은 횟수의 답변 재시도로 해석하면 안 된다.
모바일에서는 좌우로 밀거나 눌러 확대할 수 있다.[2][4]
작업 후에는 채택된 실행 가능한 구성요소와 그 적용 상황·교훈·근거를 라이브러리에 남긴다.[2]
근거가 충분하지 않으면 새 경험 항목을 추가하지 않으며, 과거 작업의 파일 매핑이나 임계값을 재사용할 때도 현재 자료에서 다시 확인하도록 한다.[2]
“성공한 답을 기억한다”보다 어떤 수정이 어떤 조건에서 도움이 됐는지를 보존한다는 접근에 가깝다.[2]
평가 설계: 개선 중 정답을 안 보는 것과 평가자가 없는 것은 다르다
실험은 Gemini 3.5 Flash·GLM-5와 OpenCode·Codex를 조합한 네 설정을 사용한다.[2]
기본 editor와 selector는 OpenCode에서 실행되는 Claude Opus 4.8이며, 모델을 같게 쓰는 추가 실험은 별도로 제시한다.[2]
주요 표는 과제 순서를 섞은 세 번의 stream 평균과 표준편차를 보고한다.[2]
평가 대상도 전체 공개 데이터셋과 구분해야 한다.
논문 부록의 범위는 다음과 같다.[2]
- WorkBuddy-Bench: Code 40개, Web 35개, Office 25개의 test 과제를 사용하고 세 분야를 macro-average한다. 결정론적 검사와 모델 judge가 섞인 복합 검증이다.[2]
- JobBench: 고정한 test 34개 과제를 사용하며 Claude Opus 4.8이 가중 rubric으로 평가한다.[2]
- LAB: held-out 100개 법률 과제를 Claude Sonnet 4.6으로 채점한다. 주요 지표인 Partial은 기준별 통과율이지 모든 기준을 만족한 과제의 비율이 아니다.[2]
개선 파이프라인은 이 점수·rubric을 받지 않지만, 성능 측정을 위한 외부 평가자는 존재한다.[2]
또한 library는 benchmark·domain별로 이전 과제에서 얻은 경험을 쓰므로, 모든 test 과제가 서로 독립적인 cold start인 실험은 아니다.[2][6]
결과와 제거 실험에서 확인되는 점
한 번의 대조 개선은 모든 모델–하네스 조합에서 base보다 좋아졌다.[2]
다만 초록의 “최대 개선”은 서로 다른 benchmark와 설정에서 나온 수치이므로 하나의 조건처럼 묶으면 안 된다.[2]
- WorkBuddy, GLM-5 + OpenCode: 평균 64.2에서 75.7로 상승했다. 이 조건이 주요 표의 최대 11.5점 개선에 해당한다.[2]
- JobBench, Gemini 3.5 Flash + OpenCode: 31.5에서 36.0으로 올라 4.5점 개선을 보였다.[2]
- LAB, GLM-5 + OpenCode: Partial 59.6에서 71.4로 상승했다. 이는 11.8퍼센트포인트 개선이다.[2]
항상 모든 경쟁 방법보다 높은 것은 아니다.[2]
LAB의 Gemini 3.5 Flash + Codex 조건에서는 한 단계 Harness²의 Partial 75.6보다 Meta-Harness의 76.5가 높다.[2]
병렬 k = 5는 추가 이득을 주지만, 실행 횟수와 editor 세션 비용도 함께 늘어난다.[2]
제거 실험은 Gemini 3.5 Flash + OpenCode, k = 1 조건이다.
아래는 표 3의 WorkBuddy 평균과 JobBench 점수를 함께 읽은 것이다.[2]
| 구성 | WorkBuddy / JobBench |
|---|---|
| 전체 Harness² | 77.5 / 36.0 |
| 라이브러리 제거 | 74.4 / 34.2 |
| 범용·분야 역할 구분 제거 | 74.6 / 32.3 |
| 합성 제거 | 75.9 / 34.1 |
이 결과는 경험 라이브러리, 역할 구분, 합성이 각각 기여함을 보여주지만 효과 크기를 서로 독립적인 값처럼 더할 수는 없다.[2]
추가 library 재사용 분석 중 자신의 항목을 뺀 뒤 다른 과제 경험을 쓰는 retrospective 실험은 나중 과제의 경험도 포함하므로, 온라인 적응 결과와 구별해야 한다.[2]
비용과 공개 구현에서 특히 주의할 점
표의 #Steps는 executor 세션의 모델 turn 수다.[2]
이 숫자가 줄었다고 전체 개선 비용이 줄었다는 뜻은 아니며, 논문의 compute 비교는 최종 제출 전 executor와 개선 과정에서 쓴 토큰을 함께 센다.[2]
병렬화는 동시 자원이 있을 때 지연을 줄일 수 있지만 총 추론량을 없애지는 않는다.[2]
공개 저장소는 Linux·Python 3.12·uv 중심이며, package 명세는 Python 3.12와 3.13을 허용한다.[7][9]
모델 API 접근·인증, benchmark별 의존성, WorkBuddy의 Docker가 필요하고, 단순 readiness check가 모델 사용 가능성까지 보장하지는 않는다.[5][9]
실제 모델 호출은 비용이 발생하므로, 설치와 task 선택을 --dry-run으로 확인하고 작은 범위에서 시작하는 편이 낫다.[6][9]
더 중요한 것은 평가 정보 유출 가능성이다.[6]
공개 실험 가이드는 release 검증 과정에서 Codex가 지시 없이 JobBench의 공개 rubric을 내려받은 사례를 기록하고, 패키지 자체는 네트워크 접근을 차단하지 않는다고 설명한다.[6]
이는 논문 실험의 오염을 입증하는 사실은 아니지만, 공개 코드로 독립 재현할 때 “rubric을 프롬프트에 넣지 않았다”는 조건만으로 충분하지 않음을 보여준다.[2][6]
가이드는 setup 후 benchmark·rubric 배포 호스트에 대한 executor 접근을 네트워크 수준에서 제한하고, 적용한 정책을 결과와 함께 보고하도록 권한다.[6]
Codex는 sandbox가 꺼진 상태로 실행되며, 컨테이너 연결을 위해 bridge를 0.0.0.0에 bind하는 경로도 있으므로 별도 접근 통제가 필요하다.[9]
또한 논문의 고정 test split과 공개 runner가 기본 탐색하는 전체 과제 집합·judge 설정이 같다고 가정해서는 안 된다.[2][5]
프레임워크 자체는 Apache-2.0이지만 benchmark·데이터·외부 코드는 각자의 라이선스를 유지한다.[4][8]
특히 WorkBuddy-Bench에는 별도 지역 제한이 있다고 공식 benchmark 가이드가 경고하며, 저장소는 공식 지원 Google 제품이 아니라고 명시한다.[4][5]
실무 관점에서의 해석
Harness²의 기여는 모델이 스스로 정답을 보증한다는 데 있지 않다.
실행을 대조해 현재 하네스를 바꾸고, 그 수정 경험을 다음 개선에 재사용하는 구조를 분리했다는 데 있다.
단순 메모 검색이나 최종 답변 재시도와는 다른 개선 단위를 제안한다.[2]
실무에 적용한다면 작은 실패부터 범용 절차·분야 지식 중 어디가 원인인지 나누고, 하네스 diff와 실행 근거를 함께 보존하는 방식이 유용하다.
다만 업무 안전성·외부 권한·비용 상한·정답 평가는 모델의 자기 판단 바깥에 둬야 한다.
라이브러리가 늘수록 중복·오래된 교훈을 정리하는 문제와 작업별 재귀 예산의 자동 조절은 논문에서도 후속 과제로 남아 있다.[2]