긴 video에서 3D를 복원할 때 가장 비싼 선택은 “과거 프레임을 전부 기억하자”일 수 있다.[2]
frame 수가 늘면 attention state, KV cache, 누적 drift가 같이 커지고, offline multi-view model처럼 전체 장면을 한 번에 볼 수도 없다.[2]
반대로 state를 너무 작게 줄이면 초반의 좌표·scale 기준을 잃고, 멀리 돌아온 위치를 다시 맞추기 어려워진다.[2]
Geometric Context Transformer for Streaming 3D Reconstruction은 이 균형을 **Geometric Context Attention (GCA)**으로 다룬다.
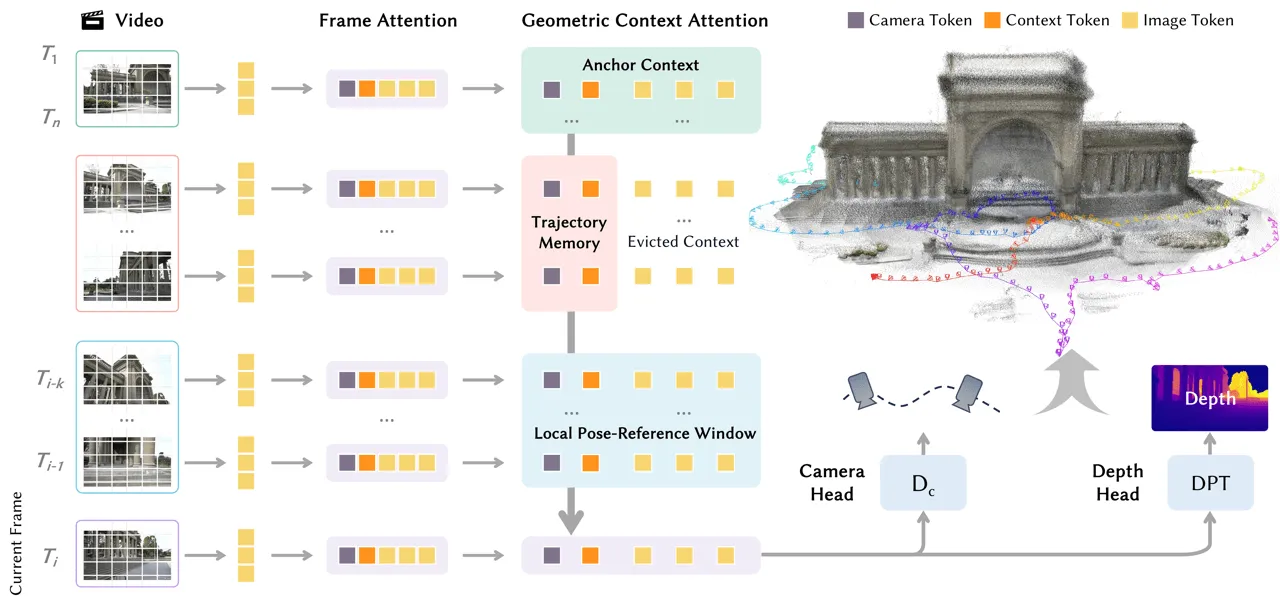
LingBot-Map은 현재 frame과 과거 관측만 사용해 frame별 camera pose와 depth map을 예측하는 feed-forward streaming model이며, 전체 history를 하나의 무거운 cache로 만들기보다 anchor context, local pose-reference window, trajectory memory라는 세 종류의 state를 나눠 둔다.[1][2]
프로젝트는 논문만 공개한 상태가 아니다.
공식 project page와 Apache-2.0 GitHub repository가 공개돼 있다.[3][4]
Hugging Face checkpoint와 평가 pipeline도 공개돼 있다.[5][6]
다만 이 글의 수치는 모두 저자들이 정한 dataset·hardware·inference protocol에서의 보고값이며, production SLAM의 독립 검증 결과와 같지는 않다.[2][5]
streaming 3D의 병목은 모델 크기보다 “무엇을 남길지”다
최근 feed-forward 3D model은 unposed multi-view image에서 pose, depth, point map을 빠르게 예측할 수 있다.[2]
그러나 많은 접근은 full image set을 global하게 처리하는 offline setting을 전제한다.[2] streaming setting에서는 미래 frame을 볼 수 없고, 새 frame을 처리할 때마다 local detail, global coordinate grounding, long-range consistency를 동시에 관리해야 한다.[2]
LingBot-Map의 framing은 SLAM의 고전적인 기능을 그대로 복사하는 방식은 아니다. bundle adjustment나 explicit loop closure를 넣기보다, 세 종류의 geometric role을 learned attention state로 옮긴다.[2]
| GCA context | 남기는 정보 | 실무적으로 막으려는 실패 |
|---|---|---|
| Anchor context | 처음/기준 frame의 coordinate·scale grounding | 경로가 길어질수록 global frame이 흔들리는 문제 |
| Pose-reference window | 최근 reference frame 주변의 dense geometry | 가까운 view에서 pose와 depth가 불안정해지는 문제 |
| Trajectory memory | 지나온 경로의 compact per-frame token | 멀리 이동하거나 재방문했을 때 누적 drift가 커지는 문제 |
이 분리는 “작은 memory” 자체가 목적이라는 뜻은 아니다. anchor는 scale과 기준 좌표를, pose-reference window는 local geometric cue를, trajectory memory는 긴 경로의 correction signal을 보존하게 하려는 inductive bias다.[2]
현재 view는 이 세 context에 attention을 걸고, task head가 pose와 depth를 낸다.[2][3]
핵심 구조: current frame에 세 종류의 과거를 다르게 붙인다
입력은 시간순 image stream I₁, I₂, …이다.
LingBot-Map은 새 frame Iₜ가 도착할 때마다 future observation 없이 P̂ₜ와 D̂ₜ를 예측한다.[2] backbone은 DINOv2 ViT로 초기화하고, 24개 block에서 frame attention과 cross-frame/GCA 계열 attention을 번갈아 사용한다.[2]
- Anchor context는 streaming sequence의 coordinate와 scale reference다. 논문은 monocular 입력의 metric ambiguity와 long trajectory의 reference loss를 이 context가 다루도록 설계한다.[2]
- Pose-reference window는 현재 view에 가까운 reference frames를 유지해 local matching과 dense geometry cue를 제공한다. 전체 과거보다 근처 view가 pose refinement에 더 직접적인 경우를 담당한다.[2]
- Trajectory memory는 전체 history를 compact token 형태로 요약한다. local window 밖의 long-range frame이 가진 drift correction 단서를 다시 꺼내는 역할이다.[2]
이 세 상태를 분리한 덕분에 저자들은 test-time training, post-optimization, explicit loop closure 없이 pure feed-forward path를 내세운다.[1][2]
이것이 기존 SLAM을 대체한다는 보편적 결론은 아니다.
이 논문의 더 좁고 정확한 주장은, streaming reconstruction에서 필요한 context 역할을 neural state에 분해하면 긴 sequence에서도 안정적인 pose/depth 추정이 가능하다는 것이다.[2]
결과는 무엇을 보여 주나: dense trajectory에서 error 증가를 작게 만든다
Oxford Spires sparse setting(320 frames, 12-frame stride)에서 LingBot-Map은 AUC@15 61.64, ATE 6.42를 보고한다.
같은 표에서 offline DA3는 49.84 / 12.87, online CUT3R은 5.98 / 18.16이다.[2]
이 수치는 동일 protocol 아래의 결과라서, “offline보다 항상 우월하다”보다 이 large-scale trajectory benchmark의 이 setting에서 streaming 방식이 강하게 나왔다는 의미로 읽는 편이 맞다.
더 중요한 표는 full 3,840-frame dense setting이다.
저자들이 보고한 LingBot-Map의 ATE는 sparse 6.42에서 dense 7.11로 +0.69 증가했다.
비교 대상 CUT3R은 18.16→32.47, Wint3R은 21.10→32.90으로 증가한다.[2]
| Oxford Spires | Sparse ATE ↓ | Dense ATE ↓ | Dense−Sparse | FPS ↑ |
|---|---|---|---|---|
| CUT3R | 18.16 | 32.47 | +14.31 | 29.21 |
| TTT3R | 19.35 | 25.05 | +5.70 | 28.97 |
| Wint3R | 21.10 | 32.90 | +11.80 | 3.88 |
| InfiniteVGGT | 30.49 | 31.75 | +1.26 | 7.78 |
| LingBot-Map | 6.42 | 7.11 | +0.69 | 20.29 |
표의 trade-off도 함께 봐야 한다.[2]
LingBot-Map은 가장 높은 FPS를 주장하지 않는다.[2]
해당 dense test에서 CUT3R·TTT3R은 약 29 FPS이고 LingBot-Map은 20.29 FPS다.[2]
대신 저자들은 accuracy degradation을 훨씬 작게 만드는 쪽을 핵심 결과로 제시한다.[2]
다른 benchmark도 논문 내부에서는 좋은 결과를 보고한다.[2]
Tanks and Temples에서 AUC@30 92.80/ATE 0.20, ETH3D에서 ATE 0.22, 7-Scenes에서 ATE 0.08이 보고된다.[2]
하지만 서로 다른 dataset의 scene scale, trajectory, ground truth, baseline pre/post-processing을 모두 무시한 채 이 숫자를 일반적인 “3D reconstruction 1위”로 합치면 안 된다.[2]
속도와 memory: paged KV cache는 모델의 일부가 아니라 실행 경로의 일부다
논문과 official project page는 518×378, 최대 1,000-frame sequence, 64-frame sliding window에서 FlashInfer paged KV-cache path가 약 20 FPS이고, contiguous KV-cache를 쓰는 동일 PyTorch baseline은 약 10.5 FPS라고 적는다.[2][3]
즉 3D architecture만이 아니라 cache update 방식이 practical throughput의 절반 가까이를 좌우한다는 뜻이다.
공개 implementation은 길이가 학습 중 max view를 넘으면 keyframe 간격을 둬 cache에 보관하는 frame 수를 조절한다.[2][4]
README는 --keyframe_interval이 non-keyframe의 prediction은 유지하되 KV cache 저장을 줄인다고 설명하고, 기본 streaming mode에서 state reset은 하지 않으므로 training에서 본 최대 거리보다 멀어지면 pose collapse가 나타날 수 있다고 명시한다.[4]
따라서 “10,000+ frame에서 near-constant memory”라는 project-level 메시지는 조건부로 읽어야 한다.
공식 page는 10,000 frame 이상 long sequence와 약 20 FPS를 소개하지만,[3] repo는 3,000 frame 이상에서는 windowed inference, keyframe interval, overlap을 안내하고, input distribution을 크게 벗어난 상황에서는 reset/windowed mode가 필요할 수 있다고 밝힌다.[4]
이는 논문의 장점을 깎는 caveat가 아니라, 학술적인 long-sequence claim을 실제 runtime policy로 번역할 때 필요한 운영 조건이다.
공개 범위: code·weight·benchmark는 있으나, 재현 비용도 함께 공개돼 있다
공개 surface는 비교적 넓다.
GitHub repository는 demo, benchmark, preprocessing, offline render pipeline을 포함하고 Apache-2.0 license를 명시한다.[4]
Hugging Face에는 balanced lingbot-map checkpoint와 stage-1 checkpoint가 있으며, repository의 quick start는 model path와 image folder를 받아 browser-based viewer를 여는 demo.py 예시를 제공한다.[4][6]
평가도 “table만 있는” 상태는 아니다. benchmark/ 문서는 Oxford Spires, ETH3D, 7-Scenes, Tanks and Temples, KITTI, DROID-W 등 adapter와 config를 공개하고, prepare.py → run.py → evaluate.py 순서를 설명한다.[5]
이 점은 논문 수치를 직접 재현하거나, 최소한 자기 dataset에 같은 reporting surface를 얹는 출발점이 된다.
다만 바로 production SLAM stack으로 넣을 때는 몇 가지를 분리해 검증해야 한다.
- 모델의 paper result는 정해진 resolution, GPU, dataset preparation, evaluator에 묶여 있다.[2][5]
- demo를 위한 dependency는 Python 3.10, CUDA 12.8 계열 PyTorch 및 FlashInfer 권장 path를 전제로 한다.[4]
- 3D reconstruction output은 pose/depth/point cloud estimate이지, safety-critical navigation에서 검증된 metric map이나 loop-closure guarantee는 아니다.[2][4]
- 공개 checkpoint의 Apache-2.0 code license와 별개로, 실서비스 적용 전에는 model card와 다운로드 artifact의 최신 terms를 다시 확인하는 편이 안전하다.[4][6]
실무적으로 남는 질문
LingBot-Map에서 가장 흥미로운 점은 “더 긴 context”를 한 덩어리로 키우지 않은 것이다. anchor, local pose reference, long trajectory signal을 따로 다루면, 장면 전체를 매번 다시 최적화하지 않아도 streaming model이 어떤 기하 정보를 잃으면 안 되는지를 명시할 수 있다.[2]
이 아이디어는 3D foundation model을 robot, AR navigation, long walkthrough indexing에 붙일 때 특히 유용하다.
다음 frame의 pose만 정확히 내는 것보다, 어떤 state가 global reference인지, 어떤 state가 local geometry인지, 어떤 state가 long-range drift detector인지 분리해 observability와 recovery policy를 설계할 수 있기 때문이다.
다만 실제 도입의 검증 기준은 논문 headline이 아니라, 자기 camera·scene·sequence length에서 dense error가 어떻게 증가하는지와 keyframe/window policy가 무엇을 잃는지여야 한다.[2][4][5]