연구 아이디어를 만드는 AI가 좋아졌는지 알려면, 그 아이디어가 기존 연구와 얼마나 다른지 평가해야 한다.
Ai2가 공개한 Novelty Judge Bench와 연구 Old Ideas, Novel Problems는 이 판단을 맡은 LLM 평가기 자체가 얼마나 안정적인지 묻는다.[1][2]
아이디어 생성기보다 평가기의 설정이 결과를 크게 바꾼다면, “더 독창적인 아이디어를 만들었다”는 주장도 다시 살펴봐야 한다.
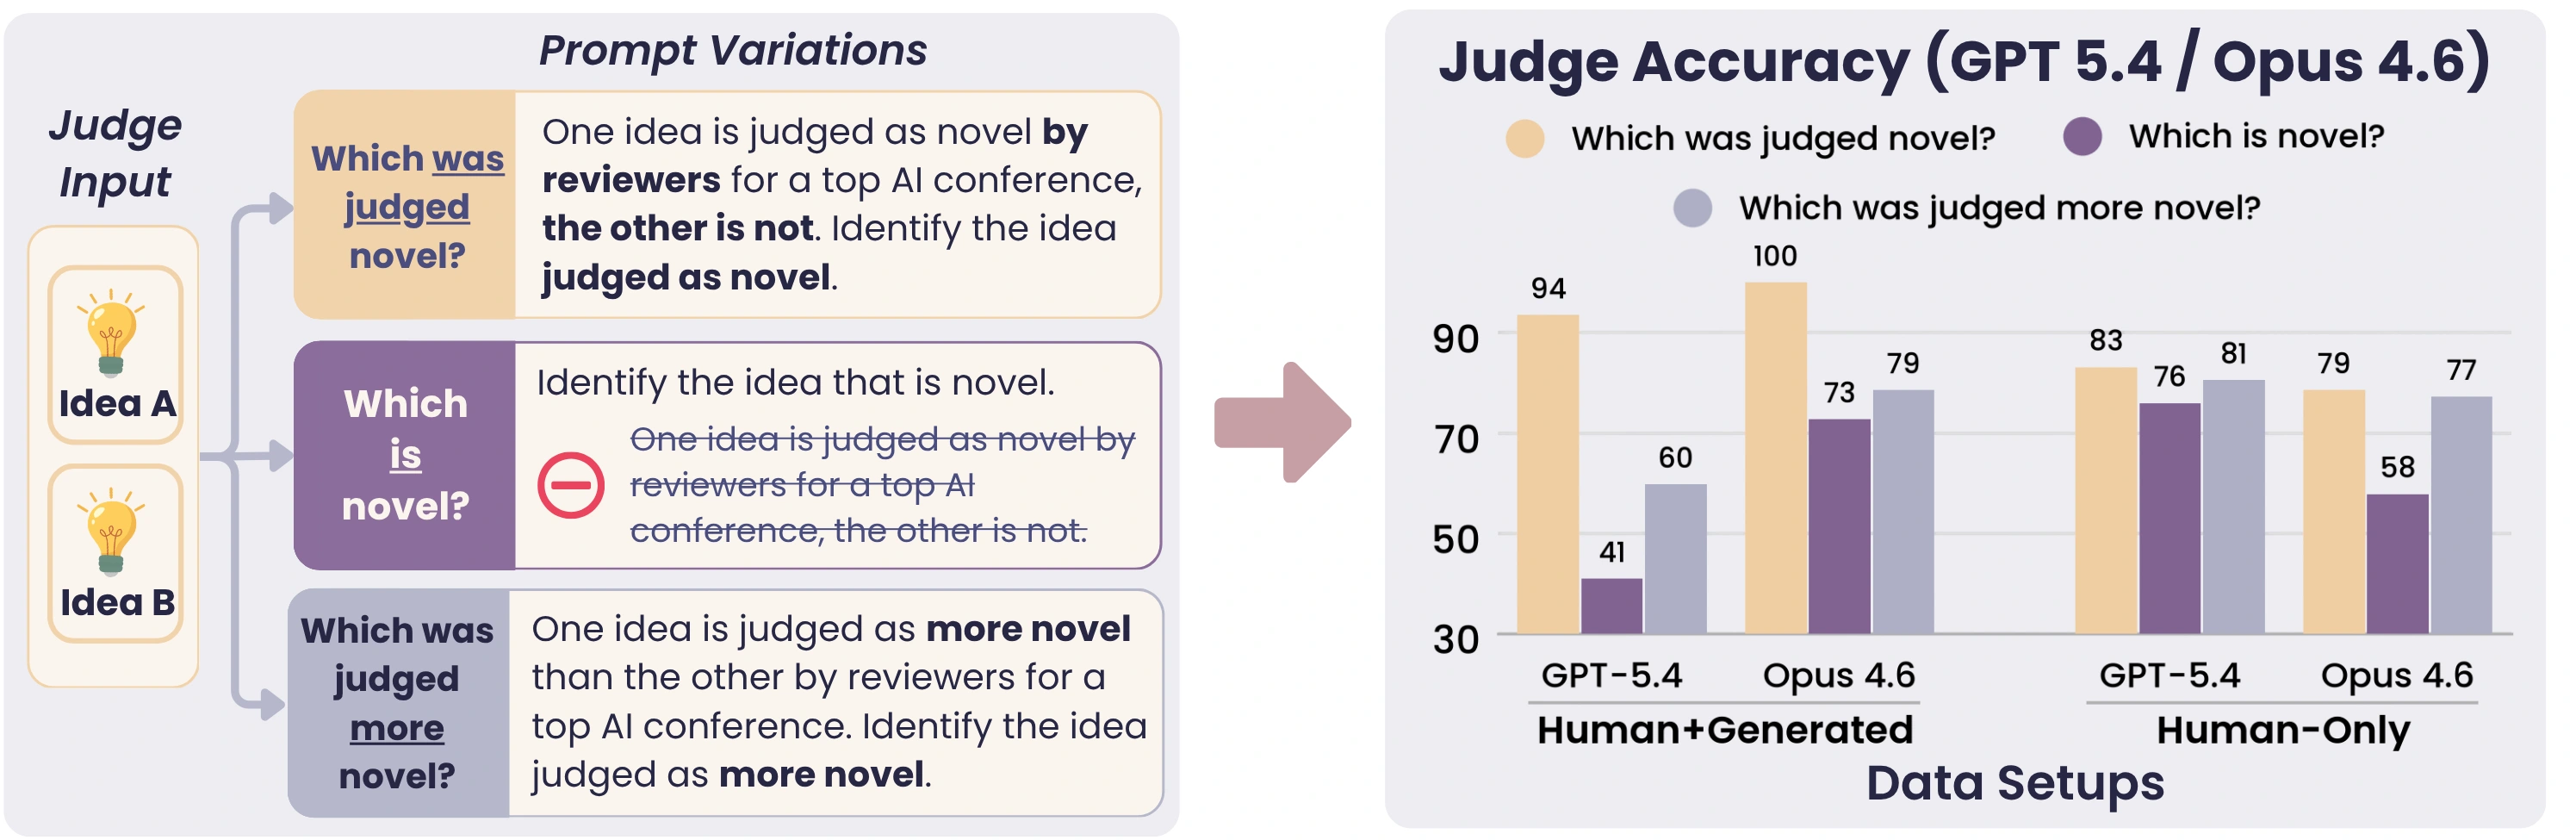
대표적인 결과는 GPT-5.4의 쌍별 판정 정확도가 93.5%에서 40.9%로 달라진 사례다.[1]
같은 아이디어 쌍을 보여 주면서, 리뷰어의 사전 판단을 언급하는 문장을 빼자 52.6%포인트 차이가 났다.[3]
중요한 것은 이 수치만으로 모든 신규성 평가를 부정하는 것이 아니라, 어떤 데이터와 프롬프트에서 이런 변화가 나타났는지 확인하는 일이다.
채택 여부가 아니라 리뷰 속 신규성 신호를 모은다
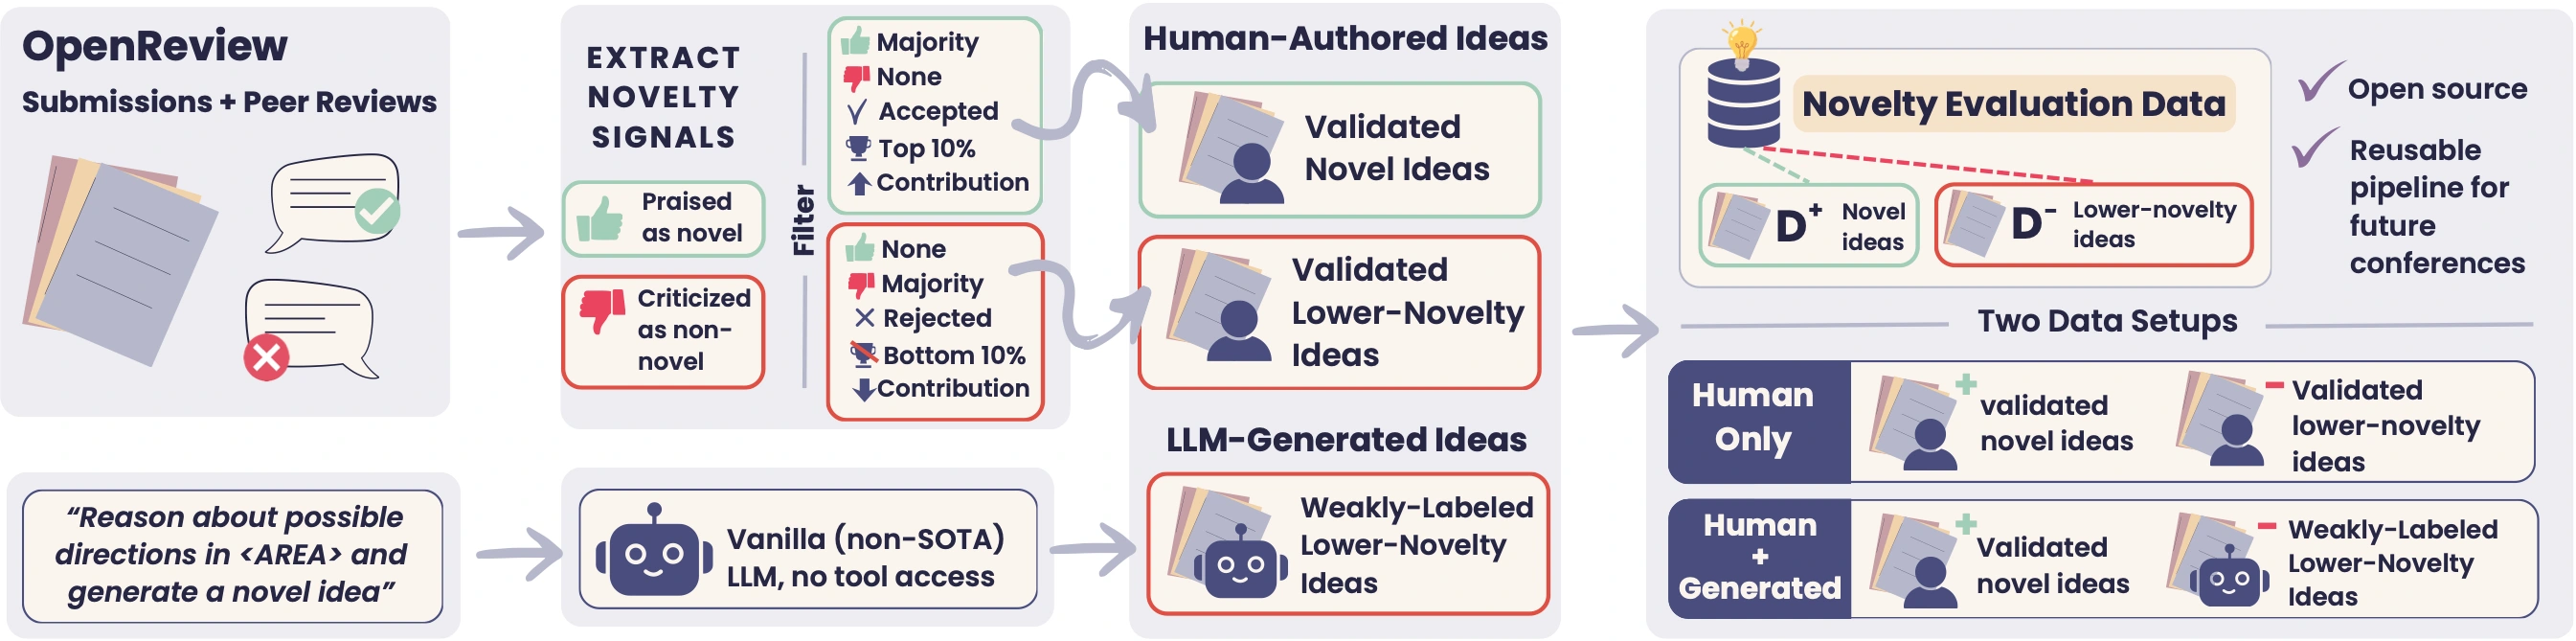
이 벤치마크는 ICLR 2026 논문이 채택됐다는 이유만으로 신규하다고 보지 않는다.[3]
리뷰의 장점·단점 서술에서 기여의 독창성을 직접 인정하거나 부정하는 문장을 Claude Opus 4.6으로 추출한 뒤, 리뷰 신호와 점수·채택 조건을 함께 적용한다.[4]
연구의 완성도와 신규성을 최대한 분리하려는 설계다.
높은 신규성 풀은 154개다.[3]
해당 연구 분야의 평점 상위 10%에 속하는 채택 논문 중, 리뷰어 다수가 신규성을 칭찬하고 누구도 부정하지 않은 논문을 고른다.[3]
낮은 신규성 풀 145개는 반대로 하위 10%의 거절 논문 중, 다수가 독창성을 문제 삼고 누구도 칭찬하지 않은 논문이다.[3]
부록에는 기여 점수와 평점의 추가 문턱도 명시돼 있다.[4]
평가기에게는 논문 전체가 아니라 아이디어를 나타내는 초록을 제공한다.[3]
사람 초록에서 실험 성과·비교 결과 등을 제거하되 핵심 기여는 유지하고, 별도 실험에서는 사람·생성 아이디어 모두를 목적 / 작동 원리 형식으로 바꾼다.[6]
따라서 ‘사람이 쓴 아이디어’는 출처를 뜻하며, 모델의 편집을 전혀 거치지 않은 원문이라는 뜻은 아니다.
사람끼리의 비교와 생성 아이디어 비교를 나눈다
Human-Only는 높은 신규성의 사람 아이디어와 낮은 신규성의 사람 아이디어를 비교한다.[3]
Human+Generated는 높은 신규성 풀을 그대로 두고, 낮은 쪽만 Claude Sonnet 4.5가 생성한 154개 아이디어로 바꾼다.[5]
생성기는 연구 분야와 신규 아이디어를 제안하라는 지시만 받으며, 문헌 검색·도구·반복 개선·피드백을 사용하지 않는다.[3]
| 평가 설정 | 구성과 평가 단위 |
|---|---|
| Human-Only | 사람 아이디어 154개와 145개. 단일 판정 299건, 쌍별 비교 154쌍이다.[4] |
| Human+Generated | 사람 아이디어 154개와 생성 아이디어 154개. 단일 판정 308건, 쌍별 비교 154쌍이다.[4] |
쌍별 비교는 같은 연구 분야 안에서 짝을 만든다.[3]
Human-Only는 낮은 신규성 풀이 더 작아 일부 아이디어가 여러 쌍에 재사용될 수 있다.[4]
두 설정은 높은 신규성 풀도 공유하므로, 행 수를 더해 독립적인 새 아이디어 수라고 해석하면 안 된다.
더 중요한 차이는 생성 아이디어의 라벨이 약한 라벨이라는 점이다.[3]
검증된 최상위권 논문보다 단순 생성기의 아이디어가 덜 신규하다고 가정하며, 개별 생성 아이디어 전부에 전문가가 정답을 붙인 것은 아니다.[1][3]
단일 전문가가 오류 사례에 집중한 30쌍을 블라인드로 검토해 모두 사람 아이디어를 선호했지만, 이는 전체 라벨의 정답성을 보증하는 검증은 아니다.[3][4]
더 강한 생성기로 바꾼 추가 실험일수록 이 가정에는 더 주의가 필요하다.[3]
판정 방식과 동률 처리가 점수의 일부다
연구는 GPT-5.1·5.2·5.4, Claude Sonnet 4.5·Opus 4.5·4.6을 평가기로 사용하고, 기준 설정에서 한 요소씩 바꾼다.[3]
프롬프트, 관련 문헌 제공, 추론 예산, 아이디어 형식, 판정 집계, 생성기 선택이 실험 축이다.[3]
단일 판정(pointwise)은 아이디어 하나가 상위 AI 학회의 신규성 문턱을 넘는지 이진 분류하고, 두 클래스의 macro-F1을 보고한다.[3]
쌍별 판정(pairwise)은 두 아이디어 중 더 신규한 것을 선택한다.[3]
기준 설정은 순서를 바꿔 각각 세 번, 총 여섯 번 호출하고, 집계 득표가 같으면 동률로 처리한다.[4]
주요 쌍별 결과는 동률에 점수를 주지 않는 strict accuracy다.[3]
부록의 soft accuracy는 동률을 0.5점으로 계산한다.[4]
여기서 동률은 주로 강제 선택들을 집계한 결과이지, 모델이 명시적으로 기권한 응답이 아니다.[8]
따라서 집계 불일치와 반대쪽을 선택한 오답을 구분하고, 단일 판정의 macro-F1과 쌍별 정확도도 따로 읽어야 한다.
몇 단어의 차이가 52.6%포인트를 만든다
대표 비교의 첫 프롬프트는 “상위 AI 학회 리뷰어가 한 아이디어는 신규하고 다른 하나는 그렇지 않다고 판단했다”고 알려 주고, 어느 것인지 고르도록 한다.[4]
두 번째는 이 사전 리뷰 언급을 빼고 신규한 아이디어를 고르도록 한다.[1]
정답 아이디어가 A인지 B인지를 알려 주는 프롬프트는 아니다.
다만 사전 판단과 절대적 신규성에 대한 질문은 완전히 동등한 지시도 아니다.[3]
생성 아이디어는 실제 학회 심사를 받은 것이 아니므로, 첫 프롬프트의 리뷰 언급을 두 아이디어 모두의 실제 이력으로 받아들여서도 안 된다.[3]
Human+Generated에서 GPT-5.4의 strict accuracy는 93.5% → 40.9%, 실제 판정이 달라진 쌍은 55.8%였다.[1][3]
같은 변경은 Human-Only의 GPT-5.4에서 약 7%포인트, Claude Opus 4.6에서는 약 21%포인트의 차이를 냈다.[1][3]
사람 논문에서 덜 흔들린 평가기가 생성 아이디어에서도 안정적이라는 보장이 없다는 결과다.
여기서는 정확도의 변화와 판정의 불일치를 구분해야 한다.
약한 라벨에 잡음이 있으면 어느 프롬프트가 더 정확한지는 달라질 수 있지만, 동일한 입력에서 설정에 따라 판정이 바뀐다는 관찰 자체는 남는다.[3]
논문의 가장 견고한 메시지는 ‘어느 평가기가 진짜 정답인가’보다 ‘평가 계약에 따라 결론이 얼마나 변하는가’에 있다.
검색과 추가 추론이 자동으로 해결해 주지는 않는다
기본 검색 실험은 사전 수집한 관련 논문 초록 5개를 제공하며, 신규성을 그 문헌에 비춰 평가하도록 프롬프트도 조정한다.[3]
저자들은 검색이 판정을 뒤집어 오답이 된 사례에서, 각 구성요소의 선행연구를 발견하자 새로운 조합까지 단순 결합으로 치부하거나, 검색된 몇 편에 같은 제안이 없다는 이유로 신규하다고 판단하는 패턴을 관찰했다.[3][4]
이는 검색 자체보다 검색 결과를 어떤 판단 기준으로 사용하는가의 문제를 보여 준다.
별도의 강한 검색 실험은 GPT-5.6 Sol에 높은 추론 예산과 반복적인 arXiv 검색을 허용했다.[4]
이 비교는 모두 아이디어당 한 번 호출했고, macro-F1은 약 0.78, 표준 검색을 사용한 Claude Opus 4.6은 약 0.89였으며 에이전트형 검색은 판정당 비용이 약 10배 높았다고 보고한다.[1]
모델도 함께 바뀐 비교이므로, 이를 검색의 순수한 인과 효과나 모든 검색 방식의 상한으로 해석하면 안 된다.
전용 평가기와의 비용 비교도 흥미롭다.
아래 비용은 Human+Generated 단일 판정 실험의 전체 평가 비용으로, 요청 한 번의 가격이 아니다.[1][4]
| 평가 구성 | macro-F1 · 전체 비용 |
|---|---|
| 단순 Opus 4.6, 낮은 추론 예산 | 0.854 · $2.59. 세 번 호출한 다수결이다.[4] |
| Idea Novelty Checker | 0.642 · $30.66. 검색·필터링·재순위화를 포함한다.[4] |
| AI-Scientist 신규성 평가기 | 0.772 · $82.05. 문헌 검색을 반복한다.[4] |
전용 평가기는 둘 다 Opus 4.6을 사용하며, 판정당 한 번 실행하고 여러 판정의 투표 집계는 하지 않는다.[1][4]
같은 평가 목표에 대한 비용·품질 비교이지, 모든 시스템의 내부 API 호출 수와 구성이 같은 실험은 아니다.
또한 0.854는 가장 저렴한 프롬프트 구성의 결과로, 논문 전체에서 가장 높은 macro-F1이라는 뜻도 아니다.[4]
공개 데이터로 할 수 있는 일과 남은 한계
공식 저장소는 평가 코드와 데이터 구성 파이프라인을 제공하고, Hugging Face에는 추상문·계획문, 단일·쌍별 형식 등을 나눈 테스트 구성을 배포한다.[5][6]
데이터 카드는 단일 test split의 평가용 데이터이며 학습·미세조정에 사용하지 말 것을 명시한다.[6]
Hugging Face 데이터셋에는 판정 결과, 프롬프트·응답 로그, 추론 흔적, 검색 기록이 포함되지 않는다.[6]
저장소에는 전문가 검토용 CSV의 최종 판정 30개가 별도로 공개돼 있지만 전체 실행 로그는 없다.[7]
공개 코드와 데이터가 있다는 사실만으로 논문의 모든 실행 기록까지 공개됐다고 볼 수는 없다.
실행에는 OpenAI·Anthropic API가 사용되고, 검색에는 Semantic Scholar 접근이 추가된다.[5]
이 글의 수치는 저자 보고값이며, 유료 평가를 재실행해 얻은 결과는 아니다.
코드의 Apache-2.0과 데이터의 ODC-BY 1.0도 구분해야 한다.[5]
리뷰 발췌는 OpenReview의 CC BY 4.0 출처 표기를 유지해야 하며, 모델 생성 필드에는 제공사 약관도 적용될 수 있다.[6]
적용 범위는 ICLR의 AI 연구 아이디어, 극단 구간에서 고른 사람 논문, 도구 없는 단순 생성기라는 조건에 묶여 있다.[3]
신규성은 실현 가능성·영향력·실험적 타당성과도 다르다.
높은 신규성 판정을 얻었다고 좋은 연구가 완성되는 것은 아니다.
실무적으로 이 연구가 권하는 방향은 평가기를 버리기보다 평가기 자체를 검증 대상으로 두는 것이다.
생성 아이디어와 비슷한 분포의 검증셋을 만들고, 프롬프트·모델·순서·집계·동률 규칙을 고정한 뒤, 설정 변화에 따른 판정 일치율도 함께 보고해야 한다.
문헌 검색의 근거와 사람 검토를 남기는 일까지 포함해야 ‘신규성 점수’가 연구 의사결정에 쓸 수 있는 증거가 된다.