장기 작업을 하는 coding agent에서 비용을 결정하는 것은 답 하나의 품질만이 아니다.
어느 branch를 더 파고들지, 무엇을 병렬로 돌릴지, 언제 exploration을 멈출지를 정하는 탐색 정책이 쌓인 agent call과 wall-clock time을 크게 바꾼다.[1][2]
Dream-RSI는 이 meta-level exploration을 새 model weight 학습으로 풀지 않는다.[1][2]
대신 이미 끝난 discovery run의 tree를 “실행된 search space에 대해서는 정확한 replay simulator”로 읽고, 다음 탐색 정책 후보를 그 안에서 저비용으로 비교한 뒤 실제 온라인 run에는 winner만 내보낸다.[1][2]
무엇을 해결하려는가
recursive self-improvement의 discovery loop는 후보를 만들고, 평가하고, feedback을 반영하는 과정이 수천 번 이어질 수 있다.[2][3]
이때 fixed exploration strategy는 앞선 실패에서 배우지 못하고, 반대로 exploration policy를 online에서 직접 최적화하면 후보 하나를 검증하는 데도 긴 rollout 전체를 다시 봐야 한다.[2][3]
Dream-RSI의 출발점은 이미 지불한 비용을 다시 쓰자는 것이다.[1][2]
완료된 discovery run에는 parent workspace에서 출발한 attempt, 실행 artifact, evaluator score, diagnostics가 tree 형태로 남는다.[2]
다른 policy가 같은 tree에서 다른 branch 순서·parallel grouping·stopping rule을 택해도, tree 안에 이미 저장된 outcome을 reveal하면 되므로 discovery agent와 evaluator를 다시 호출할 필요가 없다.[1][2]
다만 이것은 learned world model이 아니다.[1][2]
저자들이 말하는 simulator는 이미 도달한 branch에 한해서만 exact하다.[1][2]
history 밖의 새 branch가 어떤 결과를 낼지는 알 수 없기 때문에, replay만 반복하는 one-shot optimization이 아니라 online deployment로 새로운 tree를 추가하는 loop가 필요하다.[1][2]
핵심 아이디어 / 구조 / 동작 방식
Dream-RSI는 underlying coding agent와 evaluator는 고정해 둔 채, exploration을 executable policy로 분리한다.[2]
이 policy가 root 또는 leaf에서 continuation을 고르고, 한 round의 parallel batch 크기와 stop 시점을 결정한다.[2]
한 outer iteration은 네 단계로 읽을 수 있다.
- Online explore: 현재 policy가 실제 discovery agent를 움직여 새로운 tree와 realized execution outcome을 만든다.[1][2]
- Store and construct: tree의 node마다 workspace·artifact·score·diagnostics를 남기고, 누적 history를 replay simulator pool로 사용한다.[1][2]
- Dreaming / replay: policy-development agent가 exploration-policy code를 여러 revision으로 만들고, 각 revision을 고정된 history의 모든 tree에 replay한다.[1][2]
- Select and redeploy: 현재 배포 policy도 candidate set에 포함해 replay objective가 더 나쁜 revision을 막고, 선택된 policy를 다음 online run에 사용한다.[1][2]
replay objective는 발견한 candidate의 quality, 대표된 execution cost, parallelism을 함께 고려한다.[2]
즉 replay가 실제 API cost를 내지는 않지만, tree 안에서 해당 policy가 reveal한 node 수와 decision round를 이용해 “실제로라면 어떤 탐색 예산을 썼을지”를 score에 반영한다.[2]
이 설계가 보장하는 것은 고정 history에서의 replay score 비열화 방지다.[1][2]
현재 policy 자체를 후보로 넣기 때문에 선택된 revision은 그 replay objective에서 현 policy보다 낮아지지 않는다.[1][2]
이것을 다음 unseen online task에서의 무조건적인 성능 향상으로 읽어서는 안 된다.[1][2]
공개된 근거에서 확인되는 점
저자들은 algorithm engineering, mathematical optimization, GPU kernel engineering의 세 영역에 걸친 8개 discovery task로 평가했다고 보고한다.[1][2]
project page의 강조 수치는 Lasso에서 fixed exploration 대비 1.7배, SimpleTES 대비 최대 162배 적은 discovery-agent call, VGG16에서 comparable performance까지 2.43배 적은 generation, ConvDiv에서 comparable budget 기준 2.09배 높은 performance다.[1][2]
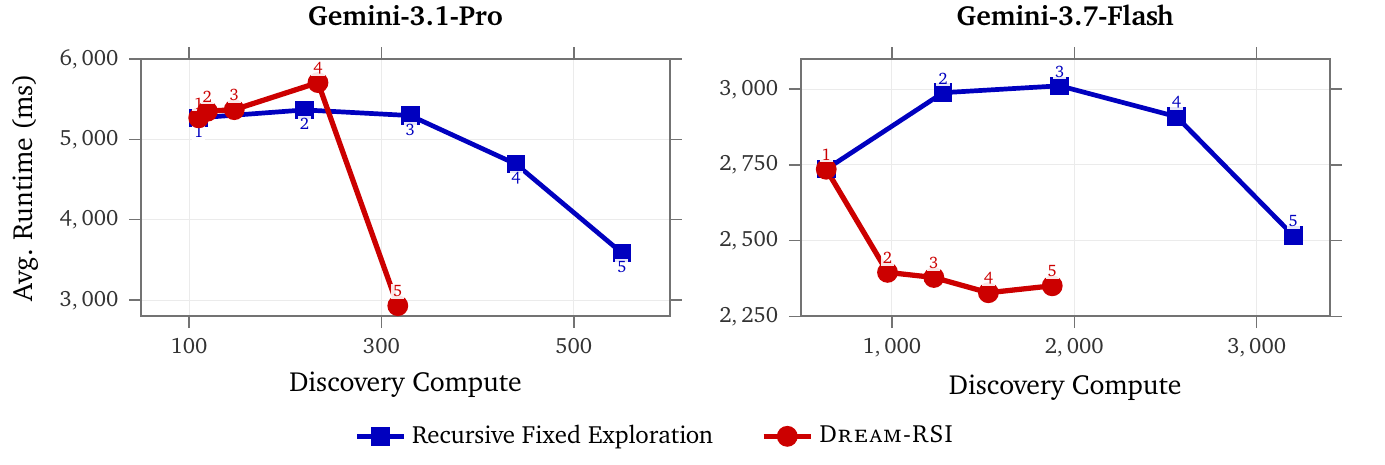
여기서 가장 읽을 만한 비교는 수치 자체보다 baseline의 성격이다.[1]Recursive Fixed Exploration은 agent, evaluator, initialization, per-round budget은 맞추되 exploration policy만 바꾸지 않는 controlled baseline이다.[1][2]
따라서 이 실험은 “더 좋은 base agent인가”보다 같은 discovery machinery에서 탐색 orchestration을 바꿨을 때를 겨냥한다.[1][2]
반면 모든 영역에서 headline 승리만 보고할 수는 없다.[1]
수학 최적화의 Auto Correlation 표에서는 SimpleTES의 1.453675가 Dream-RSI의 1.456375보다 낮고, 해당 metric은 lower-is-better다.[1]
project page도 그 차이와 함께 SimpleTES의 51,200 generation, Dream-RSI의 1,000 미만 generation을 나란히 제시한다.[1]
release를 어떻게 읽어야 하나
Dream-RSI는 2026년 9월 13일 arXiv에 제출된 preprint이며, public repository와 project page는 공개되어 있다.[3][4][5]
하지만 repository의 release plan은 현재 paper, project page, interactive demo만 available로 두고, discovered programs·full codebase·reproduction scripts는 “being prepared”로 표시한다.[4][6]
GitHub API 기준 repository는 2026년 9월 13일 생성됐고 default branch는 main이며, license field가 비어 있고 GitHub Releases도 확인되지 않는다.[5]
따라서 이 시점의 artifact는 runnable end-to-end framework라기보다 논문·interactive explanation·release 계획이 먼저 열린 연구 공개물로 해석하는 편이 정확하다.
이 점은 부정적인 평가가 아니라 재현성의 경계를 분명히 하는 일이다.[4][6] claim의 핵심은 discovery tree를 replay world로 쓰는 method이고, 공개 README도 code가 release 준비 중이라고 명시한다.[4][6] production adoption이나 independent benchmark replication을 판단하려면 이후 code, task setup, evaluator, trace artifact와 reproduction script가 추가로 필요하다.[4][6]
실무 관점에서의 해석
Dream-RSI가 제안하는 가장 유용한 전환은 trace를 “다음 prompt에 넣을 context”가 아니라 counterfactual policy evaluation 자산으로 다루는 것이다. agent run이 branch 구조, checkpointable workspace, outcome, cost를 보존한다면, 복수의 future orchestration rule을 실제로 다시 실행하지 않고 먼저 배제할 수 있다.[1][2]
이를 적용하려면 plain conversation log만으로는 부족하다.
적어도 parent-child lineage, node별 artifact와 evaluator output, 실행 cost, observation visibility boundary가 남아야 한다.
그리고 replay score가 최적화하는 quality·cost·parallelism의 trade-off는 업무의 risk model과 맞아야 한다.[2]
그래서 처음의 좋은 적용 범위는 evaluator가 이미 있는 code search, kernel optimization, automated debugging처럼 offline replay가 의미 있는 domain이다.
반대로 production environment가 계속 변하거나, tree가 보지 못한 action의 위험이 크고 evaluator도 약한 업무라면 replay score의 개선을 곧바로 autonomy 확대의 근거로 삼으면 안 된다.
결국 Dream-RSI는 “agent가 스스로 더 잘한다”는 넓은 구호보다 구체적이다.
한 번 비싼 exploration을 수행했다면, 그 trace를 다음 exploration policy를 시험하는 replay world로 바꿔라.
이 아이디어가 일반화되려면 추후 release의 trace schema, evaluator protocol, reproduction boundary가 method만큼 중요해질 것이다.[1][2]