에이전트가 실행 경험에서 스킬을 고쳐 나가는 방식은 매력적이지만, 한 iteration의 rollout과 수정본이 다음 iteration에서 어떻게 기억되는지는 종종 불분명하다. trace를 전부 다시 읽으면 비용과 context가 커지고, 반대로 최종 SKILL.md만 남기면 왜 어떤 규칙이 생겼고 어떤 변경이 실패했는지 사라진다.
누적된 경험이 다음 수정의 근거가 아니라 산발적인 작업 로그가 되는 문제다.
Google Research와 Virginia Tech의 WikiSkill: Compiling Agent Experience into Persistent Knowledge for Skill Evolution은 이 중간 층을 명시적으로 분리한다.[1][2]
원본 실행 기록은 바꾸지 않고 보관하고, 성공·실패 패턴과 변경 이력을 별도 wiki에 축적하며, 실제 실행에 쓰이는 skill은 validation을 통과한 절차만 담는다.
핵심은 스킬 문서를 길게 만드는 것이 아니라, 실패한 수정까지 재사용 가능한 근거로 보존하는 것이다.
무엇을 해결하려는가
기존 skill-evolution 방법도 rollout을 실행하고 결과를 분석해 절차 문서를 바꾼다.
그러나 이전 proposal과 평가 결과를 단순 history로 남기거나, trace에서 얻은 교훈을 곧장 다음 skill 편집에 압축하면 지식 표현 자체가 독립적으로 진화하지 않는다.[2]
같은 실패 원인을 다른 문장으로 다시 제안하거나, 과거에 reject된 변경을 반복하거나, 여러 iteration에 걸친 예외 조건을 놓치기 쉬운 구조다.
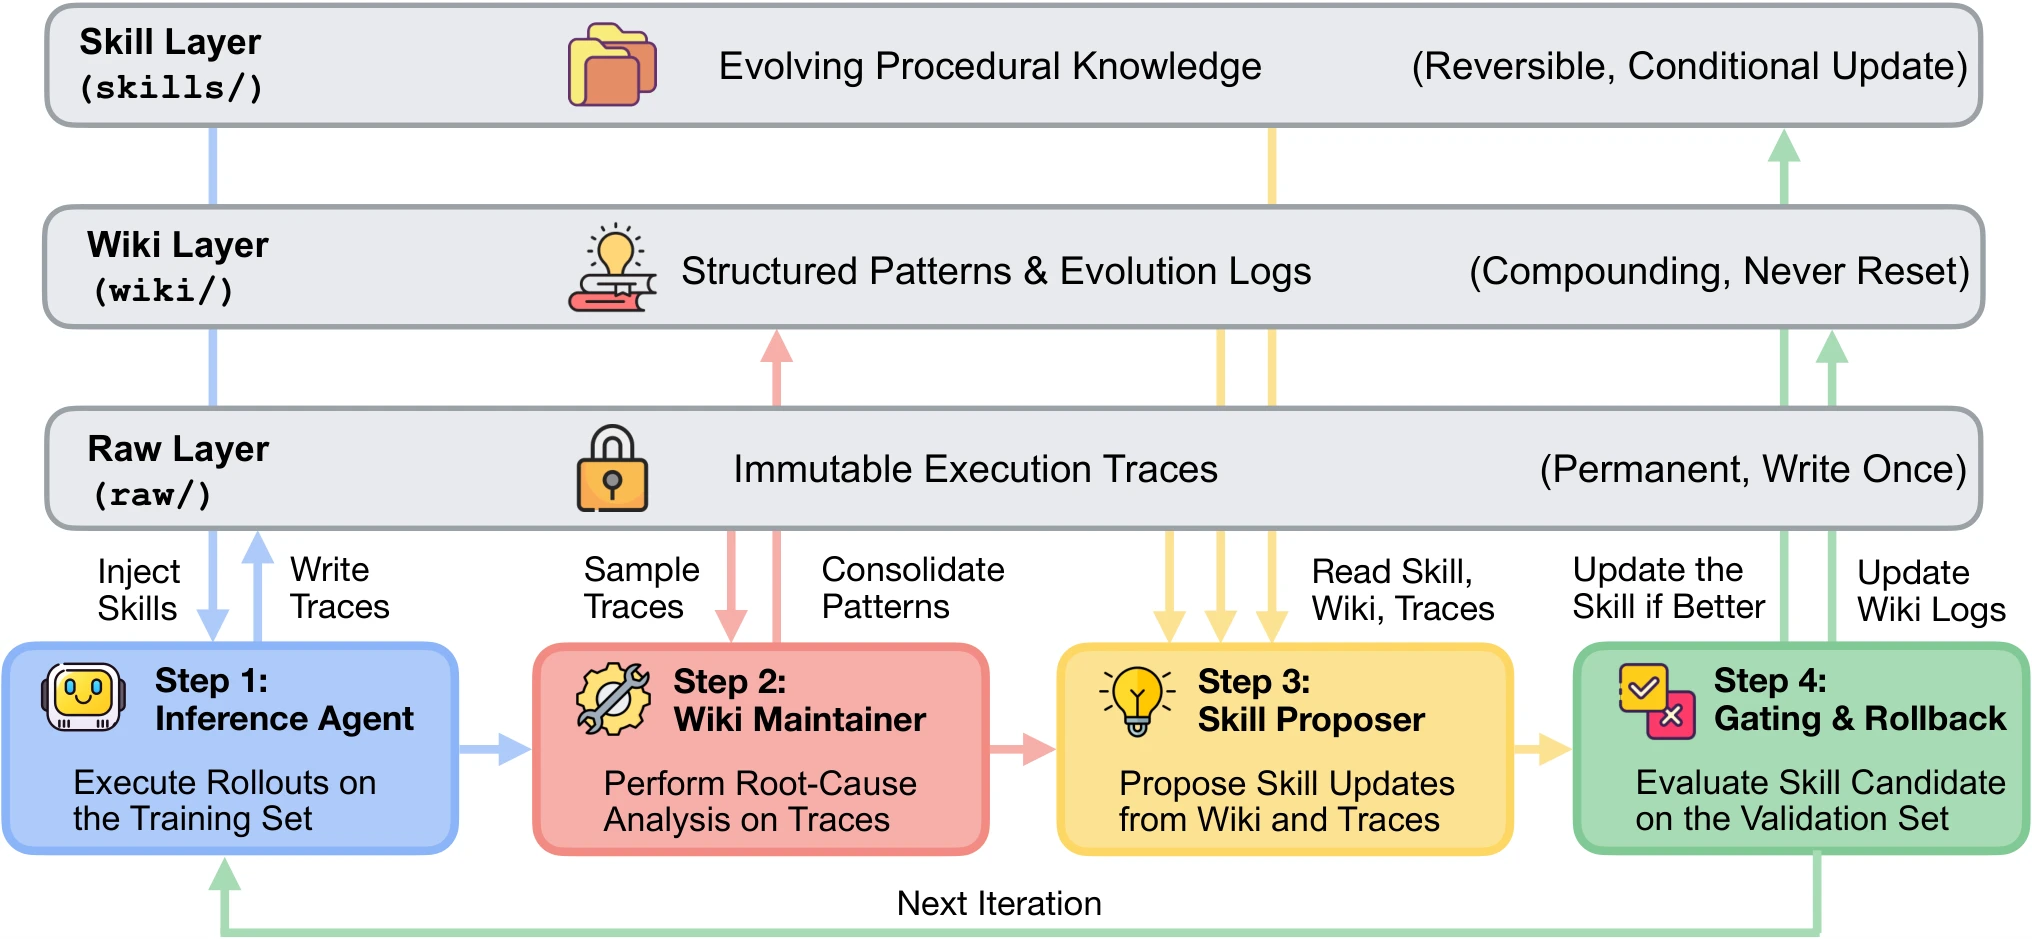
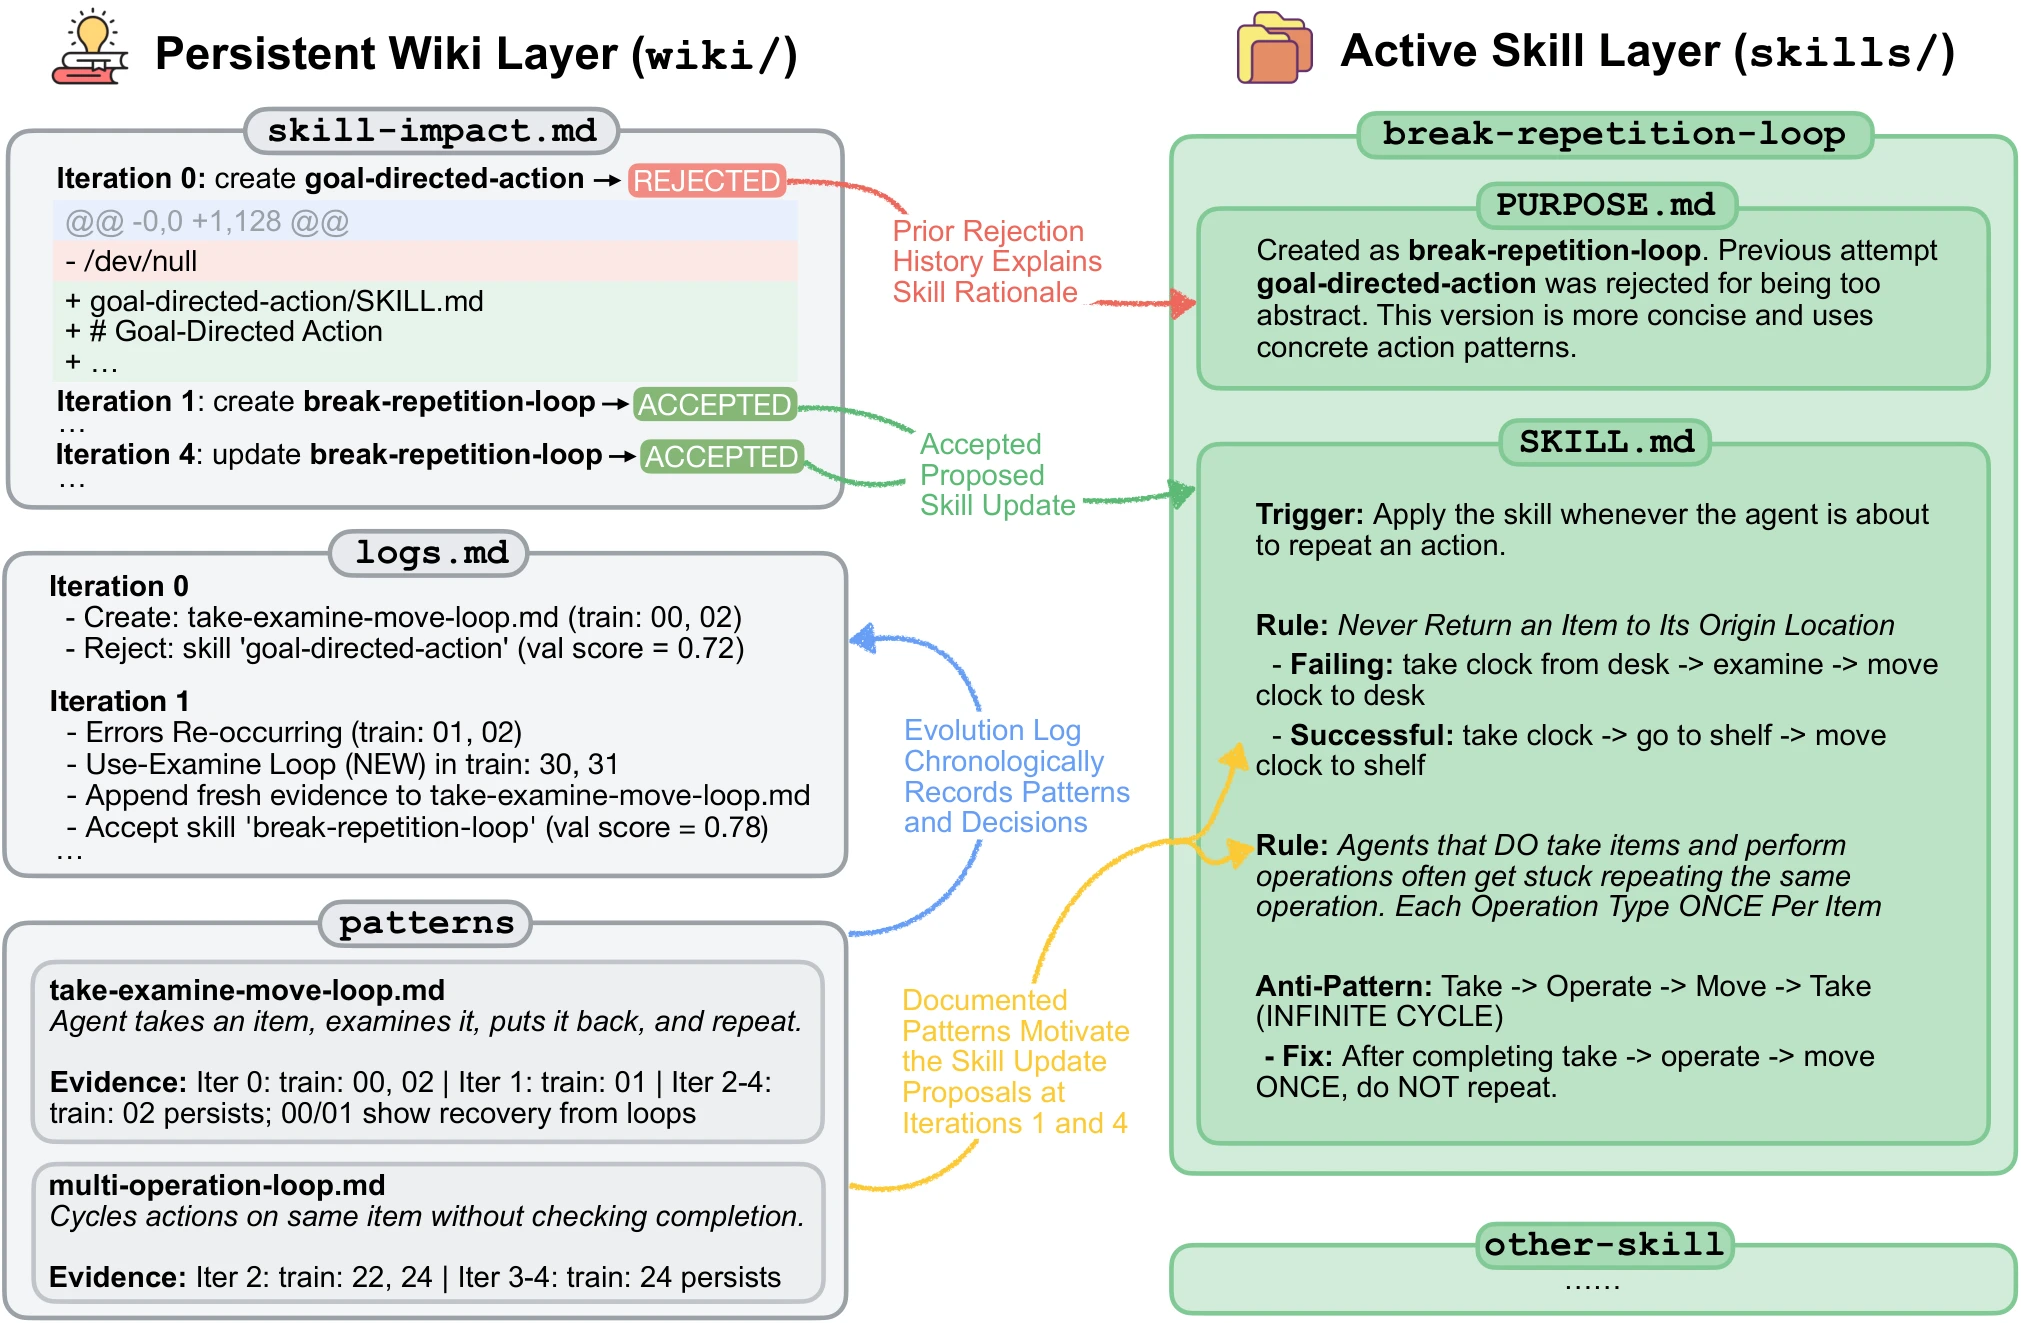
WikiSkill은 이 문제를 세 개의 저장소로 나눈다.[2] raw/에는 reasoning·tool call·출력·정답을 포함한 immutable trace를 남기고, wiki/에는 실패 원인과 성공 전략을 문서화한 patterns/, 시간 순서의 logs.md, proposal diff와 validation 결과를 기록하는 skill-impact.md를 둔다. skills/에는 Inference Agent가 읽는 SKILL.md와 그 규칙이 어떤 wiki pattern에서 왔는지 연결하는 PURPOSE.md만 둔다.
| 계층 | 보존하는 것 | 변경 규칙 | 실행 중 역할 |
|---|---|---|---|
Raw Layer (raw/) |
완전한 실행 trace | 영구·write once | Maintainer와 Proposer의 분석 근거 |
Wiki Layer (wiki/) |
패턴, evolution log, proposal 영향 이력 | iteration을 넘어 누적 | Proposer가 과거 실패와 수용 이력을 조회 |
Skill Layer (skills/) |
에이전트가 따를 절차 | validation 결과에 따라 수용·rollback | Inference Agent에 직접 주입 |
이 분리는 “모든 기억을 항상 agent에게 준다”는 설계가 아니다.
논문의 기본 설정에서 Inference Agent는 active skill만 받고 training rollout 중에는 wiki를 읽지 못한다.[2] wiki가 답을 직접 제공해 rollout을 좋아 보이게 만들면, 실제로 어떤 skill 규칙이 효과가 있었는지 학습 신호가 흐려질 수 있기 때문이다.
핵심 구조: trace를 지식으로 컴파일하고, skill만 되돌린다
한 iteration은 네 역할로 이어진다.[2]
Inference Agent가 현재 skill을 사용해 training task를 풀고 trace를 남긴다.
Wiki Maintainer는 성공·실패 trace 표본과 기존 wiki를 함께 보며 root cause와 workaround를 pattern page로 정리한다.
Skill Proposer는 wiki index, 과거 proposal의 accept/reject 이력, 필요한 raw trace를 선택적으로 읽어 한 skill에 대한 atomic 변경안을 낸다.
마지막으로 Gating & Rollback이 validation split에서 개선 여부를 확인해 skill만 보존하거나 되돌린다.
여기서 비대칭성이 중요하다. reject된 skill proposal은 실행 절차에서 사라지지만, 그 diff와 validation score는 skill-impact.md에 남는다.[2]
즉 실패한 변경을 product rule로는 채택하지 않되, 다음 proposer가 같은 가설을 되풀이하지 않도록 하는 학습 자료로는 남긴다.
논문이 말하는 persistent knowledge는 단순 벡터 검색용 메모리보다 수정 의사결정의 감사 흔적에 가깝다.
공개된 근거에서 확인되는 점
평가는 수학 추론 LiveMath, 웹 검색 SealQA, spreadsheet 조작 SpreadSheetBench, 장문서 QA OfficeQA, embodied task ALFWorld의 다섯 benchmark와 Qwen·Gemma·Gemini 계열 다섯 모델에서 이뤄졌다.[2]
모든 수치는 세 번의 독립 evolution run에서 나온 evolved skill set의 평균 test performance이며, 저자들은 paired bootstrap test로 차이를 평가했다고 설명한다.[2]
| 모델 | No skill 평균 | 가장 높은 비교 방법 평균 | WikiSkill 평균 | 비교 방법 대비 차이 |
|---|---|---|---|---|
| Qwen-3.5-4B | 26.2 | 35.2 (SkillOpt) | 38.5 | +3.3p |
| Qwen-3.5-9B | 29.9 | 42.3 (EvoSkill) | 47.4 | +5.1p |
| Qwen-3.6-27B | 39.4 | 53.3 (EvoSkill) | 63.3 | +10.0p |
| Gemma-4-31B | 41.3 | 49.1 (SkillOpt) | 54.9 | +5.8p |
| Gemini-3.5-Flash | 49.5 | 56.1 (EvoSkill) | 68.1 | +12.0p |
표의 신호는 두 가지다.
먼저 WikiSkill은 다섯 모델 모두에서 비교 skill-evolution 방법 중 가장 높은 평균을 보고한다.[2]
또 Qwen 계열에서는 모델 크기가 커질수록 no-skill 대비 상대 개선폭도 4B 12.3%, 9B 17.5%, 27B 23.9%로 커졌다고 저자들은 해석한다.[2]
이 결과는 skill이 작은 모델을 대체하는 만능 압축물이기보다, 더 강한 model capability가 있을 때 축적된 절차 지식을 더 잘 실행할 수 있다는 가설을 지지한다.
transfer 결과도 흥미롭다.
Qwen-3.5-9B는 자체 진화 skill을 썼을 때 ALFWorld 63.4%였지만, Qwen-3.6-27B가 진화시킨 skill을 적용했을 때 70.2%를 기록했다고 보고된다.[1][2]
이 수치는 skill을 만든 모델과 skill을 실행하는 모델의 능력이 다를 수 있음을 보여 주지만, benchmark·prompt·tool harness가 고정된 실험 결과다.
임의의 production agent에 그대로 옮길 수 있다는 보장은 아니다.
persistent wiki가 실제 기여인지 보기 위한 ablation도 있다.
Gemini-3.5-Flash에서 Inference Agent의 wiki 접근을 막은 상태로, Proposer가 persistent wiki 없이 작업하면 네 benchmark 평균은 48.7%였고, wiki를 주면 63.7%로 +15.0p 상승했다.[2]
반대로 Proposer가 wiki를 읽는 기본 구성에서 Inference Agent에게도 wiki를 열면 평균이 60.9%로 내려갔다.[2]
이 설계에서 wiki는 online answer memory가 아니라, skill 개선을 위한 offline evidence store여야 한다는 주장과 맞물린다.
공개 범위는 보수적으로 봐야 한다. arXiv v1은 논문 HTML·PDF·그림을 공개하지만, 본문과 연동된 공식 code repository나 model checkpoint 링크는 확인되지 않는다.[1][2]
따라서 지금의 WikiSkill은 바로 설치하는 framework라기보다, trace 보존·knowledge consolidation·검증 가능한 skill gate를 분리해 설계한 연구 artefact로 보는 편이 정확하다.
실무에서 읽는 법: agent memory와 실행 규칙을 같은 저장소로 취급하지 말 것
이 논문의 실무적 가치는 wiki라는 파일 구조 자체보다 update 권한을 나눈 데 있다.
실행 규칙은 agent 행동을 즉시 바꾸므로 validation gate와 rollback이 필요하다.
반면 failure taxonomy, accept/reject history, evidence는 다음 hypothesis를 만드는 장기 자산이므로 reject된 뒤에도 사라지면 안 된다.
운영 환경이라면 raw → evidence → proposed change → evaluated rule의 lineage를 남겨야 사후 audit과 원인 분석이 가능하다.
그렇다고 wiki를 무제한 누적 로그로 만들면 다시 읽을 수 없는 기록 저장소가 된다.
논문에서도 Maintainer는 trace 전부가 아니라 성공·실패 표본을 보고 pattern을 통합하고, Proposer는 전체 raw history가 아니라 index와 impact tracker에서 출발해 필요한 trace를 골라 읽는다.[2]
도입 시에는 pattern의 생성 기준, evidence link, 만료·통합 규칙, skill 영향 추적을 먼저 정하는 편이 안전하다.
마지막으로 gate의 대상은 모델 답변 하나가 아니라 skill 변경의 장기 효과여야 한다.
검증 set을 넘는다고 해서 prompt·tool·권한·데이터 계약이 다른 production 환경까지 좋아진 것은 아니다.
비용, 보안, 고객 응답, 외부 API 동작에 영향을 주는 skill이라면 offline validation 뒤에도 human review와 제한된 rollout을 남겨야 한다.
WikiSkill은 self-improvement를 무제한 자동 수정으로 만들기보다, 기억은 누적하되 행동 규칙의 반영은 보수적으로 만드는 운영 원칙으로 읽을 때 가장 유용하다.