긴 문맥에서 attention 비용을 줄이는 방법은 보통 처음부터 일부 토큰만 선택하거나, 윈도우·블록 패턴으로 볼 수 있는 범위를 제한한다[2].
MassAlloc Attention(MALA)은 다른 지점을 건드린다[1][2].
모든 합법적인 인과적 query-key 쌍의 점수는 살펴보되, 계산된 점수의 정규화 기여도가 작은 타일에서는 값 벡터를 읽고 출력을 누적하는 후속 연산을 생략한다[1][2].
이 차이는 효율 주장을 해석할 때 중요하다.
MALA는 attention 행렬의 희소한 support를 미리 만들거나 QK 곱셈 자체를 없애는 방법이 아니다[2].
논문이 줄인다고 주장하는 것은 점수 계산 이후의 일부 연산이며, 따라서 긴 문맥에서 남는 전체 QK 점수 탐색의 제곱 비용과 KV cache의 보관 비용을 함께 줄여 주지는 않는다[2].
무엇을 해결하려는가
FlashAttention 계열 커널은 타일링과 online softmax로 메모리 이동을 줄였지만, 각 인과적 타일의 QK 점수를 만든 뒤에는 softmax 갱신, V 로드, PV 누적 등 dense 경로를 계속 실행한다[2].
저자들은 실제 attention 확률 질량이 균등하지 않아 많은 영역의 기여가 매우 작다는 점을 이용해, 이 후속 경로에 입력별·헤드별로 다른 계산량을 배정하려 한다[2].
기존의 고정 윈도우나 정적 블록 희소화는 위치에 따라 support를 정하고, 일부 동적 방식은 선택을 위해 별도 점수화·라우팅을 수행한다[2].
MALA는 이미 attention 커널 안에서 구한 QK 점수와 softmax 상태를 선택 신호로 재사용한다[2].
그래서 이 방법의 핵심은 “아예 보지 않을 토큰을 미리 고른다”기보다 “점수를 확인한 뒤, 낮은 기여 타일의 나머지 일을 생략한다”에 있다[2].
핵심 아이디어 / 구조 / 동작 방식
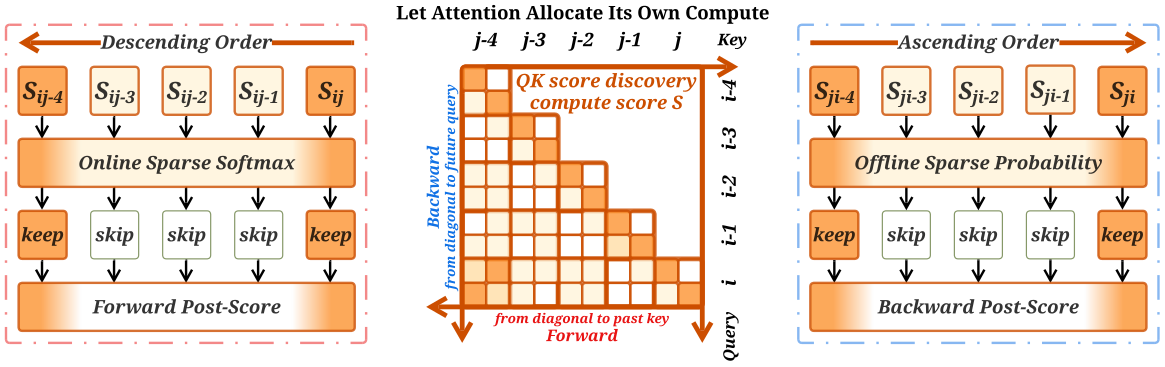
Forward에서는 각 타일의 QK 점수를 계산한 뒤, 현재까지의 online-softmax 최대값과 정규화 합으로 해당 타일이 만들 수 있는 확률 기여도를 보수적으로 검사한다[2].
논문은 query마다 길이로 정규화한 공통 허용치 τ/L_q를 쓰고, 타일의 모든 유효 query 행이 기준 아래일 때만 그 타일을 건너뛴다[2].
타일을 유지할지 여부는 별도 학습된 router나 저장된 희소 인덱스가 아니라 현재 입력의 attention 분포에 따라 달라진다[2].
Backward는 forward에서 저장한 최종 log-normalizer로 재계산한 타일을 검사한다[2].
따라서 forward에서 이미 생략한 타일은 backward에서도 생략 대상이며, backward는 더 많은 타일까지 생략할 수 있다[2].
이 때문에 backward가 forward 연산자의 정확한 미분과 일치한다고 보장되는 것은 아니다[2].
저자들은 이 차이를 gradient 오차 측정으로 평가했고, forward·backward가 표준 attention 상태를 재사용해 별도 마스크나 retained-tile 목록을 저장하지 않는다고 설명한다[2].
| 구분 | MALA의 동작과 남는 점 |
|---|---|
| QK 점수 탐색 | 모든 인과 타일을 점수화하므로 제곱 복잡도가 유지된다. |
| Forward 후속 경로 | 낮은 기여 타일의 V 로드·PV 누적을 생략한다. 출력 오차는 별도로 측정해야 한다. |
| Backward 경로 | 최종 정규화 상태로 다시 판정한다. support가 forward보다 더 줄 수 있어 정확한 gradient를 보장하지 않는다. |
| KV cache | 전체 이력을 점수 탐색 대상으로 유지한다. cache 압축·삭제나 저장 메모리 절감은 별도 문제다. |
논문은 τ=1을 training forward/backward와 inference prefill/decode에 공통으로 사용한다[2].
다만 이 허용치는 고정된 계산 예산을 약속하는 값이 아니다[2]. attention 분포가 뾰족한 query에서는 더 많은 타일을 생략할 수 있고, 분포가 퍼져 있으면 더 많이 유지한다[2].
이 적응성은 workload별 보정 없이 적용할 수 있다는 장점인 동시에, 실제 계산 절감량이 입력·모델·하드웨어에 따라 달라진다는 뜻이기도 하다[2].
공개된 근거에서 확인되는 점
저자들은 먼저 총 후속 연산량을 같게 맞춘 8K 실험에서 MALA의 입력별 배분이 위치 기반·정적 layer/head 배분보다 reference attention 질량을 더 잘 보존한다고 보고한다[2].
MALA의 평균 누락 질량은 0.0188%, reference-mass oracle은 0.0182%였고, 평균 상대 출력 오차는 각각 0.0174%, 0.0164%였다[2].
1K부터 32K까지 operator fidelity를 평가했을 때 보고된 평균 출력 오차 상한은 0.021%, 평균 gradient 오차 상한은 dQ 0.38%, dK 0.35%, dV 0.17%였다[2].
통제된 associative-recall 실험에서는 길이 8K에서 MALA 정확도가 89.67%, FullAttn이 89.97%였다.
이는 해당 실험 조건에서 MALA가 긴 범위의 연관 검색을 거의 따라갔다는 결과이지, 모든 태스크나 모델에서 동등한 품질을 보인다는 뜻은 아니다[2].
| 평가 축 | 결과와 조건 |
|---|---|
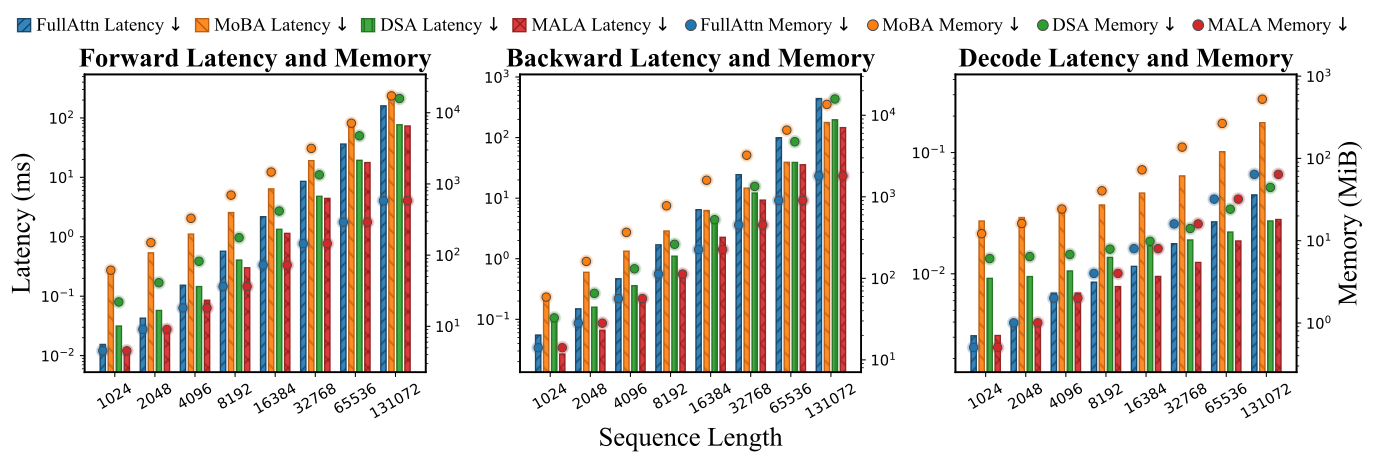
| 128K operator latency | FullAttn 대비 forward 2.2×, backward 3.0×, decode 1.6× 빠름. 8×H100·TP=8 attention operator 측정. |
| Operator peak memory | FullAttn과 비슷한 수준. 메모리 절감이 아니라 후속 연산 생략에 따른 latency 개선이다. |
| 14B, 32K training | 총 training FLOPs 23.1% 감소, perplexity 차이 0.001 미만. 저자들의 scaling-law 조건이다. |
| 8K associative recall | MALA 89.67%, FullAttn 89.97%. 통제된 recall 실험 하나의 결과다. |
스케일링 실험에서 0.6B~14B 모델을 평가했고,[2] 14B·32K long-context training에서는 perplexity를 거의 유지하면서 총 학습 FLOPs를 23.1% 줄였다고 보고한다[2].
4K pretraining 구간에서 보고된 감소폭은 2.5%로 더 작다[2].
따라서 이 논문이 제시하는 이점은 긴 문맥 학습에서 특히 두드러지며, 전체 모델 학습비가 같은 비율로 감소한다는 의미는 아니다[2].
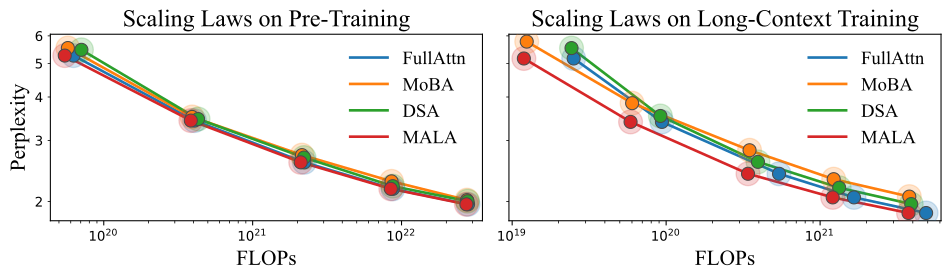
이 수치는 모두 논문 저자들이 제시한 결과다[1][2].
특히 128K latency 비교는 8장의 H100 GPU와 tensor parallelism을 사용한 operator benchmark이며, 일반적인 GPU 한 장이나 실제 서비스 전체의 end-to-end 처리량·비용으로 그대로 환산할 수 없다[2].
평가된 model-level 결과도 저자들의 14B 실험과 별도 continued-training으로 만든 32B 모델에 한정된다[2].
공개 구현과 실무 관점
논문이 연결한 flash-sparse-attention 저장소는 forward/backward sparse attention, sparse softmax threshold 제어, GQA/MQA, causal/local-window 동작 등을 제공하는 GPU 커널 프로젝트다[3][4].
README는 PyPI 패키지와 Hugging Face Kernel 경로를 안내한다[4].
GitHub에는 v2.0.6 릴리스가 공개되어 있고, tag 목록에서도 해당 버전을 확인할 수 있다[5][6].
저장소의 BSD 3-Clause 라이선스는 소스 재배포·수정 시 라이선스 조건을 확인할 수 있는 근거다[7].
다만 이것을 논문 전체 실험을 즉시 재현하는 완제품으로 읽어서는 안 된다.
공개물은 attention kernel 구현과 사용 예제를 제공하지만, 논문에서 사용한 대규모 학습 설정·데이터·모델 checkpoint가 같은 형태로 모두 공개되어 있는지는 별도 확인이 필요하다[1][3][4].
또한 README는 Python 3.9 이상을 적지만 현재 pyproject.toml은 Python 3.10 이상을 요구하므로, 설치 전 현재 패키지 메타데이터를 기준으로 환경을 맞추는 편이 안전하다[4][8].
실무적으로 MALA는 “긴 문맥에서 full attention을 subquadratic으로 바꾼다”기보다 full QK 탐색을 유지하면서 낮은 확률 질량의 후속 연산을 줄이는 fused-kernel 최적화로 보는 게 정확하다[2].
기존 모델을 적용할 때는 latency만 볼 게 아니라 입력별로 실제 생략된 후속 work, output/gradient 오차, 길이별 품질, 지원 GPU·Triton 조합을 함께 검증해야 한다[2][3][4].
이 구분을 지키면 논문의 성능 주장을 과장하지 않으면서도, attention 분포 자체를 런타임 계산량 신호로 쓴다는 설계 아이디어의 가치를 평가할 수 있다.