에이전트가 다음 도구나 행동을 고르는 방법은 후보를 직접 생성하거나 큰 언어 모델에 다시 물어보는 것만은 아니다[1][2].
Contrastive Language Models (CLM)은 상태(state)와 행동(action) 후보를 각각 임베딩하고 두 표현의 점수로 선택을 돕는다고 저자들은 설명한다[3].
저자들이 “System One”이라 부르는 모델의 핵심은 답변 생성보다 주어진 후보 중 현재 상태에 맞는 것을 고르는 일이다[2][3].
생성기가 아니라 상태–행동 점수기
공개된 CLM-8B는 고정된 Qwen3-8B 인코더와 상태·행동용 projection head를 이용해 두 입력을 공통 표현 공간에 놓는다[3][10].
구현은 상태와 질문을 하나의 텍스트로 만들고 후보 설명을 별도로 임베딩한 뒤 투영 벡터의 cosine 점수에 softmax를 적용한다[6][7].
API는 참·거짓형 noul, 다중 선택형 choice, 순서형 score를 제공한다[2][6].
CLM은 호출자가 넘긴 후보만 점수화하므로 임의의 새 도구를 만들거나 장문의 답을 생성하지 않는다[2][7].
모델 카드도 출력 확률은 주어진 후보 집합 안에서의 상대값이며 보정된 확신도로 읽으면 안 된다고 명시한다[10].
이 분리 구조는 후보가 재사용될 때 특히 유용하다[3][7].
대화 상태는 바뀌어도 도구 목록이 고정돼 있다면 상태 임베딩만 새로 계산하고 기존 도구 임베딩을 캐시에 재사용할 수 있다[2][7].
후보 집합이 매 요청마다 달라지는 경우에는 캐시 효과가 줄어든다[7].
무엇을 학습했고, 어떤 성능을 보고했나
저자들은 약 6천만 개 Nemotron 질의응답으로 사전학습하고 약 3천만 개 합성 hard negative로 유사 오답을 구분한 뒤 약 100만 개 에이전트 trajectory로 행동 선택을 보강했다고 설명한다[2][3].
공개 체크포인트는 Qwen3-8B 전체 모델이 아니라 projection head이며 추론에는 별도 Qwen3-8B 인코더가 필요하다[2][10].
| 평가 | 결과와 조건 |
|---|---|
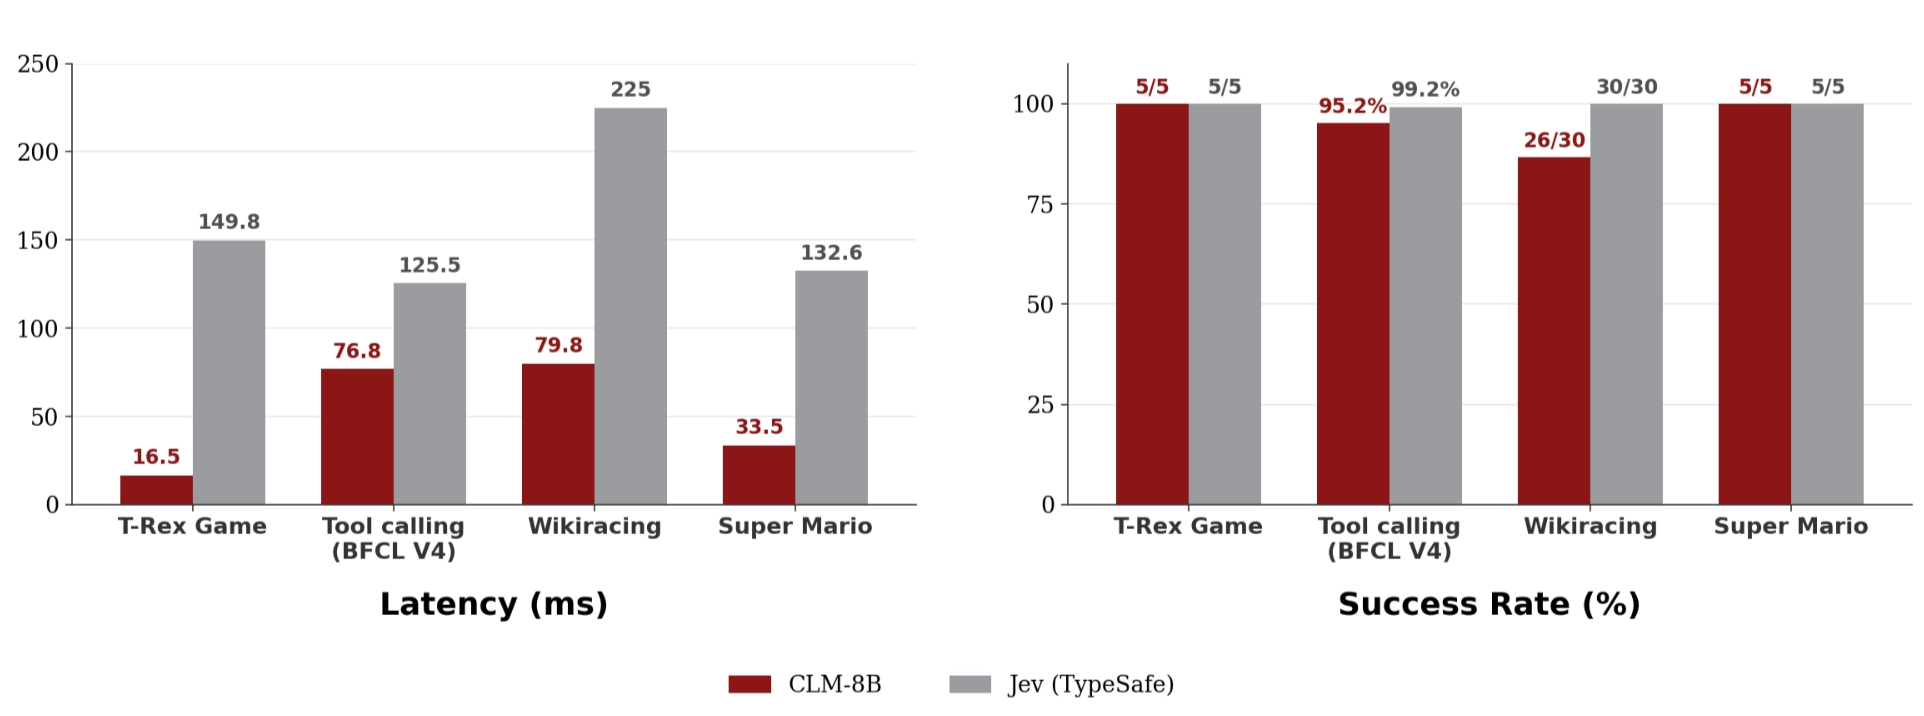
| 게임·도구·컴퓨터 사용 zero-shot | Jev와 비슷한 성공률, 최대 9배 낮은 지연시간; T-Rex, BFCL v4, WikiRacing, Super Mario [2][3] |
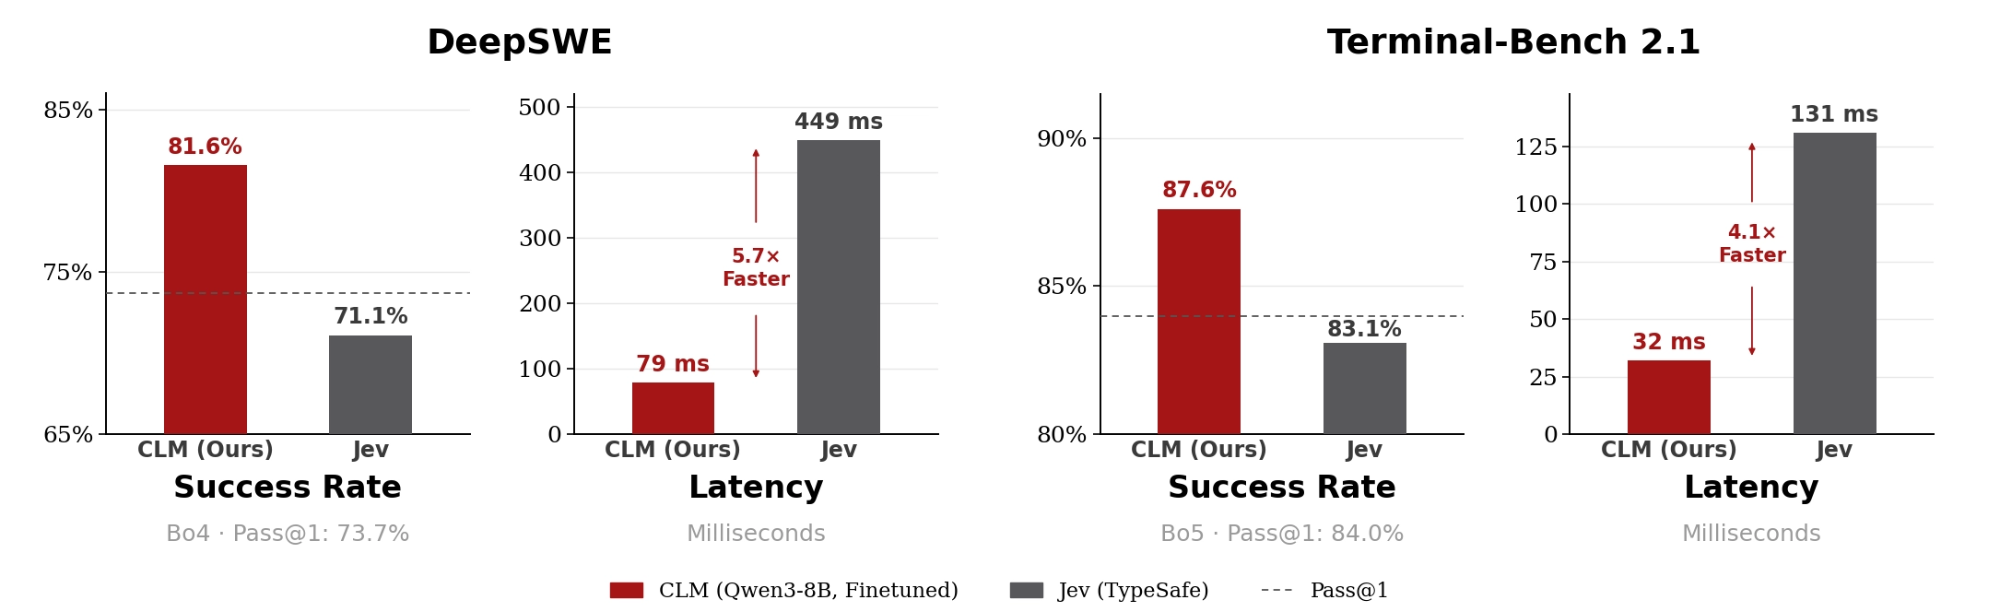
| DeepSWE verifier | 81.6% (31/38), pass@1 73.7%; fine-tuned head, task-disjoint held-out 38개, Bo4 [15] |
| Terminal-Bench 2.1 verifier | 87.6%; fine-tuned head, held-out 30개, H100 지연시간 비교 [2][3] |
두 코딩 벤치마크의 점수는 기본 체크포인트의 zero-shot 성능이 아니라 별도 모델이 만든 여러 해답 중 CLM이 고르는 설정의 결과다[2][3][10].
따라서 이를 “CLM이 코드를 작성한다”기보다 후보 생성기와 선택기를 결합한 verifier 성능으로 읽는 편이 정확하다[2][3][8].
저장소의 fine-tuning 문서는 재현 실험을 고정된 데이터·split·평가 명령으로 수행하는 연구 workflow로 설명한다[14].
공개 재현 결과는 아직 주의가 필요하다
README 코드 예시는 긴급도 확률 0.41022와 frustration 점수 1.98386을 제시하지만 같은 저장소의 playground 캡처에는 84.8%와 2.00이 표시돼 두 공개 출력이 서로 다르다[2].
독립 실행자들도 issue #15에서 같은 요청의 출력이 README와 다르다고 보고했다[5].
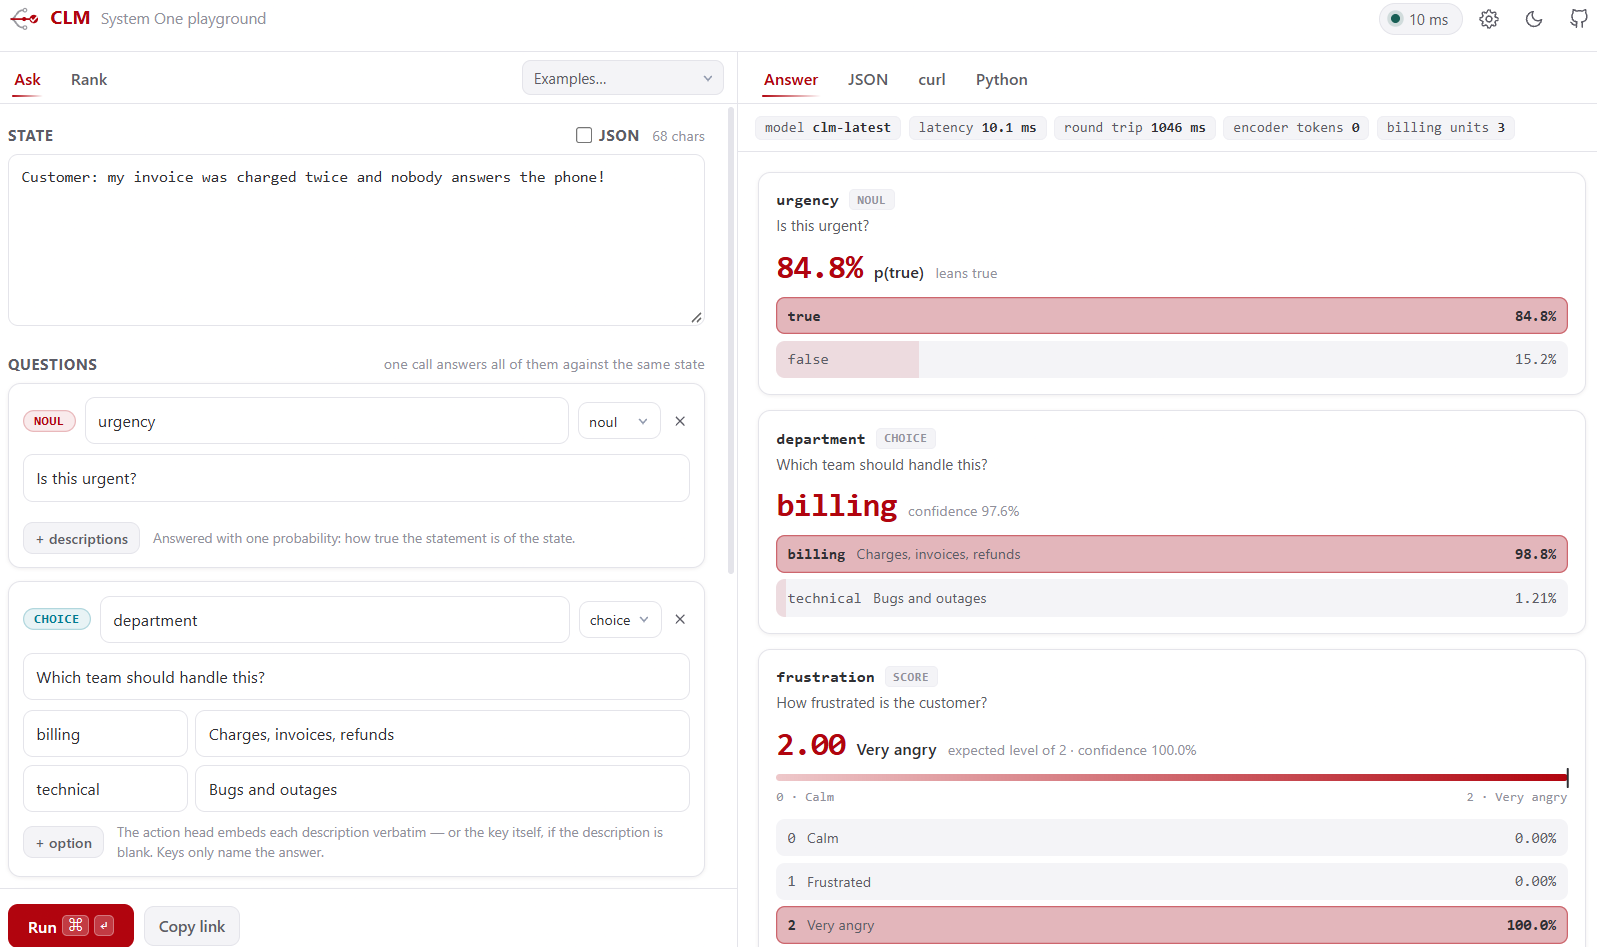
issue #15의 독립 실행 보고는 README 예시 대신 긴급도 약 0.84, billing 약 0.989, frustration 약 2.00을 얻었다고 기록한다[5]. issue #3에는 Calm / Frustrated / Very angry 같은 짧은 후보를 쓸 때 차분한 문장과 화난 문장에 같은 점수를 주는 현상이 여러 embedding backend에서 재현됐다는 보고가 있다[4].
후속 실험자는 후보를 설명형 문장으로 바꾸면 결과가 달라졌지만 원인은 밝혀지지 않았다고 적었다[4].
두 이슈는 확인 시점에도 열려 있었다[4][5].
이는 커뮤니티의 재현 보고이지 우리가 직접 실행한 판정은 아니다[4][5].
다만 보고된 출력 차이가 있으므로 공개 README 수치만으로 범용 분류기나 고신뢰 verifier라고 단정하기는 어렵다[2][4][5].
짧은 후보 라벨에 민감한 업무라면 실제 데이터의 held-out 사례에서 state 민감도, 후보 순서, 표현 변화와 calibration을 먼저 확인하는 편이 안전하다[4][5][10].
도입 관점: 후보 공간이 안정적인 곳부터
CLM은 도구 라우팅이나 게임 행동 선택처럼 후보 집합이 명시적이고 반복되는 작업에 맞는 설계다[2][3].
공개 배포물은 PyPI 0.1.0이며 package metadata는 개발 상태를 Alpha로 표시한다[9][13].
GitHub releases와 tags는 비어 있다[11][12].
기본 설치 의존성은 Qwen3-8B 임베딩 서버용 vLLM이며 macOS 설치 이슈와 Apple Silicon 지원 PR은 확인 시점에 각각 열려 있었다[13][16][17].
코드와 CLM head는 Apache 2.0으로 공개됐지만 작은 projection head만으로는 추론이 되지 않고 별도 Qwen3-8B 인코더가 필요하다[2][10].
현재 CLM은 후보가 고정된 선택 문제를 빠르게 풀 수 있다는 매력적인 시스템 가설과 공개 체크포인트 출력의 재현성을 더 확인해야 한다는 현실을 함께 가진 초기 프로젝트다[4][5][10].
다음으로 필요한 증거는 더 높은 최고 점수보다 README와 playground 출력 차이를 설명하는 versioned checkpoint·입력 포맷·회귀 테스트다[2][4][5].
그 일치가 확인되고 다양한 후보 표현에서도 state-dependent ranking이 재현되면 실제 agent workflow에서 이 구조가 비용과 품질을 함께 개선하는지 판단하기 쉬워질 것이다[4][5][7].