scan-to-vector는 스캔 이미지에 보이지 않는 OCR 텍스트를 덧붙이는 대신, 글자를 다시 배치하고 선·도형·차트를 벡터로 그려 새 PDF를 만드는 Agent Skill이다.[1][2]
Claude Code와 Codex처럼 SKILL.md를 읽는 에이전트가 초안을 만들고 페이지별로 교정하는 흐름을 제공한다.[2][3]
낡은 문제집, 도해가 많은 매뉴얼, 다시 인쇄할 양식, 수치를 되찾고 싶은 차트에 어울린다.[2]
반대로 원본 모습을 그대로 두고 검색만 가능하게 만들고 싶다면, OCR 레이어를 추가하는 도구가 더 단순하고 빠르다.[2]
원클릭 변환기보다는 에이전트를 위한 재조판 작업 절차와 스크립트 묶음으로 보는 편이 정확하다.[3]
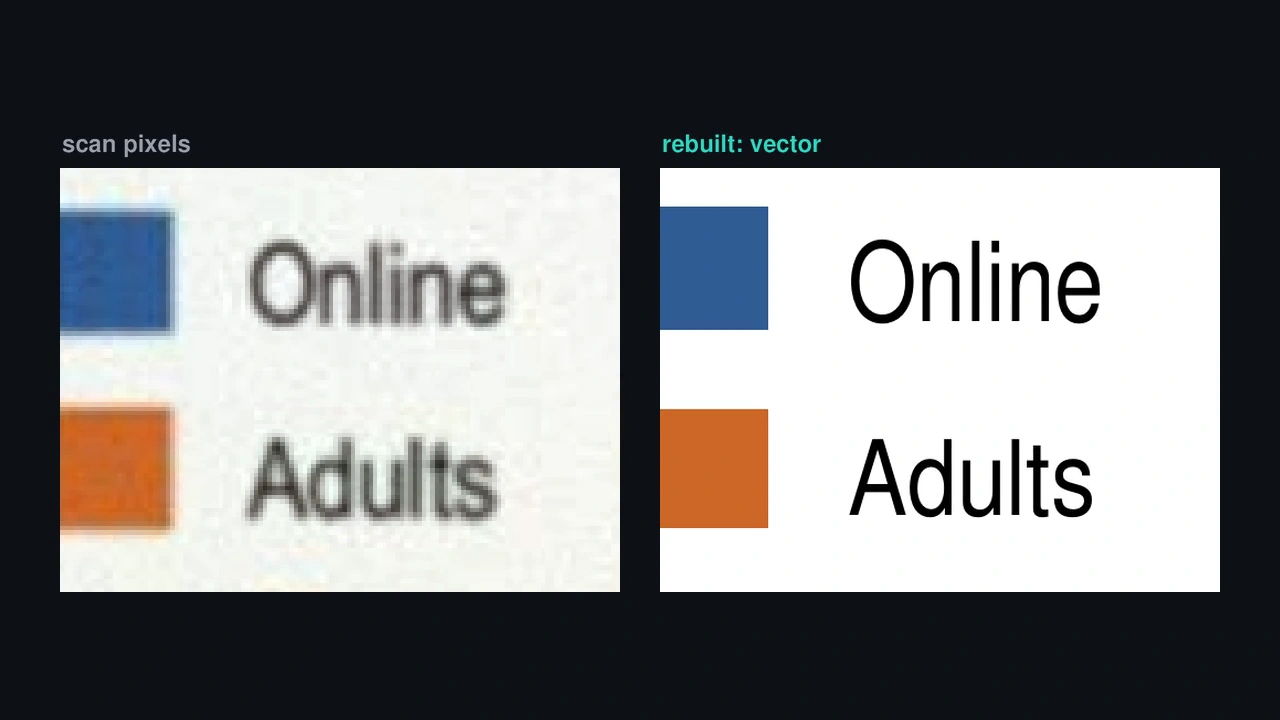
무엇을 다시 만드는가
결과물에는 검색·복사 가능한 실제 텍스트와 벡터 경로가 들어간다.[3]
선·상자·화살표·차트는 벡터로 재구성하고 사진·판화는 래스터로 남겨 보고한다.[3]
사진이 남으면 텍스트·벡터·이미지가 섞인 PDF가 된다.[2]
핵심은 초안 뒤의 교정 루프다.[3]
| 단계 | 확인할 산출물 |
|---|---|
| 초안 생성 | draft.py가 페이지를 보정하고 텍스트·도형을 배치한다.[3] |
| 글자 교정 | words.png에서 의심 글자를 확인하고 ID별로 fixes.json을 수정한다.[3] |
| 원본 대조 | diff.png와 report.md에서 누락·위치 차이를 확인한다.[3] |
| 재생성과 전달 | 다시 PDF를 만들고 불확실한 글자·남은 래스터를 함께 알린다.[3] |
대조 검사에서 PASS를 받아도 글자의 판독 정확성은 별도로 확인해야 한다.[2]
확대 이미지로 판독할 수 없는 글자를 추측하지 않고, 불확실한 부분을 기록하는 절차까지 포함한다.[3]
설치는 스킬과 실행 환경을 나눠 준비한다
확인한 공개 릴리스는 v1.0.0이다.[5]
Claude Code 안에서는 공식 안내대로 marketplace와 플러그인을 등록한다.[2]
/plugin marketplace add 3351666087/scan-to-vector-skill
/plugin install scan-to-vector@scan-to-vector-skill
Python 3.10 이상, PyMuPDF·Pillow·numpy·scipy, 그리고 별도 Tesseract 실행 파일이 필요하다.[2][7]
플러그인 등록과 이 의존성 준비는 별개다.[2]
저장소의 install.sh도 누락된 의존성을 알려 줄 뿐, Python 패키지와 Tesseract를 자동 설치하지 않는다.[4]
Codex는 저장소를 복제해 설치 스크립트를 먼저 읽고, 대상만 지정할 수 있다.[2][4]
git clone https://github.com/3351666087/scan-to-vector-skill.git
cd scan-to-vector-skill
./install.sh --codex
--claude, --codex, --dir DIR로 설치 대상을 고를 수 있으며, 지정하지 않으면 발견한 에이전트들에 설치한다.[4]
로컬 수정본은 기본적으로 덮어쓰지 않고, --force를 줄 때 백업 후 교체한다.[4]
Claude Code에서는 플러그인 설치와 개인 스킬 복사본을 중복으로 두지 않는 편이 좋다.[2]
공식 안내는 macOS·Linux 설치 예시를 제공한다.[2]
Windows 네이티브 설치·검증 경로는 이번에 확인한 자료에서 찾지 못했다.
작은 페이지 하나로 시작하기
에이전트에는 먼저 다음처럼 범위를 좁혀 요청하는 편이 좋다.
원본 보존과 불확실성 보고를 함께 요구하는 예시다.[3]
scan-to-vector로 page1.jpg를 검색 가능한 PDF로 다시 조판해 줘.
선과 도형은 벡터로 만들고 사진은 그대로 남겨 줘.
원본과 대조한 뒤 불확실한 글자와 남은 래스터 영역을 알려 줘.
저장소 루트와 필요한 패키지를 갖춘 Python 환경에서는 다음 스크립트 흐름을 사용할 수 있다.[2][10]
S=skills/scan-to-vector/scripts
python "$S/draft.py" page1.jpg --out work --pdf out/rebuilt.pdf
# work/p01/fixes.json 등을 교정한 뒤
python "$S/draft.py" --rebuild work --pdf out/rebuilt.pdf
위 직접 실행 예시는 페이지 이미지 입력 기준이다.[10]
영수증·책처럼 표준 용지 비율이 아닌 문서는 --paper none을 검토하고, 장기 작업은 페이지 ledger와 checkpoint를 남겨 이어간다.[3]
원본의 위치와 비율을 다시 만드는 작업이므로, 초안이 그럴듯해 보여도 교정과 대조를 생략하지 않는 것이 중요하다.
도입 전에 확인할 점
- 한국어 검증은 별도다. 기본 OCR은 영어이고, 현재
main의 가로쓰기 간체자 지원은 실험적이다.[2] 세로쓰기는 지원하지 않고 다른 언어는 미검증이라고 안내하므로, 언어팩만 추가하면 한국어 재조판까지 완성된다고 기대해서는 안 된다.[2] - 벤치마크 범위를 좁혀 읽는다. 공개 장문 비교는 합성 영문 18페이지를 두 개의 9페이지 문서로 묶은 실험이다.[2][9] 보고된 점수는 텍스트·레이아웃·도형·벡터 비율을 합친 지표이며, 실제 책 전체나 한국어 문서의 무오류 복원율이 아니다.[8]
- 검수 비용이 남는다. 페이지별 모델 시간과 사람 확인이 필요한 워크플로다.[2][3] 로컬 OCR·PDF 처리와 별개로, 선택한 AI 서비스에 원본이나 교정 이미지가 전달되는지 확인해야 한다.
- MIT가 원본 문서의 권리까지 주지는 않는다. 코드·문서는 MIT, 공개 데모 스캔은 퍼블릭 도메인, 번들 글꼴은 별도 SIL OFL이다.[2][6] 실제 책·도면을 재조판하거나 결과를 배포할 권리는 따로 확인해야 한다.
단순 검색용 OCR보다 페이지를 다시 인쇄하고 도표를 선명하게 살려야 할 때 검토할 만하다.
처음에는 비민감·권리 확인된 짧은 문서로 글자 누락, 비율, 표 구조를 확인하고, 그 교정 비용까지 감당할 수 있을 때 범위를 넓히는 사용법을 권한다.
Sources
[1] https://github.com/3351666087/scan-to-vector-skill
[2] https://raw.githubusercontent.com/3351666087/scan-to-vector-skill/main/README.md
[4] https://raw.githubusercontent.com/3351666087/scan-to-vector-skill/main/install.sh
[5] https://github.com/3351666087/scan-to-vector-skill/releases/tag/v1.0.0
[6] https://raw.githubusercontent.com/3351666087/scan-to-vector-skill/main/LICENSE
[8] https://raw.githubusercontent.com/3351666087/scan-to-vector-skill/main/bench/score.py