여러 에이전트 메모리 시스템은 사실 추출, 요약, 그래프, 메모리 갱신으로 오래된 대화를 관리한다.[2]
Raw-RAG는 그 전에 확인할 질문을 제시한다.
원문을 충분히 잘 검색해 주는 기준선보다 실제로 나아졌는가?
2026년 10월 공개된 논문 Is Complex Agentic Memory Always Needed?
Naive RAG Is Stronger Than We Thought의 출발점이다.[1]
저자들은 원문 대화에 임베딩 검색과 리랭킹을 적용한 기준선을 만들었다.[2]
이 방식은 주요 4개 벤치마크의 7개 벤치마크–리더 모델 조합 중 6개에서 비교 대상 메모리 시스템보다 높은 종합 점수를 기록했다.[2]
단, Full-context는 이 순위에서 제외하며 모든 과제나 모든 서비스 환경에서 이겼다는 뜻은 아니다.[2]
이 글의 핵심 해석은 간단하다.
메모리의 복잡성보다 먼저, 답에 필요한 원문과 관계가 리더 모델까지 전달되는지 확인하자.
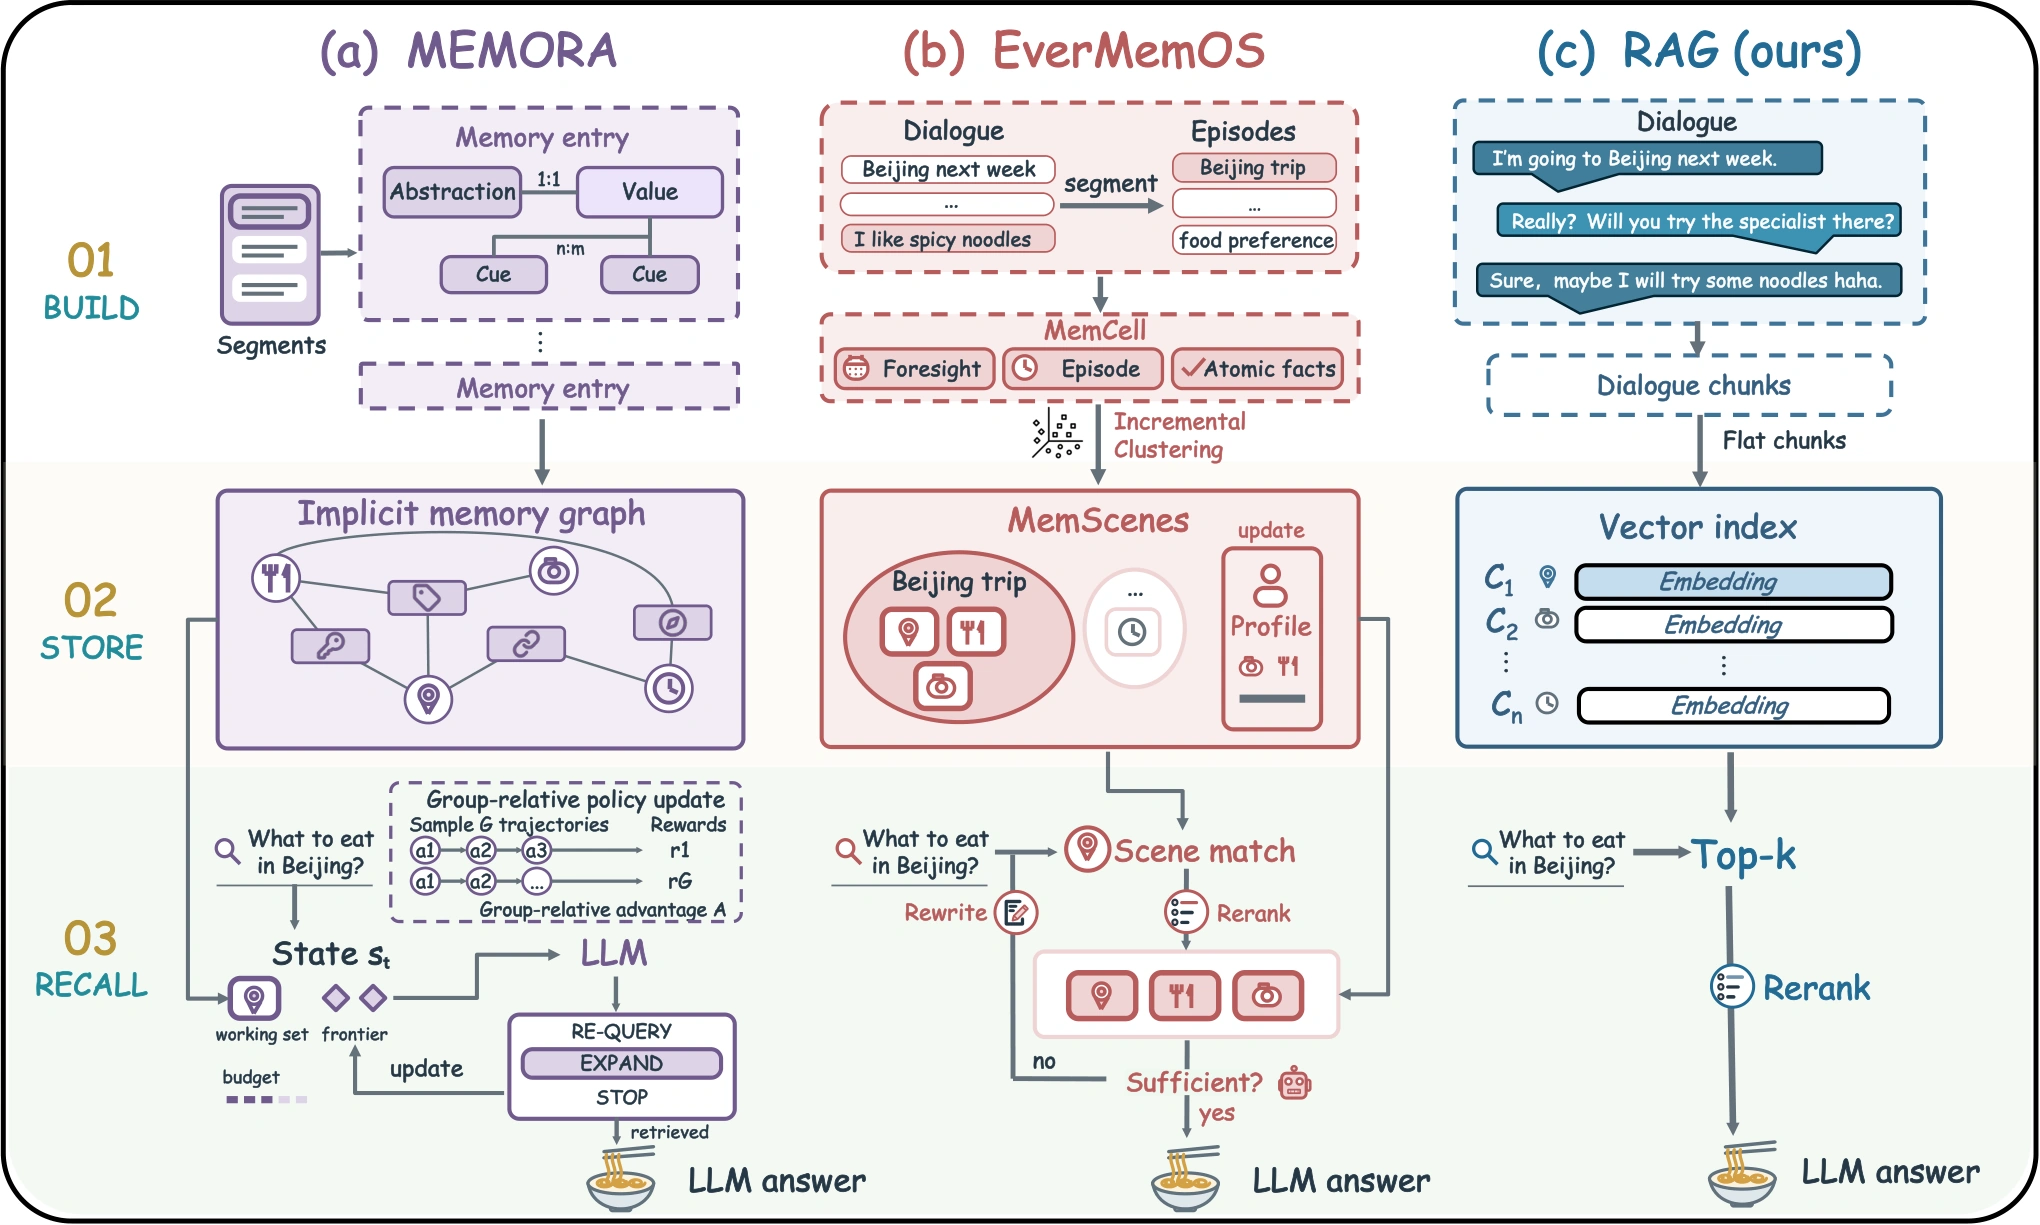
원문을 보존하고, 해석은 읽는 시점으로 미룬다
Raw-RAG의 기본 절차는 다음과 같다.[2]
- 발화자·시간·제공된 이미지 캡션을 포함해 대화를 직렬화한다.[2]
- 원문을 256토큰, 겹침 32토큰의 창으로 나눠 임베딩한다.[2]
- 질문과 코사인 유사도가 높은 128개 후보를 검색한다.[2]
- 크로스 인코더 리랭커로 15개를 선택하고, 리더 LLM이 이를 읽어 답한다.[2]
저장할 때 LLM으로 사실을 추출하거나 요약·그래프·상태 갱신을 수행하지 않는다는 점이 차이다.[2]
그렇다고 모델 호출이 없는 것은 아니다.
임베딩과 리랭커를 쓰고, 최종 답변에는 LLM을 사용한다.[2]
공개 평가 프로필의 기본 조합은 text-embedding-3-small과 Cohere Rerank-v3.5다.[4]
별도 비교 조건에는 Qwen3-Embedding-4B와 Qwen3-Reranker-4B도 있다.[4]
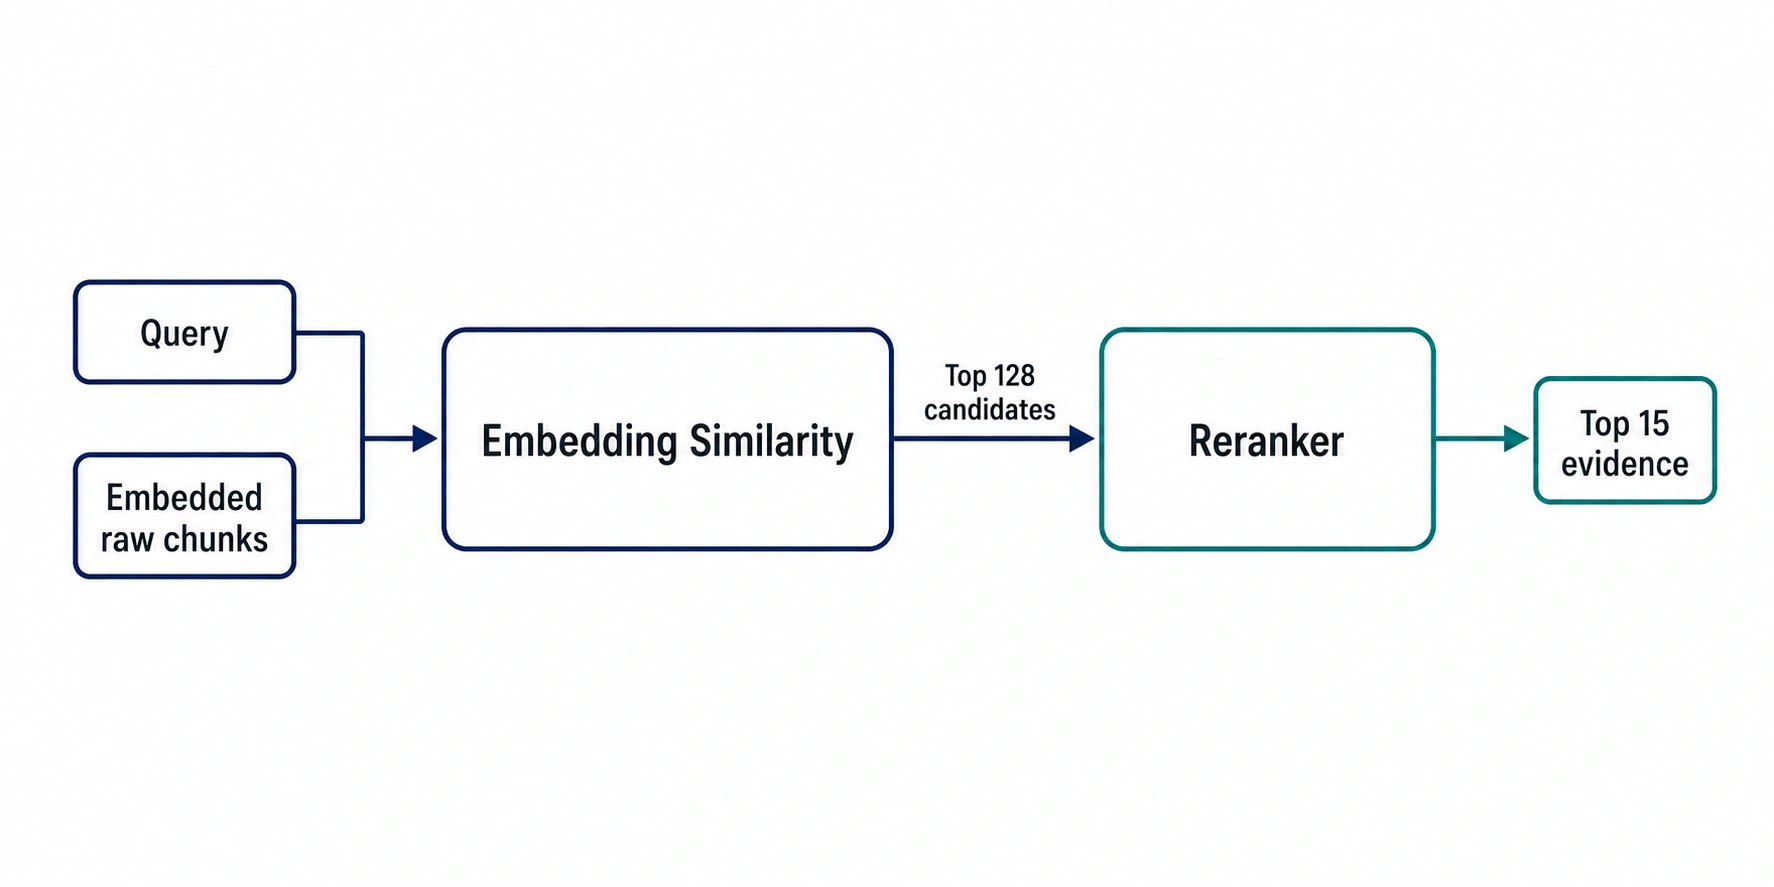
15개 청크가 곧 고정된 입력 토큰 예산은 아니다.[2]
LoCoMo와 LongMemEval 등에서는 선택한 창을 원래의 온전한 발화로 확장해 보여준다.[2]
기본 실행에서 리더에게 공급한 근거는 LongMemEval 평균 약 1.14만 토큰, MEME 평균 약 1.20만 토큰이다.[2]
추가로 6개 시스템의 근거를 5,000토큰으로 제한한 MemoryAgentBench 실험에서도 Raw-RAG는 48.32%, 비교군 최고는 44.74%였다.[2]
다만 이 통제의 Mem0·MemOS는 본문과 다른 이전 hosted-service 설정이며, 각 시스템을 새 예산에 맞춰 재튜닝한 비교는 아니다.[2]
벤치마크별 처리도 있다.
MEME에서는 선택 근거를 시간순으로 제시하고, MemoryAgentBench에서는 발화 확장을 끈다.[5]
FactConsolidation 과제의 개별 사실은 원자적 단위로 유지한다.[5]
따라서 모든 데이터에 아무 전처리 없이 똑같은 청킹만 적용한 실험으로 읽으면 안 된다.[4]
6승 1패라는 결과를 어떻게 읽어야 할까
아래는 논문 본문 주요 결과표의 종합 점수다.
비교군 최고는 Raw-RAG와 Full-context를 제외한 메모리 시스템 중 최고값이다.[2]
LoCoMo·LongMemEval은 질문 단위 정확도, MEME는 6개 과제 매크로 평균, MemoryAgentBench는 4개 능력 점수의 평균이므로 행 사이를 같은 분모의 정확도로 비교하지 않는다.[2]
| 평가 / 리더 | Raw-RAG | 비교군 최고 |
|---|---|---|
| LoCoMo GPT-4o-mini | 89.07 | 88.12 MemMachine |
| LoCoMo GPT-4.1-mini | 93.70 | 93.05 EverMemOS |
| LongMemEval GPT-4.1-mini | 87.53 | 87.40 Memora |
| MEME GPT-4o-mini | 39.30 | 37.06 MemMachine |
| MEME DeepSeek-V4-Flash | 43.19 | 44.71 MemMachine |
| MemoryAgent Bench GPT-4o-mini | 48.32 | 43.84 Memora |
| MemoryAgent Bench DeepSeek-V4-Flash | 53.41 | 47.88 Memora |
작은 차이와 큰 차이를 구분할 필요가 있다.
LongMemEval의 선두 차이는 0.13%p인 반면 MemoryAgentBench에서는 차이가 더 크다.[2]
예외인 DeepSeek-V4-Flash의 MEME에서는 MemMachine이 앞서며, 같은 조건의 Full-context는 63.17%로 Raw-RAG보다 높다.[2]
비교의 출처도 하나로 뭉뚱그리면 안 된다.
LoCoMo·LongMemEval은 저자들의 직접 평가와 기존 연구의 발표 수치가 함께 들어가며, 부록에서 임베딩·리랭커·판정 방식·질문 집합을 맞춘 비교를 따로 제시한다.[2]
모든 시스템을 단일 구성으로 새로 실행한 통제 실험이라고 소개할 결과는 아니다.[2]
더 많이 찾는 것보다 적절하게 찾는 것이 중요하다
MemoryAgentBench에서 리랭커를 빼면 종합 점수는 48.32 → 44.40으로 내려갔다.[2]
최종 근거를 1개만 주거나 120개까지 늘리는 조건도 기본값보다 나빴다.[2]
반면 청크 크기를 128~1,024토큰으로 바꾸는 실험에서는 종합 점수의 유의한 변화가 확인되지 않았다.[2]
이 결과는 “256토큰과 top-15가 보편적 정답”이라는 뜻보다는, 리랭킹과 적당한 검색 폭을 갖춘 기준선이 필요하다는 근거에 가깝다.[2]
기억을 가공하는 세 가지 추가 실험도 흥미롭다.
같은 MemoryAgentBench에서 원자적 사실 추출은 종합 28.70, 원문에 요약을 더하는 방식은 42.51, 그래프 기반 검색 확장은 42.54로 기본값보다 낮았다.[2]
특히 사실 추출을 붙였을 때 Test-Time Learning 점수는 47.68 → 15.37로 떨어졌다.[2]
다만 이를 전부 사실 삭제의 탓으로 단정할 수는 없다.
저자들도 예시와 정답 라벨의 짝, 예시 경계, 표현 형식, 공급 토큰량이 함께 달라진다고 설명한다.[2]
이 실험이 보여주는 것은 해당 표현 방식과 리더의 조합이 좋지 않았다는 사실이다.[2]
답의 값만 남기면, 답을 도출하는 길이 사라질 수 있다
논문은 검색을 두 층으로 나눈다.
Coverage는 답에 필요한 근거가 있는 비율, utilization은 근거가 있다고 판정된 질문에서의 답변 정확도다.[2]
Raw-RAG는 조사한 두 벤치마크에서 coverage가 가장 높았지만 utilization까지 항상 최고인 것은 아니었다.[2]
예를 들어 MemoryAgentBench의 근거 coverage는 45.29%였다.[2]
이 수치는 최종 종합 점수 48.32%와 다른 지표다.[2]
이 coverage는 정답 문자열 주변을 모은 최대 9,000자 발췌문을 별도 LLM이 판정한 지표다.[2]
반면 MEME의 주 coverage 표는 과제별 결정적 검사를 사용하므로 두 벤치마크의 판정법도 동일하지 않다.[2]
시스템별로 충분한 근거가 있는 질문 집합도 달라 utilization만으로 리더의 우열을 통제해 비교할 수 없다.[2]
더 중요한 구분은 결과값과 추론 경로다.[2]
시간에 따라 값이 바뀌거나 다른 조건에 의존한다면 값만 검색해서는 부족하다.[2]
언제 바뀌었는지, 어떤 규칙과 앞선 변화가 연결되는지도 필요하다.[2]
MEME의 tracking·cascade 사후 질문에서 전체 검색 문맥을 별도 LLM으로 판정했을 때, 결과값을 찾은 경우에 완전한 경로도 보존한 비율은 Raw-RAG가 62.34%였다.[2]
저자들은 질문 시점 가시성 규칙을 적용한 저장 메모리를 대상으로 정답 정보를 활용해 근거를 골라 주는 complete-store oracle도 조사했다.[2]
아래 그림의 진한 막대는 일반 검색 성능이 아니라 이 진단 조건의 결과다.[2]
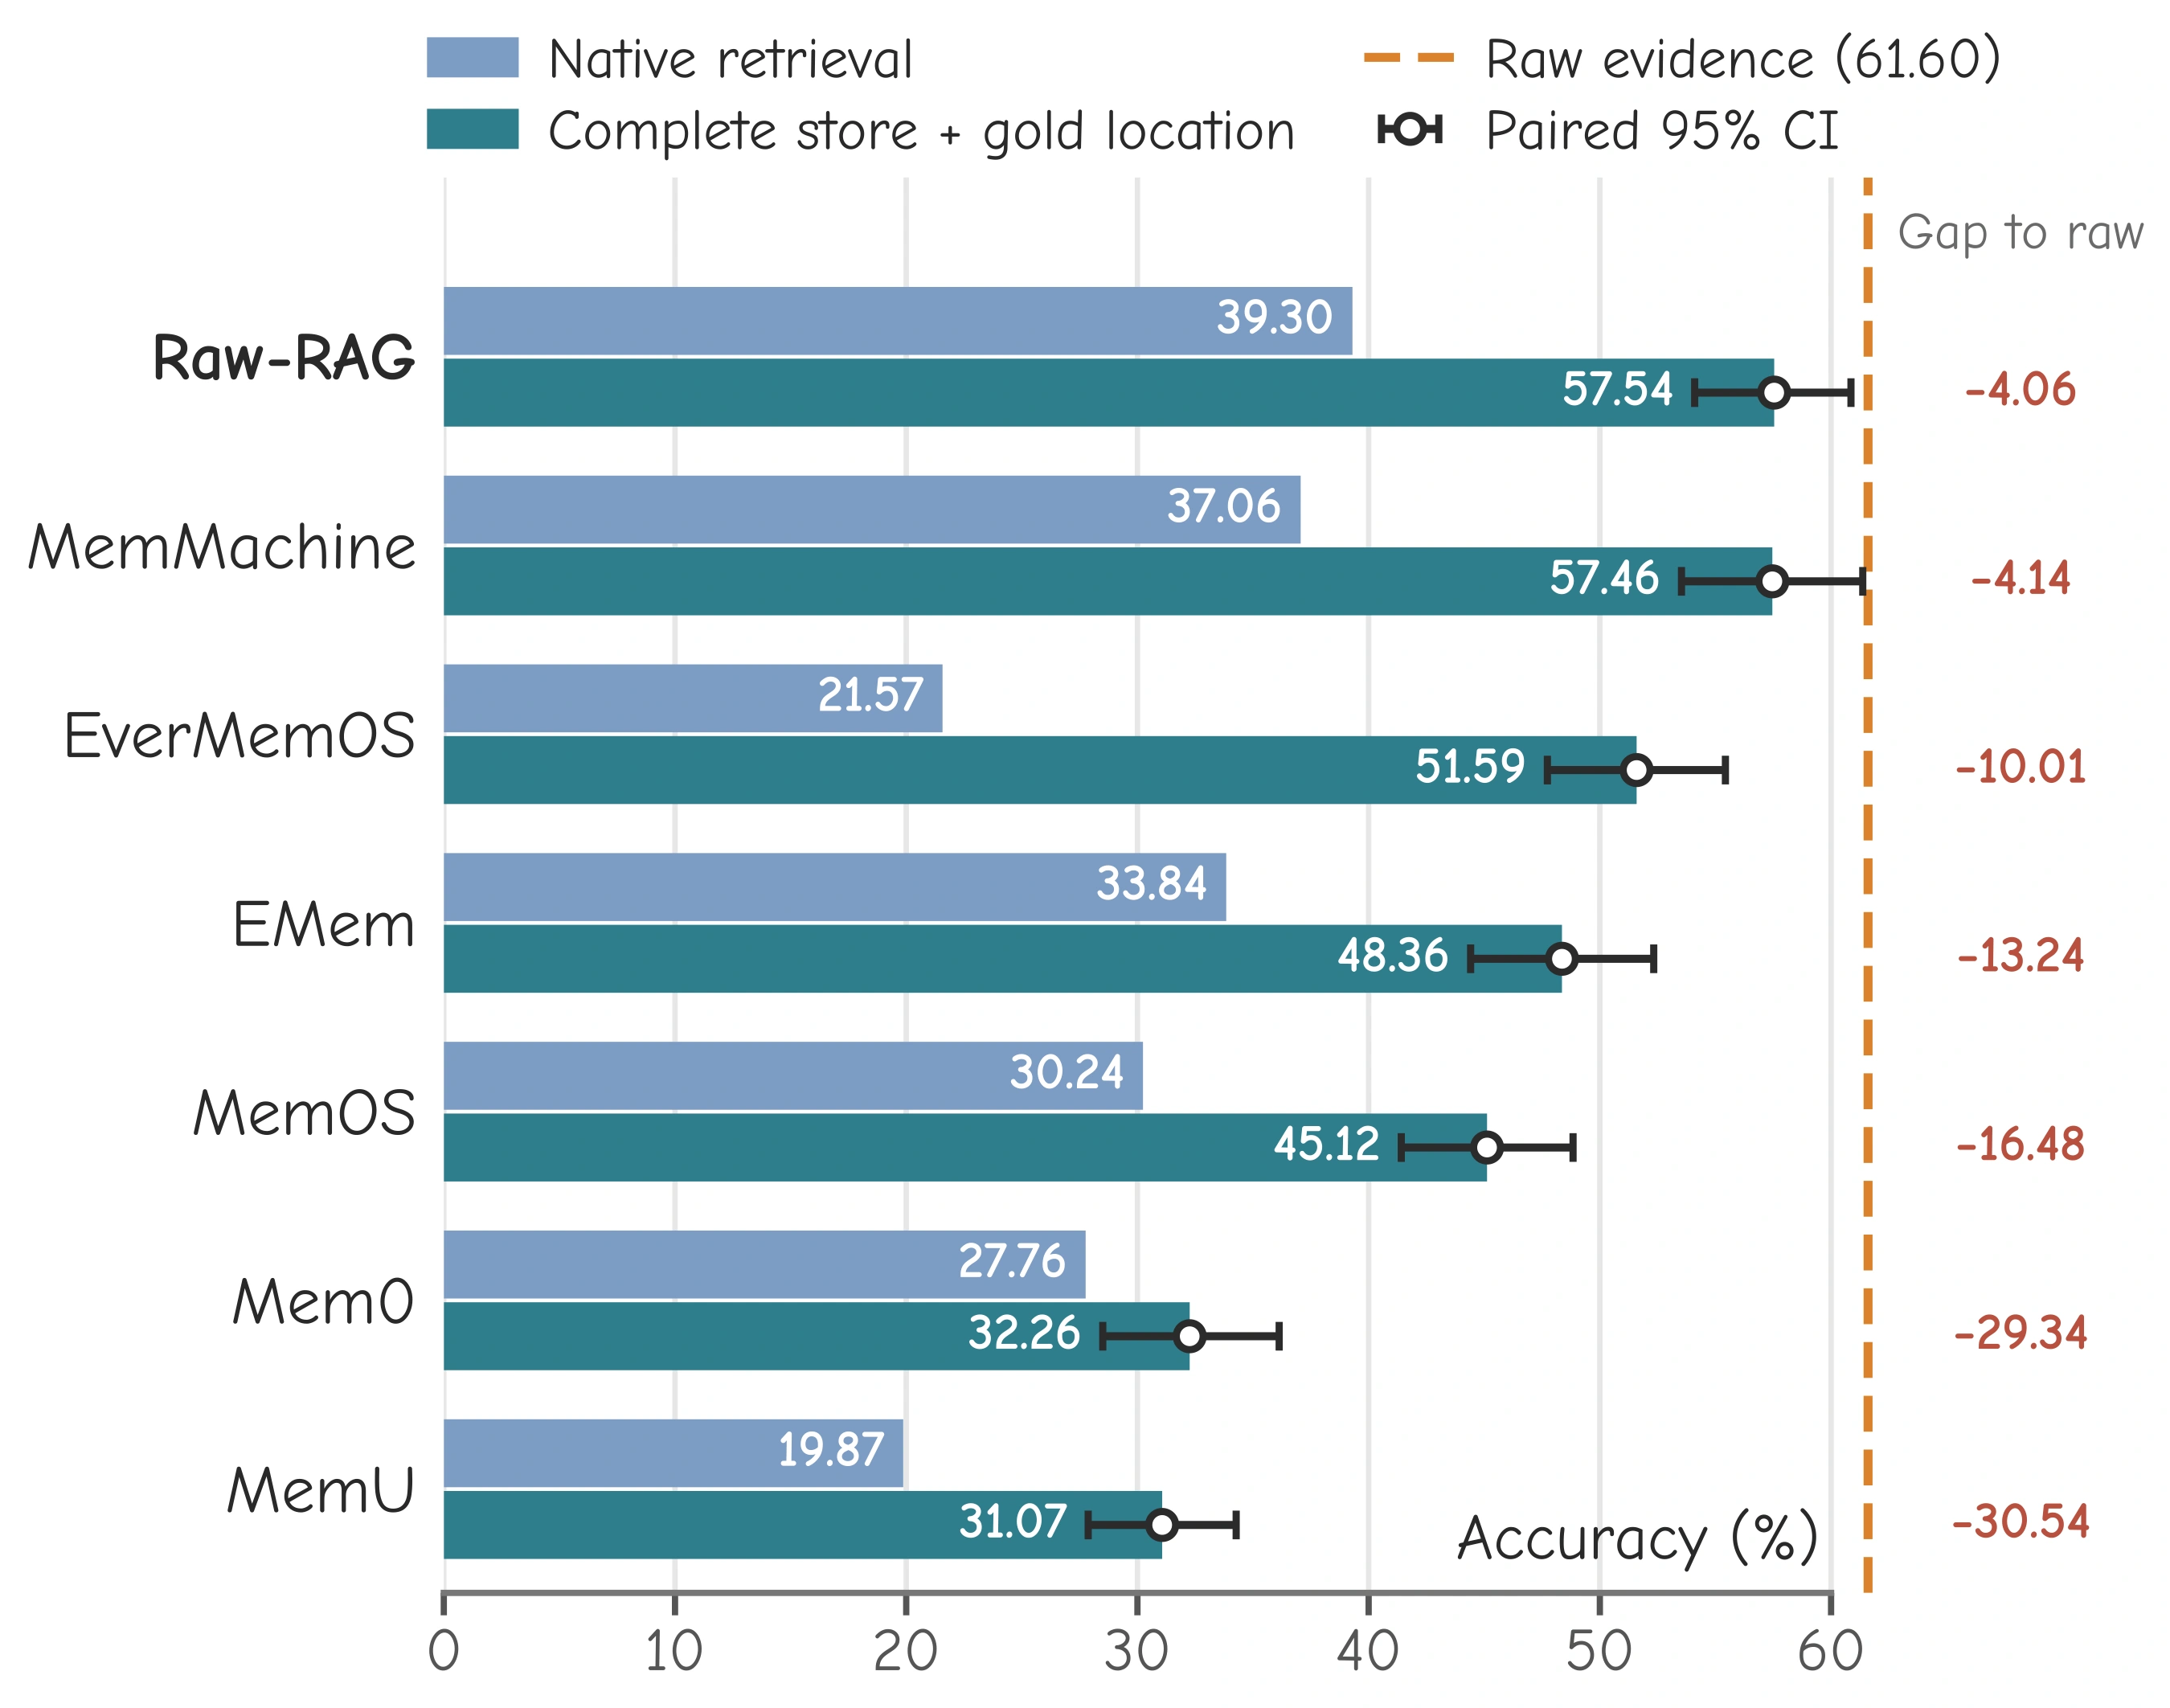
이 대조에서는 저장 메모리와 원문 근거 양쪽에 근거·과제별 읽기 지침을 합쳐 명목 5,000토큰의 예산을 적용했다.[2]
Raw-RAG는 57.54%, MemMachine은 57.46%, 원문 근거 대조군은 61.60%였다.[2]
원문을 보존하는 방식이 대조군에 더 가까워진 점은 중요하다.
하지만 남은 격차를 전부 저장 단계의 정보 손실로 계산할 수는 없다.[2]
근거를 조립하는 방식이나 위치 효과도 영향을 주며, Raw-RAG 자체에도 차이가 남는다.[2]
또한 oracle과 일반 검색은 근거 선택뿐 아니라 읽기 조건도 달라 순수한 검색 개선량으로 해석하면 안 된다.[2]
여기서 “전체”는 외부로 내보낸 저장 표현의 범위이며, 모든 원문이나 삭제 이력을 뜻하지 않는다.[2]
EMem의 실제 시점별 스냅샷을 제외하면 주로 최종 저장소를 메타데이터로 시간 필터링한다.[2]
덮어쓰기·삭제로 사라진 객체는 되살릴 수 없고 후속 수정이 남을 수도 있어 완벽한 과거 상태 복원 실험도 아니다.[2]
비용과 운영 제약은 따로 보아야 한다
효율성은 답변 생성 속도와 구분해야 한다.
저자들의 MEME 일부 구간 실험에서 Raw-RAG의 저장 준비 완료까지의 시간 + 검색 시간은 305.91초였다.[2]
이 측정은 10개 대화·110개 질문에서 수행했고, 답변 생성과 평가 시간은 제외했다.[2]
API 지연과 시스템별 내부 병렬성도 포함된 배포 조건의 수치다.[2]
따라서 다음 한계도 함께 읽어야 한다.
- 개인화에서는 선두가 아니다.[2]
부록의 PersonaMem-v2 5,000문항 평가에서 Raw-RAG는 49.62%로 7개 시스템 중 3위였다.[2]
Raw-RAG는 프로필을 쓰지 않고 일부 비교 시스템은 사용하므로 프로필 효과만 분리한 실험도 아니다.[2]
- 답변에서 잊는 것과 저장소에서 지우는 것은 다르다.[2]
MEME의 deletion은 삭제된 값을 답에 노출하지 않는지를 평가한다.[2]
원문·인덱스·백업에서 실제 정보를 소거했는지는 이 점수로 보장하지 않는다.[2]
- 원문 보존에도 비용이 있다.[2]
기록이 늘면 저장량이 증가하고, 고정 검색 예산은 분산된 근거를 놓칠 수 있다.[2]
개인정보 보관과 삭제 요구도 별도 설계가 필요하다.[2]
- 오프라인 대화 평가의 결과다.[2]
실제 상호작용, 행동을 실행하는 도구, 더 넓은 멀티모달 환경까지 입증한 것은 아니다.[2]
약한 리더 모델에 상태를 매번 재구성시키는 비용도 남는 문제다.[2]
공개 코드에서 확인할 수 있는 것
공식 Litmeb/RAW-RAG 저장소에는 평가 코드와 논문 조건별 실행 프로필이 공개되어 있다.[3][4]
확인한 커밋은 95639191e9547219b426710e50fe1a36235e26fc이며, 코드 라이선스는 MIT다.[6]
논문 프로필은 기본 검색 설정뿐 아니라 재사용하는 검색 결과, judge 모델, 반복 판정, 무응답 문항을 제외한 별도 집계까지 구분한다.[4]
실행에는 Python 환경과 데이터 준비 외에 PowerShell 7, 임베딩·리랭킹·리더·판정 서비스 설정이 필요하다.[4]
저장소를 받는 것만으로 무료·로컬 재현이 끝나는 구조는 아니다.[4]
이 글은 논문과 공개 코드·설정을 검토한 정리다.
모델 API를 호출해 벤치마크를 독립 재현한 결과는 아니다.
정리
Raw-RAG를 “메모리 프레임워크는 필요 없다”는 결론으로 읽기는 어렵다.
오히려 설계 순서를 점검하게 한다.
먼저 강한 원문 검색 기준선을 만들고, 근거의 도달 여부와 시간·의존 관계 보존을 측정한 뒤, 요약이나 그래프가 어떤 과제에서 실제로 이득을 주는지 확인하자는 것이다.[2]
원문이 사라지면 검색기는 되찾아 줄 수 없다.
그러나 원문을 보관했다고 필요한 관계까지 자동으로 검색되는 것도 아니다.
Raw-RAG의 가치는 이 두 문제를 분리해서 보게 하는 데 있다.